


Z.ai представила GLM-5.2 — открытая 753b-модель с контекстом в 1 миллион токенов обходит Fable 5 на Design Arena

Введение
Китайский ИИ-стартап Z.ai наконец-то открыл исходный код своей флагманской ИИ-модели GLM-5.2, вышедшей в облако и API компании неделей ранее. GLM-5.2 имеет колоссальные 753 миллиардов общих и 98 миллиардов активных параметров, которая не только превосходит конкурентов с открытым исходным кодом в большинстве ключевых бенчмарков, но и смогла обойти даже нашумевшую нейронку Claude Fable 5 на Design Arena, что говорит о высочайшей ИИ-производительности китайской LLM.
Подробнее о GLM-5.2
Модель GLM-5.2 базируется на архитектуре Mixture of Experts с 753 миллиардами общих параметров, из которых активны около 98 миллиардов. Модель имеет огромное сплошное контекстное окно в 1 миллион токенов — без деления на чанки и с гарантированной стабильностью внимания на всей дистанции. Это позволяет использовать GLM-5.2 для наиболее сложных и объемных задач, вроде обработки целых кодовых баз или анализа объемных баз данных. Нарастить такой контекст стало возможно благодаря механизму IndexShare, представляющему из себя один индексатор (компонент разряженного внимания), который обслуживает каждые четыре разреженных слоя внимания, что по сравнению с предыдущим поколением моделей GLM-5.1, снижает количество операций обработки одного токена в 2,9 раз при максимальной длине контекста. Иными словами, обработка миллиона токенов перестает быть какой-то дорогой и сложной опцией, а превращается в штатную функцию, которую не просто можно, а нужно использовать для задач кодинга.
Еще одно важное обновление GLM-5.2 — улучшенный слой Multi‑Token Prediction для спекулятивного декодирования, который увеличивает допустимую длину генерируемого блока ответа на 20% относительно GLM-5.1 что напрямую ускоряет инференс в многошаговых агентных задачах и длительных сессиях программирования, не требуя дополнительных аппаратных ресурсов от юзера. Z.ai предлагает два режима использования GLM-5.2 в задачах кодирования с гибким распределением усилий: первый (Max) оптимизирован для максимальной точности, а второй (High) — для снижения задержки при сохранении высокой точности, что позволяет разработчикам удобно выбирать баланс скороси/производительности нейронки под свои сценарии. Для облегченного развертывания доступна FP8-версия (для развертывания нужно 754 ГБ памяти), значительно уменьшающая требования к инфраструктуре и вычислительным ресурсам без критической потери качества, а для любителей полных весов есть версия в BF16, позволяющая дообучать и экспериментировать с моделью, но требующая огромного пула память (1,5 ТБ памяти).
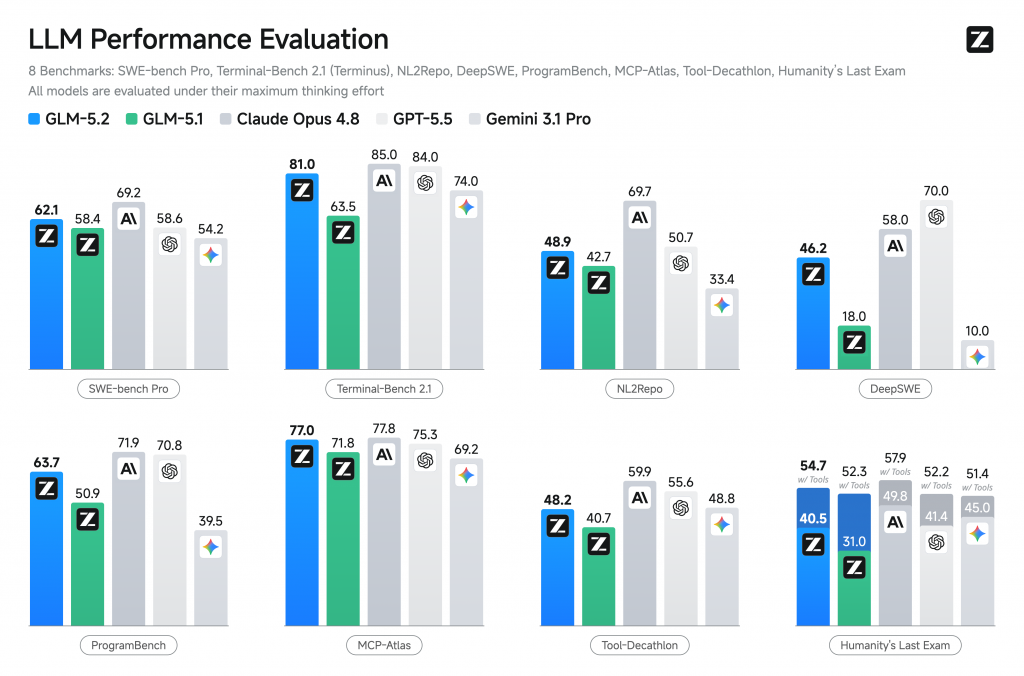
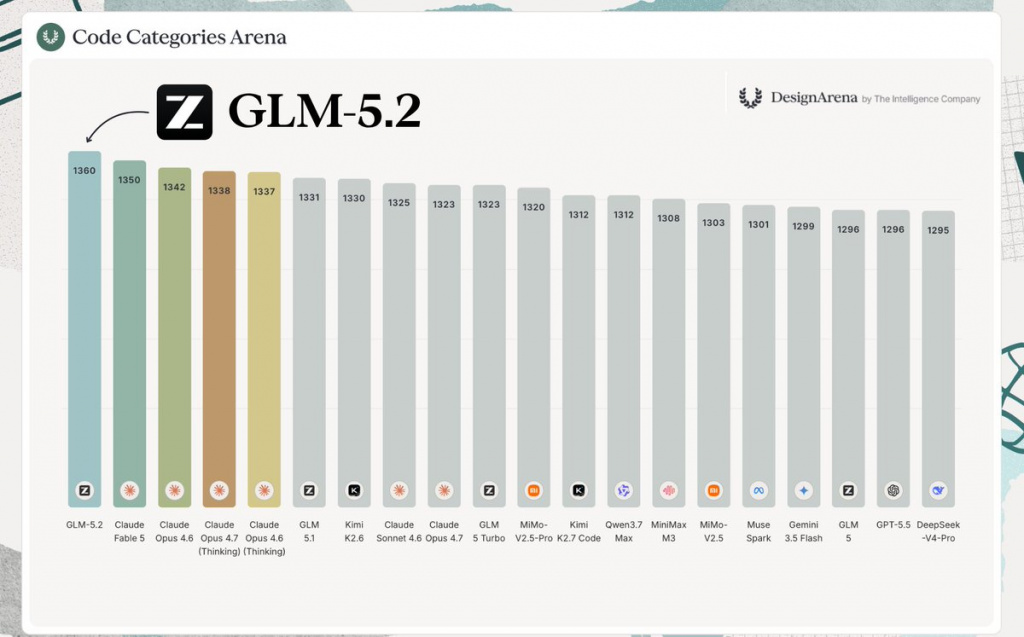
На Design Arena модель GLM‑5.2 получила 1360 очков Elo, обойдя Claude Fable 5 с 1350 очками, что вызвало огромный ажиотаж в ИИ-сообществе, ведь до этого буквально во всех ИИ-бенчмарках лидировала флагманская, но ныне отключенная нейросеть Anthropic. В длинных инженерных тестах модель показывает 74,4% на FrontierSWE — второе место после Opus 4.8 (75,1%) и выше GPT‑5.5 и Opus 4.7. Terminal‑Bench 2.1 пройден с результатом 81,0%, что на 17,5 процентных пункта выше GLM‑5.1 (63,5%) и лишь на 4 пункта ниже Opus 4.8 (85,0%). SWE‑bench Pro сдан на 62,1% против 58,4% у предшественницы и 69,2% у Opus 4.8. На PostTrainBench и SWE‑Marathon модель стабильно вторая среди всех протестированных систем, оставаясь лучшей открытой моделью. Разработчики позиционируют GLM‑5.2 ровно между Opus 4.7 и Opus 4.8 по качеству при сопоставимом расходе токенов.
Модель GLM-5.2 поставляется под полностью открытой лицензией MIT, веса доступны на Hugging Face.
Выводы
GLM‑5.2 впервые в истории открытых моделей забирает верхнюю строку престижного рейтинга Design Arena, обходя даже такие закрытые флагманы. Показательно, что релиз состоялся в момент, когда сильнейшую закрытую кодинг-модель Fable 5 ограничили по экспортным причинам, и ее место на вершине арены тут же заняла модель с открытым исходным кодом, доступная любому исследователю или компании без территориальных барьеров. Это меняет расстановку сил в индустрии: теперь корпоративные пользователи могут получить качество, близкое к лидирующим коммерческим API, но с полным контролем над инфраструктурой и без лицензионных отчислений. Тем не менее, по ряду задач (полный спектр SWE-bench и NL2Repo) разрыв с Opus 4.8 сохраняется, и полностью догнать закрытый фронтир GLM-5.2 пока не удалось.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год