


Tesla P100 в современных задачах LLM инференса

Введение: ознакомление с NVIDIA Tesla P100
Совсем недавно мы разглядывали NVIDIA Tesla P40 и оценивали её возможности в текущих реалиях. Сегодня же перед нами предстала “старшая сестра” этого неоднозначного ускорителя. Давайте разберёмся в чем между ними различия и на сколько старшая модель опережает (если опережает) Tesla P40.
NVIDIA Tesla P100 увидела свет в тот же отрезок времени что и Tesla P40, на базе той же архитектуры Pascal, но их позиционирование серьёзно разнилось. Если P40 продвигалась сугубо как инструмент инференса нейросетей, то старший ускоритель был более многофункционален и мог использоваться как для обучения, и инференса, так и для работы с низкоразрядными форматами.
P100 преподносилась NVIDIA как старший многофункциональный суперкомпьютерный ускоритель в линейке Тесел на поколении Pascal. Именно поэтому её снабдили полным арсеналом технологий которым владела компания в период выпуска этого поколения.
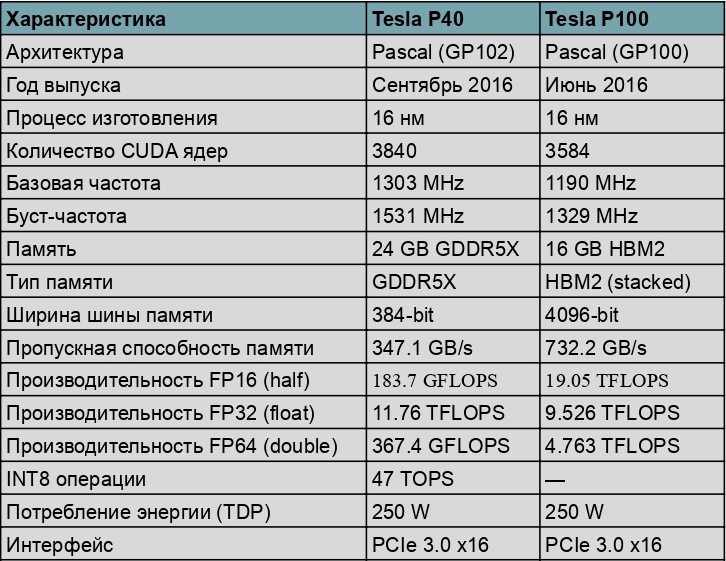
И именно благодаря тому что NVIDIA снабдила её полноценной, а не урезанной поддержкой (как на P40) формата FP16, её производительность в нём составляет аж 21.2 TFLOPS. Это вдвое больше, чем её же производительность в формате FP32, и в колоссальных 115 раз быстрее чем её младшая сестра в том же формате FP16. Однако это не единственный козырь в рукаве старшего ускорителя.
Характеристики NVIDIA Tesla P100
Второе явное достоинство P100 – неимоверно быстрая видеопамять HBM2. Помимо впечатляющей шины в 4096 бит, она также обладает и невероятной пропускной способностью 732 Гб/с. Именно высокоскоростная память является краеугольным преимуществом этого видеоускорителя.
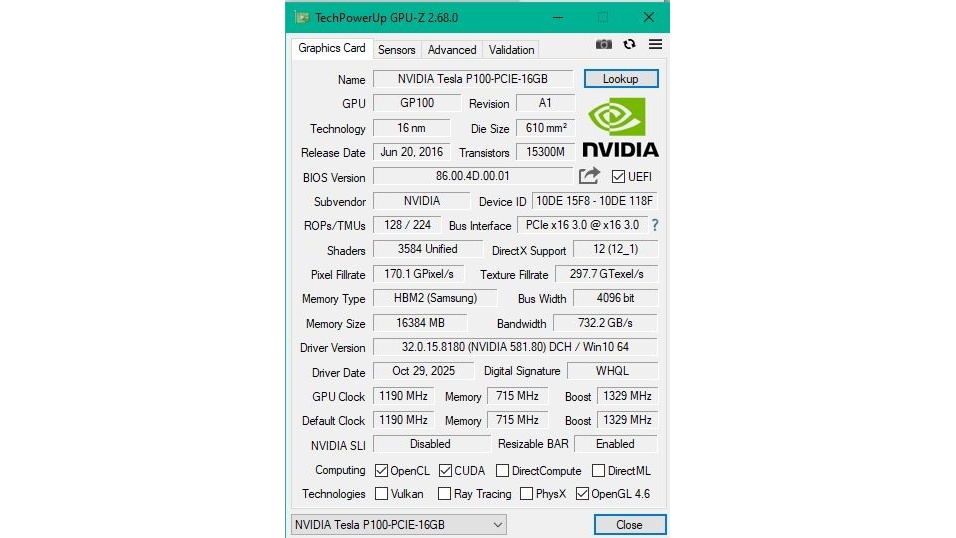
Установка NVIDIA Tesla P100 в систему и настройка в Windows
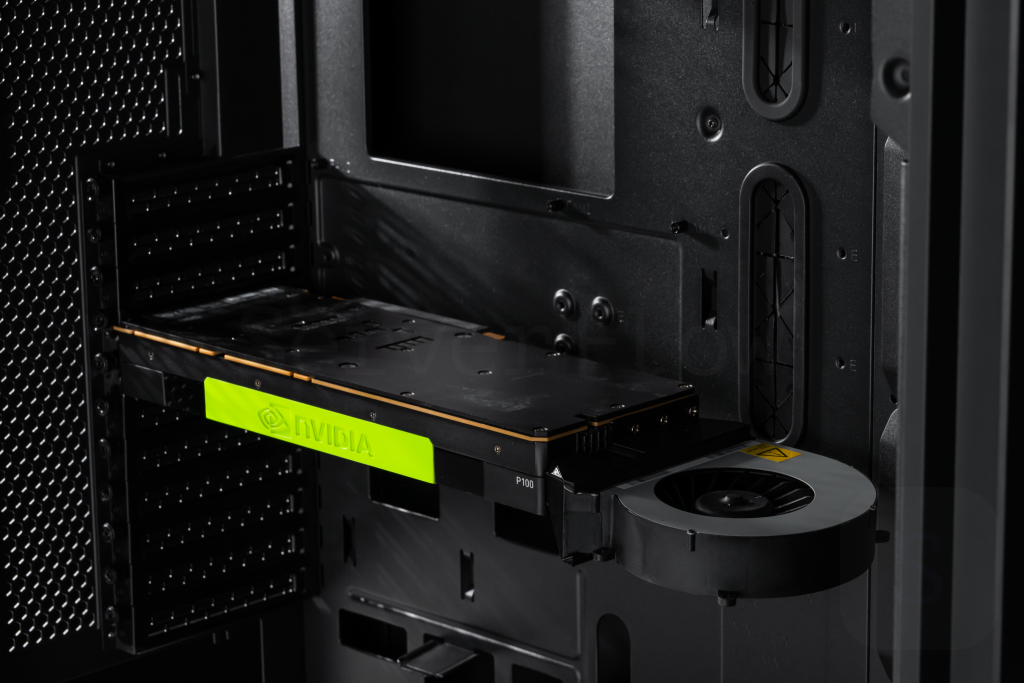
Для функционирования P100 необходим 8-контактный разъём питания формата EPS и блок питания от 650W, а если вы используете отдельную видеокарту для вывода изображения то от 800W.
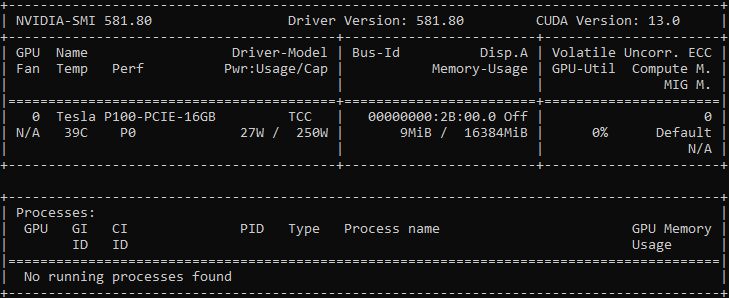
После установки накатываем свежевышедшие драйвера и убеждаемся в их корректной установке.
Тест NVIDIA Tesla P100 в LM Studio
| # | Модель | Квантизация | Скорость | До первого токена | Длина контекста | Примечания |
|---|---|---|---|---|---|---|
| 1 | deepseek-r1-0528-qwen3-8b | Q4_K_M | 36.45 т/сек | 1.50 сек | 4096 | Даёт короткие, но верные ответы |
| 2 | Meta-Llama-3.1-8B-Instruct* | Q4_K_M | 38.34 т/сек | 1.50 сек | 4096 | Немногословна, но даёт только верные ответы |
| 3 | OpenAI’s gpt-oss 20B | Q4_K_M | 63.02 т/сек Лучшая | 0.17 сек Рекорд | 4096 | Лучшая нейросетевая модель, самые подробные и быстрые ответы |
| 4 | DeepSeek-R1-Distill-Llama-8B* | Q4_K_S | 40.35 т/сек | 0.25 сек | 4096 | Путается в языках, в одном предложении может переключиться три раза: с русского на английский, а с английского на китайский и обратно |
| 5 | Llama-2-7B-Chat* | Q4_K_S | 46.23 т/сек Быстро | 0.22 сек | 4096 | Отлично ведёт диалог и грамотно поддерживает беседу с пользователем, даёт правильные ответы |
| 6 | Mistral-7B-Instruct-v0.3 | Q5_K_M | 38.95 т/сек | 0.20 сек | 4096 | Самая среднестатистическая из представленных, ничем не выделяется |
| 7 | Llama-3.2-8X3B-MOE-Instruct-18.4B* | Q5_K_M | 22.63 т/сек | 2.18 сек | 4096 | Стремительно генерирует ответы, но изредка допускает ошибки |
| 8 | Qwen3-4B-Thinking-2507 | Q6_K | 44.90 т/сек Быстро | 0.15 сек | 4096 | Качественно рассуждает, даёт исчерпывающие ответы |
| 9 | gemma-3n-E4B-it-text | Q6_K | 32.06 т/сек | 0.17 сек | 4096 | Иногда запинается и коверкает предложения |
| 10 | Meta-Llama-3-8B-Instruct-bf16* | Q6_K | 28.86 т/сек | 0.19 сек | 4096 | Отвечает неправильно, зачастую не по теме, показывает рекордное время до первого токена |
| 11 | Meta-Llama-3-8B-Instruct-bf16* | Q8_0 | 36.57 т/сек | 1.47 сек | 4096 | Отвечает разумнее, чуть медленнее своего собрата на Q6_K |
| 12 | Qwen3-4B-Thinking-2507 | Q8_0 | 56.63 т/сек Быстро | 0.17 сек | 4096 | Пожалуй, одна из самых разумных и шустрых моделей |
| 13 | LLaMA-7b-AWQ* | AWQ | 35.56 т/сек | 0.21 сек | 4096 | Очень короткий, не содержательный ответ |
| 14 | Qwen3-4B-Instruct-2507-F16 | BF16 | 45.34 т/сек Быстро | 0.15 сек | 4096 | Даёт очень качественные ответы, но как и любая крупная модель работает медленнее |
| 15 | Meta-Llama-3-8B-Instruct-bf16* | BF16 | 4.91 т/сек Медленно | 2.19 сек | 4096 | Качественные ответы, но работает довольно неповоротливо и медленно |
Примечание: Все модели протестированы на Tesla P100 в одинаковых условиях с контекстом 4096 токенов. Скорость генерации измеряется в токенах в секунду (т/сек). “До первого токена” показывает время ответа системы от начала запроса.
В целом, как можно наблюдать из результатов, NVIDIA Tesla P100 показывает весьма подобающую для своего возраста производительность. Её показатели примерно на треть лучше чем у протестированной ранее P40. Но, в отличии от оснащённой большим колличеством памяти младшей сестры – P100 не может кратно увеличить длину контекста. Если P40 сдавалась на 90к токенах, а плохо ей становилось на 70. То P100 заикается уже на 30 тысячах, а больше 50 переварить физически уже не может.
Из заметных позитивных отличий можно приметить время до первого токена. Оно кратно меньше чем у P40 за счёт большей пропускной способности памяти и лучшей оптимизации для параллельных вычислений.
Поэтому если не преступать разумные границы, и не выкручивать длину контекста “до хруста”, то NVIDIA Tesla P100 способна похвастать увесистым преимуществом в производительности на умеренных температурах.
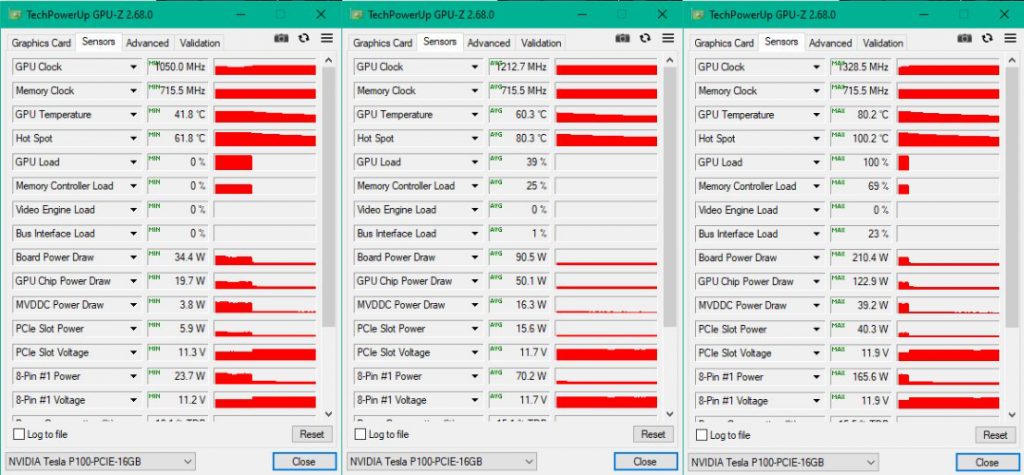
Температуры NVIDIA Tesla P100
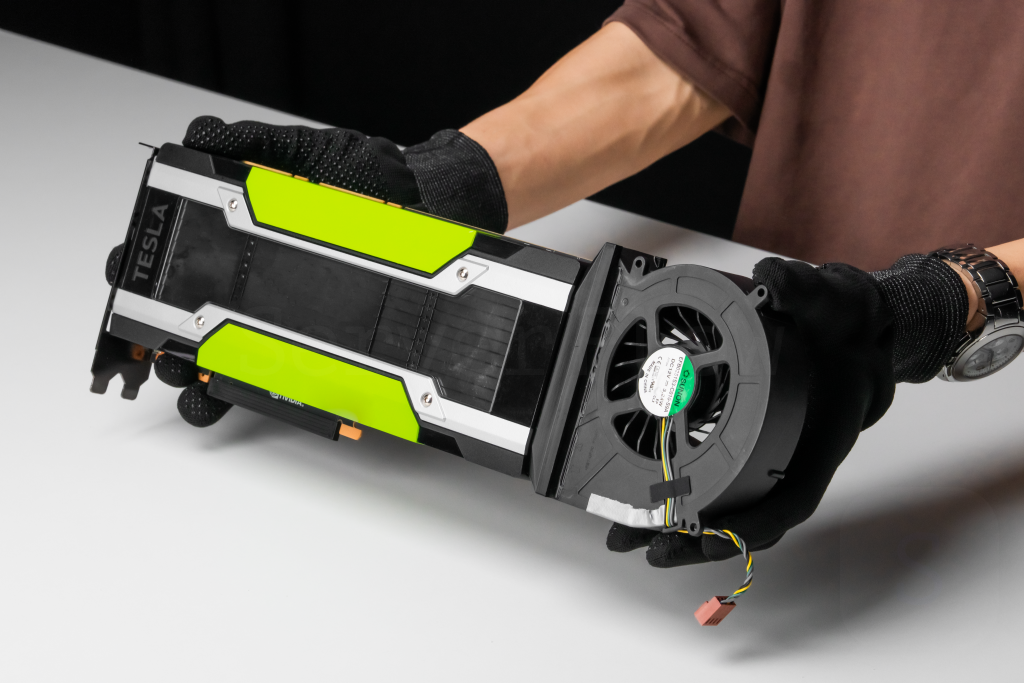
Использование NVIDIA Tesla P100 предполагалось в серверных стойках, поэтому штатный пассивный радиатор не сумеет обеспечить эффективного отвода тепла в обычном корпусе. Именно поэтому в обычных системах требуется установка активного кастомного охлаждения.
Вывод о NVIDIA Tesla P100
NVIDIA Tesla P100 представляет собой интересный компромисс между производительностью и стоимостью для энтузиастов LLM инференса. Её высокоскоростная память HBM2 даёт ей увесистое преимущество перед более старыми видеокартами с обычной GDDR5 памятью.
Однако при выборе этой карты следует понимать её ограничения: скромный объём памяти в 16 ГБ и близкое окончание поддержки драйверов в 2026 году. Однако если вы готовы смириться с этими ограничениями и не нуждаетесь в долгосрочной гарантии совместимости, P100 станет отличной инвестицией для экспериментов с локальными LLM.
NVIDIA Tesla P100 по прежнему остаётся актуальным ускорителем, которым можно пользоваться в современных условиях, пусть и с оговорками.
*LLAMA — проект Meta Platforms Inc.**, деятельность которой в России признана экстремистской и запрещена
**Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год