


GPTQ: практическое квантование языковых моделей без потери смысла

Вступление
Когда вы только начинаете работать с локальными LLM Ollama, LM Studio, замечаете знакомые надписи вроде Q4_K_M или Q6_K_M. Это обозначения простых, доступных квантованных моделей, с которыми приятно начать путь в мире генеративного ИИ. Но вот приходит момент, когда вы решаете перейти на нечто более мощное и гибкое, например, ставите VLLM. В этот момент на экране появляется новое слово: GPTQ.
GPTQ не просто техническая новинка или загадочная аббревиатура. Это практическое отражение следующей ступени взросления каждого энтузиаста: когда хочется не просто запускать модели, а понимать, как они устроены внутри, почему они занимают столько памяти и что мешает им «летать» даже на мощных GPU. Квантование нейросетей, ускорение моделей, сжатие весов, всё это в GPTQ становится не теоретической концепцией, а частью вашей инженерной рутины. Если вы дошли до GPTQ, значит сосредоточились уже не на внешних эффектных результатах, а на глубокой технической оптимизации работы с LLM.
GPTQ занимает промежуточное положение между простыми схемами квантования, распространёнными в популярных инструментах, и более сложными, профессиональными подходами, которые предлагают индивидуальную настройку для требований бизнеса, сервера, научной задачи. Освоив GPTQ, вы совершаете важный шаг от пользователя к инженеру, способному влиять на производительность, экономику и доступность ИИ-технологий.
Что такое квантование и зачем оно нужно языковым моделям
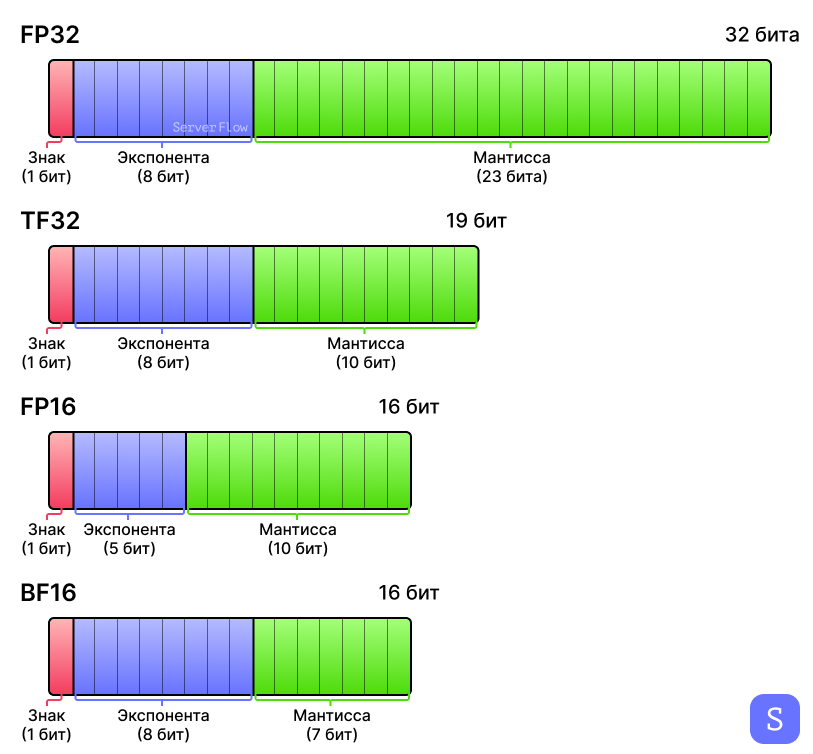
Квантование нейросетей это одна из базовых инженерных стратегий для оптимизации языковых моделей. По сути, это перевод весов из стандартных “жирных” форматов, вроде 16- или 32-битных значений, в более компактные числовые представления. Квантование LLM становится особенно критичным, когда дело касается запуска больших моделей в ограниченных ресурсах железа, будь то облако, рабочая станция или домашний ПК. Уменьшение размера модели позволяет ускорить инференс, а текущий тренд на генерацию текста в реальном времени только усиливает спрос на эффективные решения.
Где и когда вы впервые сталкиваетесь с GPTQ
Как работает GPTQ — простыми словами
Почему GPTQ важен для vLLM и других профессиональных движков
Преимущества и ограничения GPTQ
Выводы по GPTQ: что идёт дальше
*LLAMA — проект Meta Platforms Inc.**, деятельность которой в России признана экстремистской и запрещена
**Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год