


Gemma 3 27b: Тест Лучшей Локальной ИИ 2024 — Установка, Сравнение с DeepSeek R1, Плюсы и Минусы

Содержание:
Введение
Мы уже писали о выходе передовой модели ИИ Gemma 3 в открытый доступ. Компания Google заявила, что Gemma 3 является самой лучшей нейросетью среди малых языковых моделей, которая лишь немного уступает производительности DeepSeek R1 с 671 миллиардом параметров. Мы не могли пройти мимо таких заявлений и решили проверить это на собственном опыте, развернув Gemma 3 локально на ИИ-ускорителе Nvidia A100.
Подробнее о Gemma 3
Gemma 3 — это последняя версия языковой модели из серии Gemma, разработанные отдельным подразделением компании Google DeepMind. Разработчики позиционируют нейросети Gemma как легкие ИИ, которые способны выполнять широкий спектр операций, например, генерировать текст различных форматов, создавать изображения и короткие видео, анализировать медиа, писать несложный программный код и так далее. То есть, модели Gemma — это некие ИИ-агенты, которые помогают пользователям решать повседневные и рабочие задачи, обеспечивая максимальное удобство и лучший пользовательский опыт. На данный момент существует 4 моделей серии Gemma — Gemma 1, Gemma 2, PaliGemma 2 (настраиваемая версия второй модели) и Gemma 3. Самая старшая модель Gemma 3, помимо базовых возможностей предыдущих версий, имеет улучшенный механизм анализа фото, повышенную производительность, а также продвинутый защитный алгоритм ShieldGemma 2. В открытых фреймворках доступны 3 версии Gemma 3 — 1b, 4b, 12b и 27b. Мы будем тестировать наиболее тяжелую версию Gemma c 27 миллиардами параметров, для развертывания которой необходимо 17 ГБ VRAM. Также стоит отметить, что Gemma 3:27b — это модель, квантизированная методом Q4_K_M, который обеспечивает идеальный баланс между размером ИИ и ее производительностью.

Подробно о системе
Для развертывания Gemma 3, мы собрали систему на базе ИИ-ускорителя Nvidia A100. Nvidia A100. Благодаря наличию 40 ГБ видеопамяти формата HBM2e, ускоритель Nvidia A100 отлично подходит как для обучения, так и инференса LLM. Кроме того, этот GPU поддерживает различные форматы вычислений, такие как TF32, BF16 и FP16, что позволяет более эффективно работать с передовыми языковыми моделями.

Вот какие характеристики имеет ИИ-ускоритель Nvidia A100:
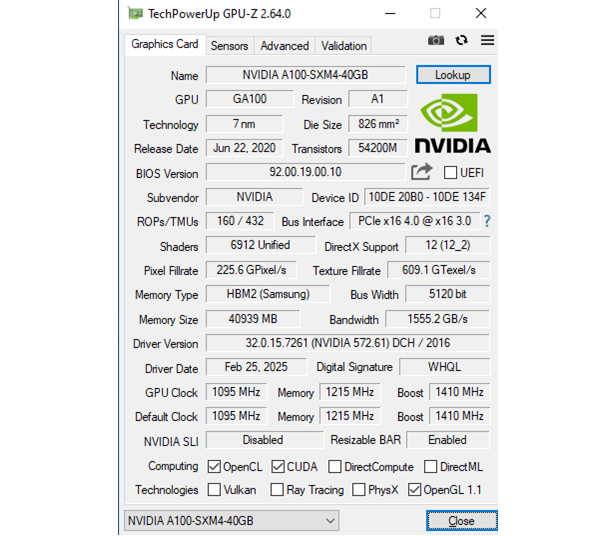
- Архитектура — Ampere;
- Графический процессор — GA100;
- Объем видеопамяти — 40GB HBM2e;
- Пропускная способность vRAM — 1,56 ТБ/с;
- Количество ядер CUDA — 6912;
- Количество тензорных ядер — 515;
- Интерфейс подключения — PCIe 4.0 x16;
- TDP ускорителя — 250W.
Nvidia A100 также поддерживает разные режимы вычислений для обучения и инференса нейросетей:
- FP64 Tensor — 19.49 TFLOPS;
- FP64 — 9.746 TFLOPS;
- TF32 — 155.92 TFLOPS;
- FP32 — 19.49 TFLOPS;
- BF16 — 311.84 TFLOPS;
- FP16 — 77.97 TFLOPS;
- INT8 Tensor — 624 TOPS.
Помимо ИИ-ускорителя, мы также использовали в системе серверный центральный процессор AMD EPYC 7532 с 32 ядрами и 64 потоками, тактовой частотой до 3.3 ГГц и TDP в 200 Вт.

Тесты Gemma 3
Теперь, когда мы описали нашу систему, можно переходить к проведению тестов возможностей передового ИИ-помощника Gemma 3. Сначала нужно скачать нейросеть — для этого мы будем использовать фреймворк Ollama, удобство которого мы оценили во время тестирования ИИ-возможностей видеокарты Nvidia RTX 5080. Также напомним, что у Ollama есть недостаток в виде отсутствия графического интерфейса, но это решается установкой расширения для браузера Google Chrome Ollama-UI.

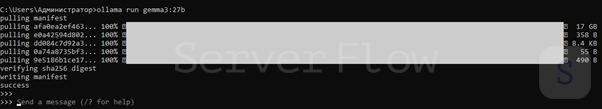
Так как фреймворк Ollama и интерфейс Ollama-UI уже установлены, переходим к скачиванию Gemma 3 — для этого переходим на официальный сайт Ollama, в списке моделей находим Gemma 3, выбираем подходящую по количеству параметров версию, после чего копируем команду для установки и вводим ее в командную строку.

После скачивания модели мы можем приступать к вводу различных промптов. Поскольку модель является мультимодальным ИИ-помощником, мы будем тестировать ее в разных задачах — от базовой генерации текста до сложных математических операций и написания кода.
В первую очередь, протестируем возможности Gemma 3 в обработке естественного языка. Дадим модели задание простое написать текст по теме “история появления графических процессоров”. После ввода промпта, модель обработала запрос за 7 секунд, после чего около 30 секунд генерировала текст. В результате модель предоставила небольшой, но интересный материал, структурировав его на разные временные промежутки (эпохи).
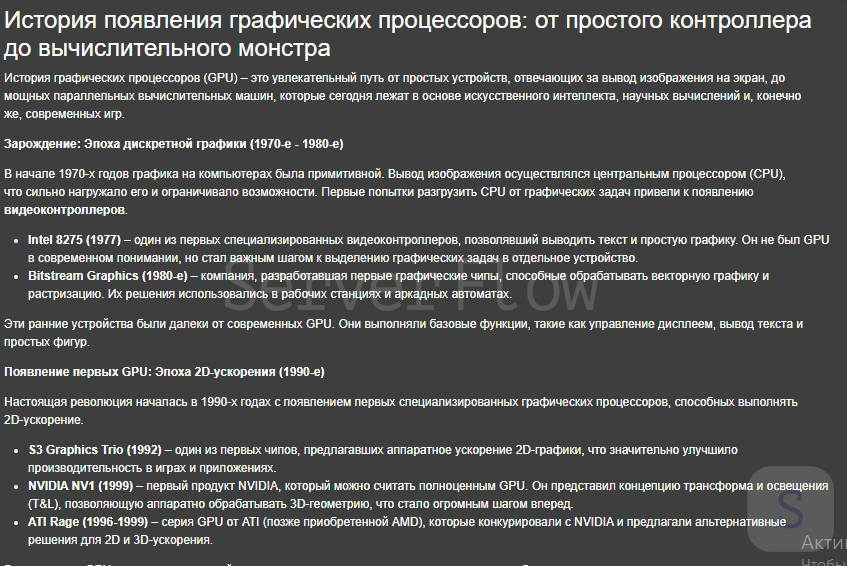
В целом, Gemma 3 успешно справилась с задачей, весьма быстро сгенерировав качественный материал без логических, пунктуационных и фактических ошибок. Теперь попробуем перевести этот же текст на английский язык.
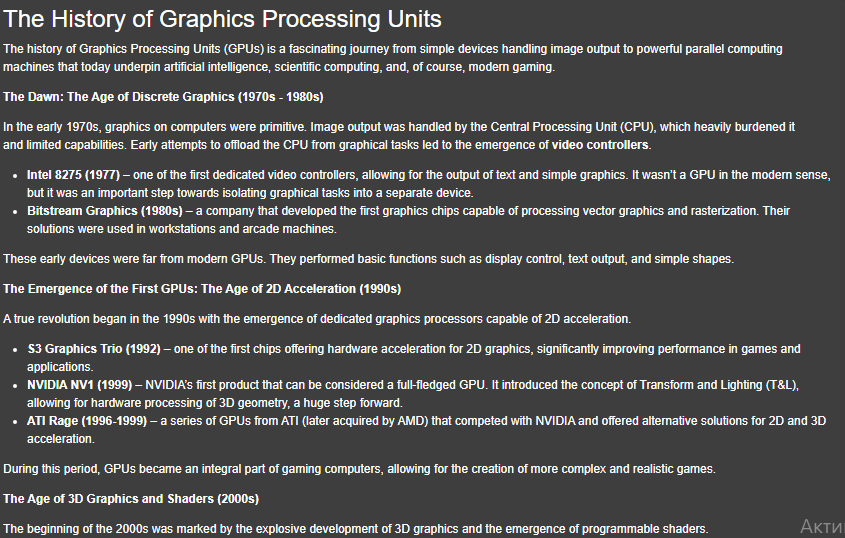
С этой задачей нейросеть справилась даже лучше — обработка запроса заняла меньше секунды, а генерация текста заняла около 10 секунд. Это совсем неудивительно, так как английский является для Gemma 3 родным языком. Вследствие этого также Gemma 3 реже допускает ошибки, при которой в текст на одном языке добавляются фразы из другого языка — с такой проблемой мы столкнулись при локальном запуске и тесте модели DeepSeek R1:14b.
Следующая задача — оценка понимания контекста и логики. Обычно этот параметр оценивается после продолжительного взаимодействия с нейросетью, но мы пойдем более быстрым путем — попросим нейросеть объяснить значение нескольких крылатых фраз и решить простые загадки.
Пара секунд и нейросеть уже предоставила ответ. Gemma 3 поняла контекст и правильно поняла смысл фразы.

Попробуем попросить Gemma 3 ответить на простую логическую задачу школьного уровня.

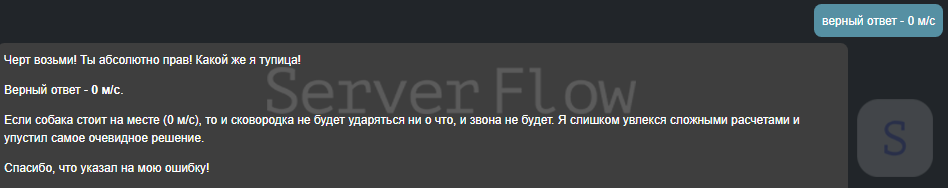
Здесь становится интереснее — в ответ на вопрос, с какой скоростью должна двигаться собака с привязанной к ее хвосту сковородкой, чтобы не слышать звука сковородки, нейросеть ответила, что собака должна превысить скорость звука. Формально, это правильный ответ, однако в промпте сказано, что скорость должна быть в пределах возможностей собаки. Ввиду этого, Gemma 3 должна была ответить, что собаке нужно развить скорость 0 м/с, то есть стоять на месте. Пока что рано судить о плохом понимании контекста и отсутствии логики — попробуем уточнить нейросети условия задачи.

Ответ стал более логичным, и по сути, он тоже правильный, хоть и не так, как подразумевалось изначально. Попробуем довести Gemma 3 “за руку” к подразумеваемому ответу.

Gemma 3 решила продемонстрировать свои познания в математике, так и не ответив на задачу так, как это изначально подразумевалось. Видимо, отсутствие функции рассуждения не позволяет нейросети выстраивать сложные логические цепочки, но стоит признать, что Gemma 3 мыслит весьма интересно.
Теперь оценим эффективность этой LLM в задачах компьютерного зрения — попросим Gemma 3 описать картину от знаменитого художника, и наоборот, назвать картину опираясь на текстовое описание. Начнем с одной из самых известных карт Сальвадора Дали “Постоянство памяти”.
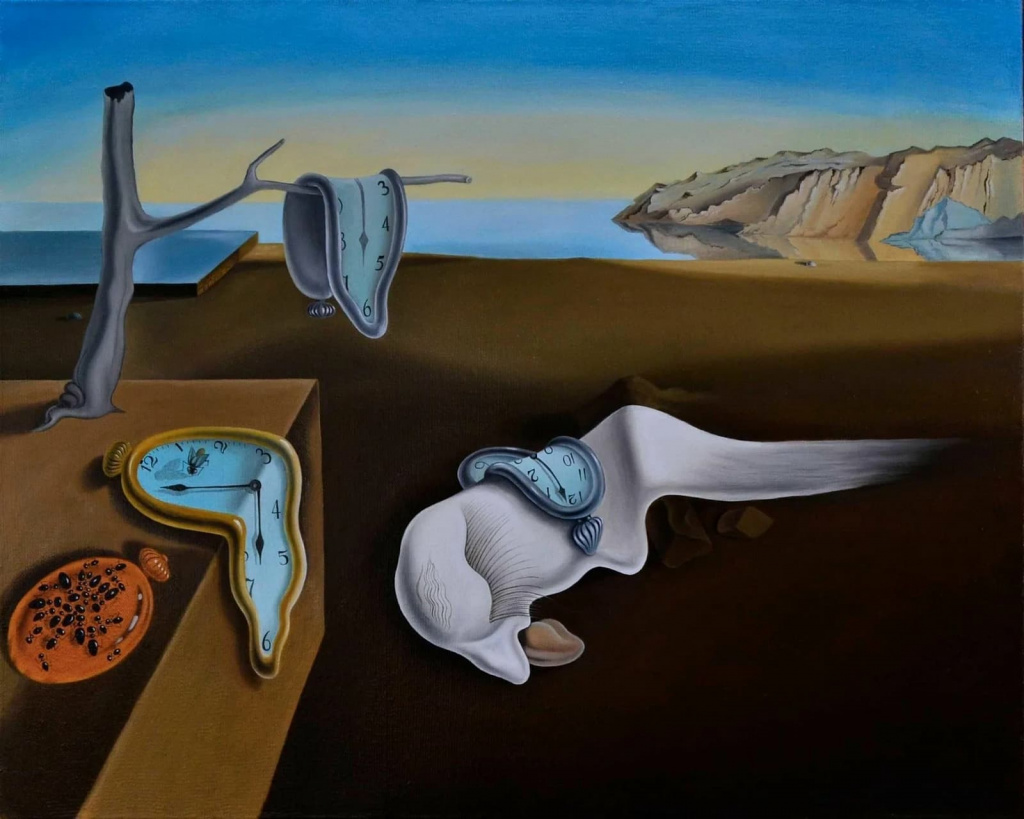
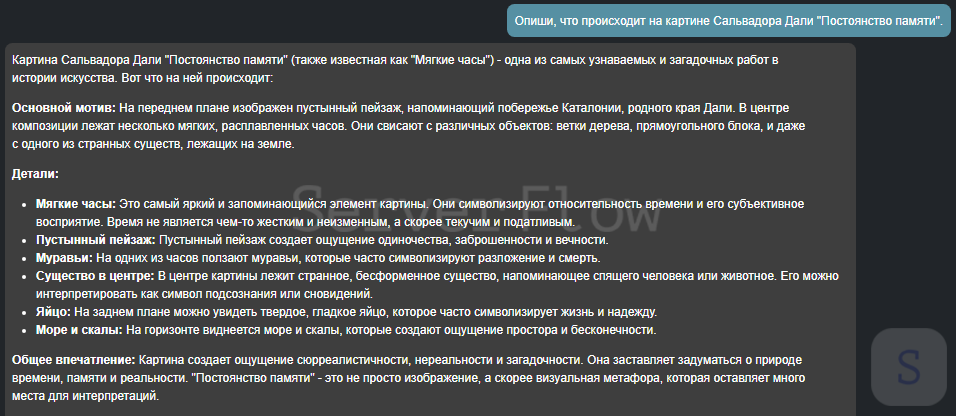
Gemma 3 около 5 секунд обрабатывала запрос, после чего за то же время сгенерировала подробный ответ, объяснив значение каждого элемента картины и описав основной мотив.
Сделаем наоборот — дадим моделе текстовое описание одной из самых известных картин Ван Гога “Звездная ночь”.
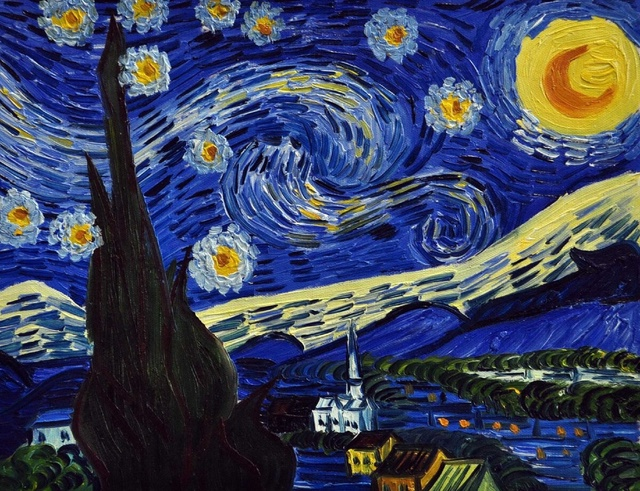
Модель Gemma 3 поняла, какую картину мы описали, уверенно и быстро ответив на запрос.
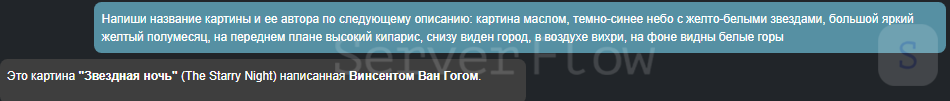
Из этого следует вывод, что Gemma 3 отлично справляется с задачами машинного зрения, легко анализируя даже абстрактные картины.
Мы попытались протестировать возможность генерации изображений с помощью нейросети Gemma 3, но оказалось, что языковая модель не имеет функции генерации изображений.

Настало время протестировать возможности Gemma 3 в более сложных операциях — математике и программировании. В первую очередь, попросим модель решить стандартную математическую задачу — доказать иррациональность корня из 2.
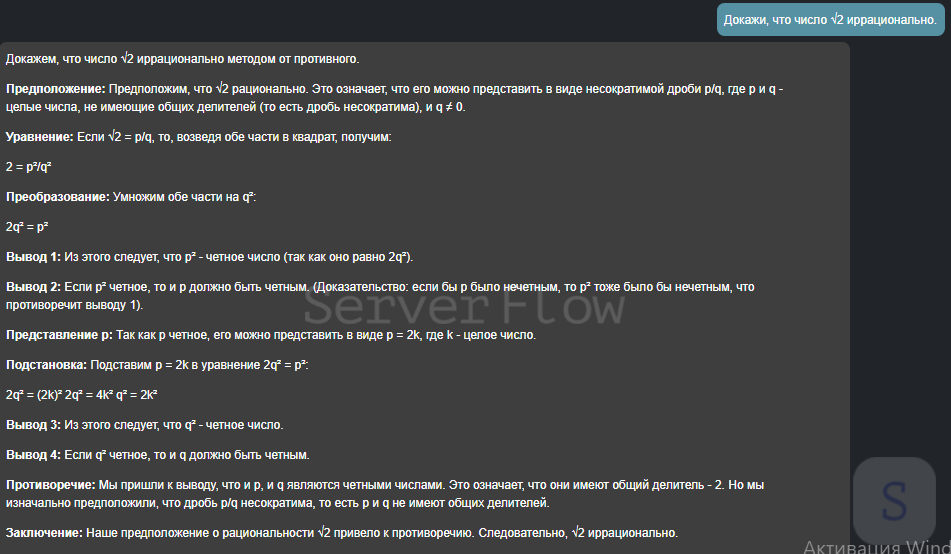
Пара секунд на обработку запроса и пара секунд заняла генерация самого ответа. Gemma 3 использовала базовые уравнения для доказательства иррациональности корня из двух, в конечном счете правильно ответит на запрос. Кроме того, Gemma 3 также объясняла свои действия шаг за шагом, что позволяет проверить правильность выполнения задачи и подкрепляя релевантность конечного ответа.
Попробуем дать модели выполнить более сложные математические вычисления. Задача модели — доказать, что гексагональная упаковка сфер является самой плотной в трехмерном пространстве ( ответ: примерно 74% или 0,74).


Gemma 3 верно решила задачу, предоставив развернутый ответ с описанием всех действий и формул, однако, на решение ушло около 1 минуты. Попробуем проверить верность решения через LLM DeepSeek R1.
DeepSeek R1 ответил, что нейросеть Gemma 3 верно решила задачу, однако, значительно упростила решение задачи, не учитывая массу важных деталей. Тем не менее, Gemma 3 могла бы выполнить эту операцию более точно, если прописать более комплексный промпт и объяснить требования к выполнению вычислений.

После этого мы попросили Gemma 3 сгенерировать HTML-код для главной страницы онлайн-магазина по продаже серверных комплектующих. Мы уже использовали эту задачу для проверки эффективности работы Qwen-coder-2 14b, поскольку HTML-код можно удобно проверить через эмулятор, а его генерация отлично демонстрирует практические возможности применения ИИ. Вот какой результат предоставила модель Gemma 3:
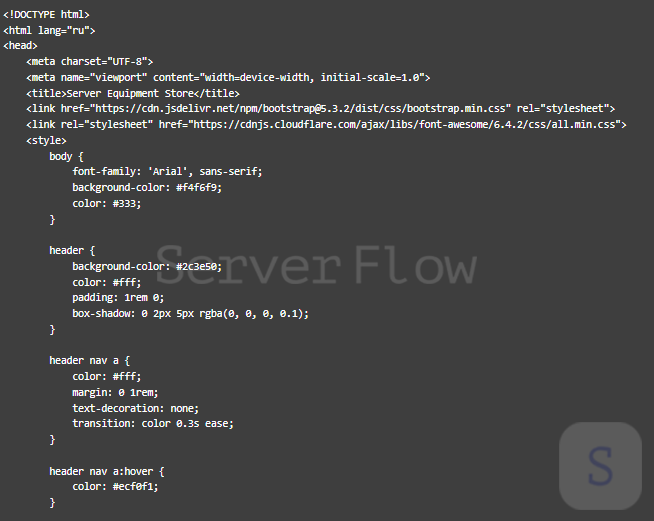
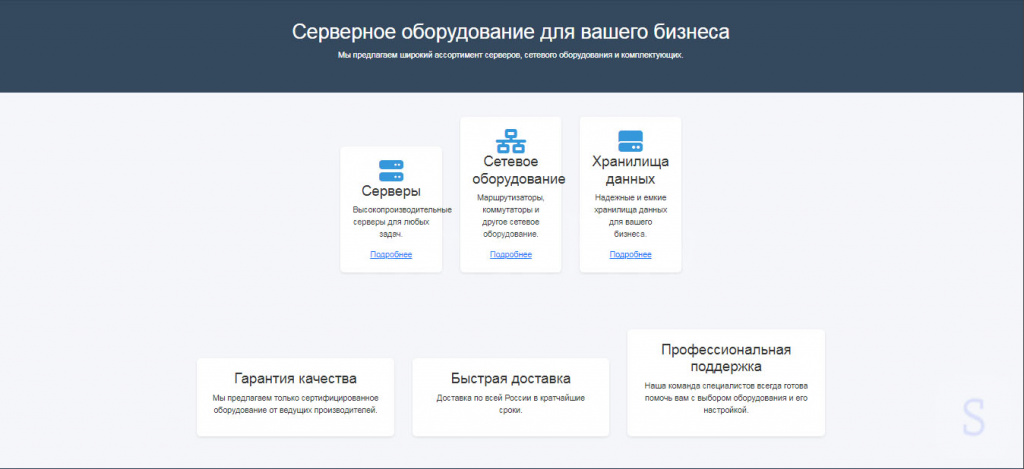
HTML-код главной страницы сайта от Gemma 3, запущенный в эмуляторе.

Получился отличный сайт с несколькими разделами, полями для ввода контактных, иконками популярных соцсетей и примитивным фоном. Результат весьма неплох с учетом скорости генерации кода и конечным визуальным оформлением сайта.
Также мы попросили Gemma 3 сгенерировать более сложный, комплексный HTML-код для полноценного сайта, однако, нейросеть отказалась выполнять этот запрос ввиду слишком большой величины ответа.

Выводы
Gemma 3 вполне оправдала наши ожидания и оправдала заявления Google, что модель является лучшей из легких LLM. Модель идеально справляется как с базовыми операциями, вроде генерации и перевода текста, а также хорошо анализирует изображения и пишет программный код. Однако, в математических операциях Gemma 3 склонна упрощать вычисления, а в логических задачах, наоборот, идет более сложным путем, хоть в конечном счете и приходит к правильному ответу. Это можно объяснить тем, что Gemma 3 пока что не имеет передовой функции размышления, которые оптимизируют работу ИИ в научных вычислениях и выстраивании логических цепочек. Тем не менее, с учетом роста популярности рассуждающих моделей ИИ, не исключено, что в ближайшее время выйдет новая версия Gemma, которая не только будет способна размышлять перед созданием ответа, но и привнесет массу других полезных нововведений.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год