


FP8: архитектура формата E4M3 и E5M2 и его роль в Mixed Precision вычислениях

Введение: новая волна форматов. От FP16 к FP8
Если вы разглядывали спецификации NVIDIA H100 или документацию AMD MI300, то наверняка видели упоминания про FP8 performance. Но что это значит на самом деле? Раньше, когда речь заходила о смешанной точности (mixed precision), инженеры говорили про FP16 и BF16 – это был стандарт для ускорения обучения и инференса сложных моделей. Работа велась так: основные вычисления в низкой точности, а веса и градиенты хранились в более высокой точности для стабильности.
Теперь появился новый стандарт. FP8 – это 8-битный формат с плавающей запятой, впервые появившийся в тензорных ядрах NVIDIA H100 Hopper (2022) и позднее внедренный AMD в MI300 (CDNA 3). Это принципиально отличается от INT8, который вы встречали раньше в примерах PTQ-квантизации. FP8 остаётся форматом с плавающей запятой, то есть использует экспоненту и мантиссу для кодирования чисел, а не целочисленное представление.
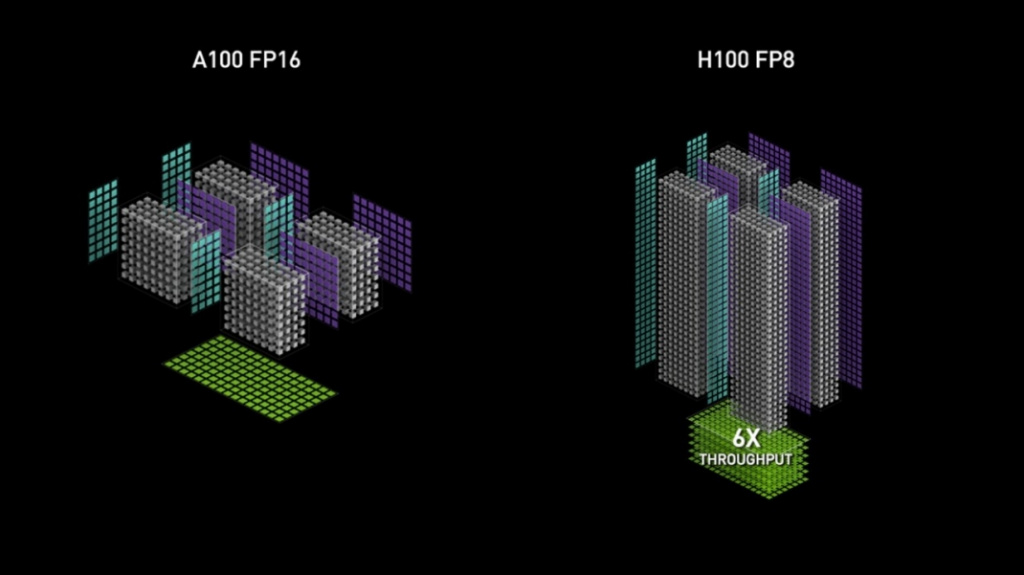
Практический результат впечатляет: FP8 даёт примерно вдвое больше ускорения по сравнению с FP16. Это значит, что на том же GPU вы можете обработать в два раза больше операций за единицу времени. Параллельно с этим снижается потребление памяти на 50 процентов, поскольку каждое число занимает половину места. Совокупный эффект – это возможность обучать и производить инференс модели на существующем железе, которое раньше для этого было недостаточно мощным, или одновременно обрабатывать в два раза больше запросов.
Главное отличие FP8 от INT8 состоит в том, что FP8 – это вычисления на уровне тензорных ядер (hardware-level quantization), в то время как INT8 – это оптимизация на уровне модели и инференса (PTQ, QAT). INT8 требует калибровки и часто применяется уже после обучения. FP8 же встроен в архитектуру GPU и может использоваться как во время обучения (через Transformer Engine), так и при инференсе. FP8 к тому же не монолитный формат, у него есть два варианта: E4M3 и E5M2.
Что такое FP8: принципы формата E4M3 и E5M2
Чтобы понять FP8, нужно разобраться в его двух вариантах: E4M3 и E5M2. Оба они уместили информацию о числе в 8 бит, но распределили эти биты по-разному.
E4M3 (1 бит знака + 4 бита экспоненты + 3 бита мантиссы). Этот формат приоритизирует точность. Четыре бита на экспоненту дают ему диапазон примерно от ±448, а три бита на мантиссу обеспечивают более точное представление чисел, близких к нулю. E4M3 используется для весов (weights) и активаций (activations) в прямом проходе (forward pass) нейросети. Здесь нужна точность, потому что небольшие изменения в значениях могут накапливаться и влиять на качество вычислений.
E5M2 (1 бит знака + 5 бит экспоненты + 2 бита мантиссы). Этот формат жертвует точностью ради диапазона. Пять бит на экспоненту расширяют диапазон до ±57 344, что позволяет представлять очень большие и очень маленькие значения. E5M2 предназначен для градиентов (gradients), которые вычисляются при обратном проходе (backward pass). Во время обратного распространения ошибки градиенты могут быть очень большими или очень маленькими, и тесный диапазон E4M3 привел бы к потерям информации.
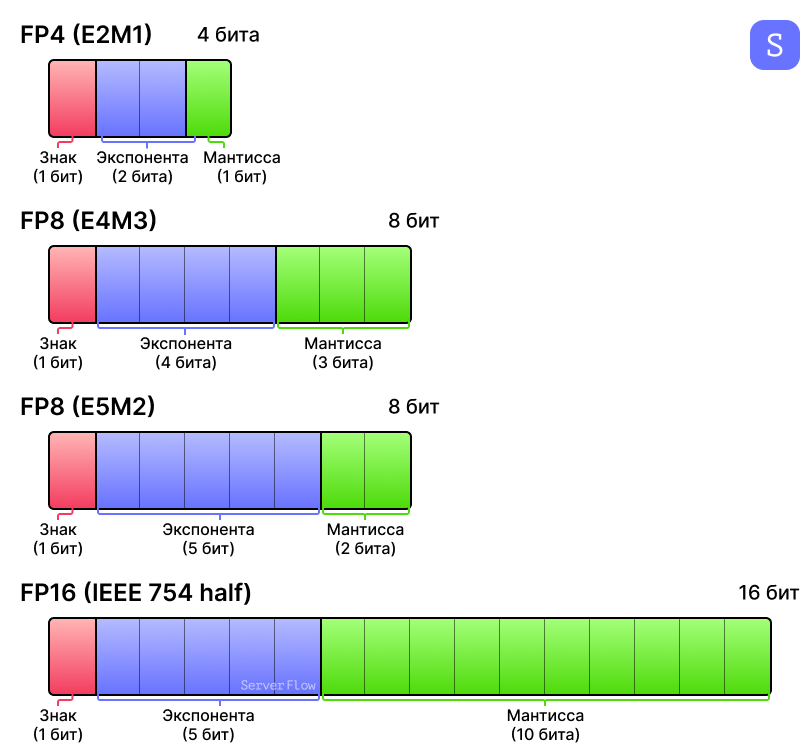
Выбор между E4M3 и E5M2 – это выбор между локальной точностью и глобальным диапазоном. Некоторые сети могут тренироваться целиком на одном из этих форматов, но большинство больших моделей требует обоих: E4M3 для forward pass и E5M2 для backward pass.
На уровне аппаратуры это означает, что операции в тензорных ядрах (Tensor Cores) напрямую работают с FP8, не требуя промежуточных преобразований. В NVIDIA H100 тензорные ядра четвёртого поколения поддерживают умножение и суммирование в FP8 с сохранением результата в более высокой точности. На уровне кода это выглядит простой операцией, но в электронике это требовало серьёзной переработки конвейера вычислений.
FP8 vs INT8: почему это не одно и то же
Путаница между FP8 и INT8 встречается часто, потому что оба – это 8-битные форматы. Но это совершенно разные подходы.
INT8 – это целочисленная квантизация (integer quantization). Числа представляются как целые числа в диапазоне от -128 до 127. Для этого требуется фиксированный scale (множитель), который определяется наибольшим значением в наборе данных. Если в ваших активациях есть выброс (outlier), он растягивает шкалу, и остальные значения представляются менее точно. INT8 применяется в основном для инференса и требует калибровки либо на этапе post-training quantization (PTQ), либо во время quantization-aware training (QAT).
FP8 – это плавающая запятая. Каждое число хранит свою экспоненту, что даёт адаптивный динамический диапазон. Если значение маленькое, экспонента подстраивается автоматически, и мантисса используется эффективнее. Если значение большое, экспонента растёт, сохраняя грубую точность. Этот подход естественнее для выбросов: они не «растягивают» шкалу для всех остальных значений.
На практике это означает, что FP8 лучше подходит для обучения больших моделей, где градиенты могут иметь широкий диапазон значений. INT8, напротив, показывает лучшие результаты на инференсе, когда активации и веса более стабильны и предсказуемы. Из исследований Qualcomm и NVIDIA видно, что FP8 покрывает 92.64% операций в современных сетях, в то время как INT8 справляется только с 65.87%. FP8 может работать с операциями типа LayerNorm и BatchNorm, где INT8 часто требует обхода.
По скорости на современном железе: INT8 может быть быстрее на специализированных inference-ускорителях (например, на edge-устройствах), но на H100 и MI300 FP8 работает на максимальной скорости благодаря встроенной поддержке в тензорных ядрах.
Аппаратная поддержка: NVIDIA и AMD
Поддержка FP8 на уровне железа – это то, что делает его реально применимым, а не просто теоретической конструкцией.
FP8 в экосистеме LLM и квантизации
- Хранить веса модели в NF4 (4 бита)
- Разворачивать их в INT8 или FP8 перед вычислением
- Выполнять операции в FP8 на Tensor Cores H100
- Сохранять результаты в FP16 или BF16 для следующего слоя
Заключение: FP8 — новый базовый уровень точности для ИИ
- Ускорение в 2 раза относительно FP16 благодаря встроенной поддержке в тензорных ядрах
- Экономия памяти на 50 процентов для весов, активаций и градиентов
- Снижение энергопотребления благодаря тому, что операции выполняются быстрее и с меньшей нагрузкой на шину памяти
- Лучшая точность при квантизации, чем INT8, за счёт адаптивного диапазона экспоненты
- Поддержка на современном железе: NVIDIA H100, B200, AMD MI300, MI355X
*LLAMA — проект Meta Platforms Inc.**, деятельность которой в России признана экстремистской и запрещена
**Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год