


daVinci-MagiHuman: открытая мультимодальная модель для генерации видео и аудио объемом 15 миллиардов параметров

Введение
Команды SII-GAIR и Sand.ai выпустили daVinci-MagiHuman — открытую мультимодальную модель с 15 миллиардами параметров, построенную на архитектуре однопоточного трансформера. Она одновременно генерирует видео с липсинком и синхронное аудио, создавая пятисекундный ролик в разрешении 256p всего за две секунды на одном ИИ-ускорителе H100 80 ГБ. Весь стек доступен под лицензией Apache 2.0: на GitHub и Hugging Face опубликованы базовая модель, дистиллированная версия, модуль сверхразрешения. Такая широкая доступность — редкость для моделей подобного уровня, тогда как большинство конкурентов (Veo 3, Sora 2, Kling 3.0) остаются закрытыми. Среди доступных аналогов, таких как Ovi и LTX‑2, daVinci‑MagiHuman демонстрирует наилучшее качество видео и самую низкую долю ошибок при распознавании сгенерированной речи: показатель WER составляет 14,60% против 40,45% у Ovi 1.1, что говорит о значительно более четкой и разборчивой речи в итоговом видео.
Подробнее о daVinci-MagiHuman
В основе модели лежит унифицированный 40-слойный трансформер с 15 миллиардами параметров, который обрабатывает текст, видео и аудио в единой последовательности токенов, используя только механизм внутреннего внимания — без перекрестного внимания и многопоточной сложности. Архитектура использует сэндвич-конфигурацию: в первых и последних четырех слоях применяются проекции, специфичные для каждой модальности, а средние 32 слоя имеют общие параметры. Модель не опирается на явные временные метки — состояние шумоподавления определяется непосредственно по входным скрытым данным. Для стабильности обучения на каждой головке внимания установлены обучаемые скалярные гейты с сигмоидальной активацией, а унифицированный интерфейс кондиционирования позволяет обрабатывать сигналы шумоподавления и эталонные данные без выделенных ветвей преобразования.
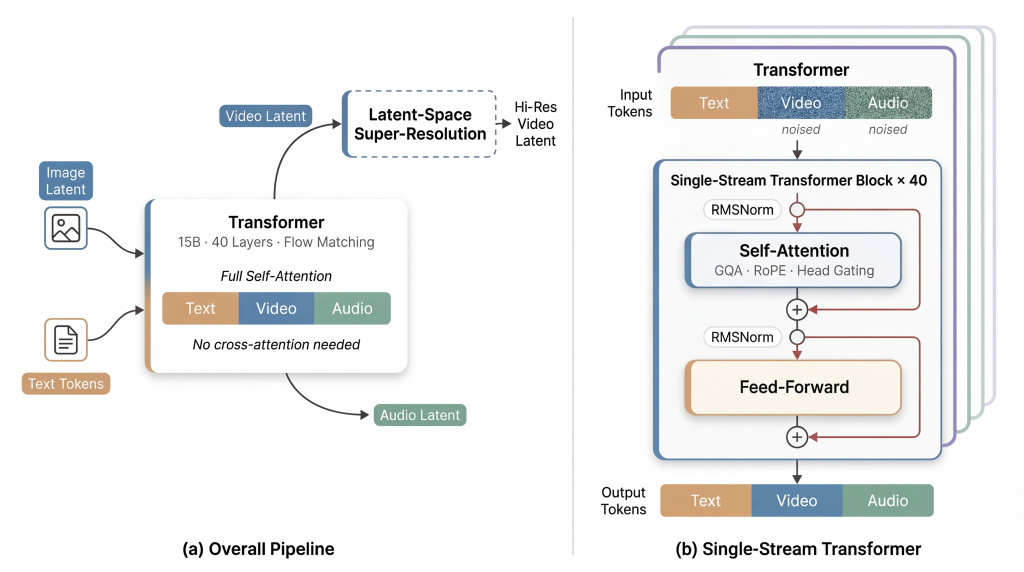
Модель ориентирована на высокое качество генерации человеческих персонажей: она обеспечивает выразительную мимику, естественную координацию речи и движений, точную синхронизацию аудио и видео, а также поддерживает несколько языков — китайский (путунхуа и кантонский), английский, японский, корейский, немецкий и французский. Скорость инференса для пятисекундного видео на GPU H100 составляет две секунды при разрешении 256p, восемь секунд для 540p и 38,4 секунды для 1080p. Высокая производительность достигается за счет двухэтапного сверхразрешения в латентном пространстве (что позволяет избежать лишнего цикла кодирования и декодирования VAE), использования облегченного турбо-декодера VAE, а также полной компиляции графа с помощью MagiCompiler, объединяющего операторы внутри слоев трансформера и дающего прирост скорости около 20%. Дистилляция по методу DMD‑2 позволяет выполнять генерацию всего за восемь шагов шумоподавления без использования CFG, сохраняя при этом высокое качество.
В количественных оценках daVinci‑MagiHuman превосходит открытые аналоги. По результатам парного сравнения модель оказалась предпочтительнее Ovi 1.1 в 80,0% случаев и LTX 2.3 — в 60,9% случаев. По визуальному качеству модель набрала 4,80 против 4,76 у LTX 2.3, по выравниванию текста — 4,18 против 4,12, а по физической согласованности — 4,52 против 4,56. Однако ключевое преимущество — в разборчивости речи: показатель WER у daVinci‑MagiHuman составляет 14,60%, что почти втрое ниже, чем у Ovi 1.1, и заметно ниже, чем 19,23% у LTX 2.3.
Выводы
daVinci‑MagiHuman представляет собой полностью открытое решение, сочетающее передовую архитектуру однопоточного трансформера с впечатляющей скоростью генерации и высоким качеством синхронизированного видео и аудио. Благодаря продуманным методам оптимизации — сверхразрешению в латентном пространстве, турбо-декодеру VAE, компиляции графа и дистилляции — модель достигает высокой эффективности на одном GPU H100. Открытый стек под лицензией Apache 2.0, включающий базовую и дистиллированную версии, а также полный код для инференса, дает сообществу мощный инструмент для дальнейших исследований и практического применения в области генерации реалистичных человеческих персонажей.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год