


CUDA: что это такое и как технология NVIDIA изменила вычисления на GPU

Введение
Если вы сегодня запустите любую современную нейросеть, будь то генерация изображения в Stable Diffusion или диалог с ChatGPT, вы незримо прикоснетесь к технологии, которая зародилась почти двадцать лет назад. В те времена, когда видеокарты служили исключительно для отрисовки полигонов в играх, компания NVIDIA сделала ставку, которая казалась многим безумной. Они решили превратить графический ускоритель в универсальный математический процессор.
Так зародилась CUDA. Это слово слышал каждый, кто хоть раз пытался запустить локальную нейросеть или занимался рендерингом, но далеко не все понимают, что скрывается под этим термином. Это не охапка драйверов и не просто “ядра” на кристалле. Это фундамент, на котором стоит весь современный мир искусственного интеллекта. Давайте разберемся, как это работает, почему это важно и при чем тут Дженсен Хуанг.
CUDA: что это такое и для чего она нужна
Когда человек не знакомый с внутренним устройством видеокарт NVIDIA задаётся вопросом: “Что такое CUDA?”, он часто ожидает услышать название какой-то детали внутри видеокарты. На самом деле всё немного сложнее и интереснее.
CUDA (Compute Unified Device Architecture) – это программно-аппаратная архитектура параллельных вычислений, которая позволяет использовать графический процессор (GPU) для решения сложных неграфических задач. Говоря простым языком, технология CUDA позволяет программисту писать код не для центрального процессора (CPU), а для видеокарты, заставляя её выполнять математические расчеты с невероятной скоростью.
Почему это вообще нужно? Дело в архитектуре. Центральный процессор подобен гениальному профессору математики: он может решить сложнейшее интегральное уравнение, но он работает последовательно, задача за задачей. Видеокарта же похожа на армию из тысяч учеников начальной школы. Каждый из них может решить только простой пример (сложить два числа), но они делают это одновременно. Если вам нужно сложить два миллиона чисел, “армия” GPU-юнитов справится с этим в тысячи раз быстрее одного “профессора” CPU.
В одной из серий “Разрушители легенд” наглядно показали разницу между CPU и GPU: пока процессор тщательно выводит изображение смайлика, множество GPU-юнитов рисуют Мону Лизу за долю секунды.
Так для чего CUDA нужна в первую очередь? Для задач, которые можно разбить на тысячи мелких, независимых подзадач: обработки видео, моделирования физики и, конечно же, обучения нейросетей. Давайте окунёмся в историческую хронологию и поглядим, как же она появилась на свет.
История появления CUDA: как появилась идея вычислений на GPU
Чтобы понять величие замысла NVIDIA CUDA, нужно вернуться в середину нулевых. Рынок видеокарт тогда жил по простым законам: больше FPS в играх, красивее взрывы, реалистичнее вода. Видеокарты имели жесткую архитектуру: отдельные блоки занимались вершинами треугольников, другие – пикселями. Это были “шейдерные конвейеры”, и заставить их считать что-то, кроме координат и цветов, было настоящей мукой для программистов-энтузиастов.
Дженсен Хуанг, бессменный лидер NVIDIA, увидел в этом тупик. Он понял, что GPU простаивают, когда пользователь не играет. История CUDA началась с рискованного решения унифицировать архитектуру. NVIDIA решила убрать разделение на вершинные и пиксельные блоки, заменив их универсальными процессорами, которые могли бы делать любую работу.
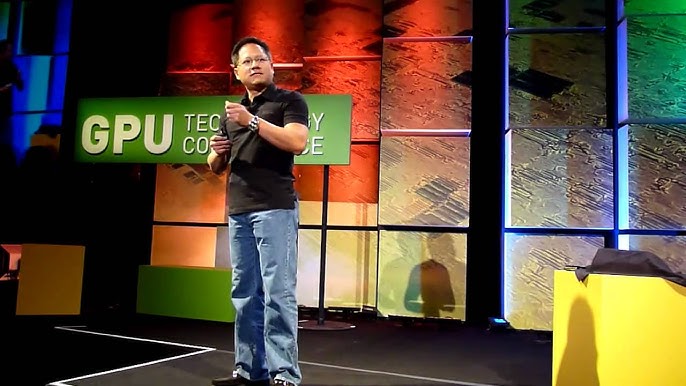
Это был огромный риск. Включение дополнительных транзисторов для логики управления вычислениями удорожало чипы и увеличивало их энергопотребление, не давая сиюминутного прироста в играх. Инвесторы и аналитики крутили пальцем у виска, не понимая, зачем усложнять видеокарты ради каких-то абстрактных “научных вычислений”. Но время показало, кто был прав.
Тернистый путь становления: от HPC к нейросетям
Внедрение технологии шло тяжело. Первые годы CUDA вычисления были уделом узкого круга ученых в белых халатах. Это был сегмент HPC (High Performance Computing). Технологию использовали для моделирования сворачивания белков, расчета траекторий в нефтегазовой отрасли и прогнозирования погоды.
Проблема была в пороге входа. Писать код на CUDA C++ было сложно, нужно было вручную управлять памятью видеокарты, следить за потоками и бороться с ошибками. Долгое время это не выходило в мейнстрим. Обычный пользователь знал о CUDA только по галочке в настройках видеокодировщика.
Переломный момент наступил в 2012 году, когда исследовательская группа Алекса Крижевского использовала GPU для обучения сверточной нейросети AlexNet. Оказалось, что CUDA для нейросетей подходит идеально. Глубокое обучение (Deep Learning) – это по сути бесконечное перемножение матриц, именно то, в чем “армия” простых ядер GPU сильна как никогда.
Именно переход индустрии к матричным вычислениям и понимание того, что для AI не всегда нужна высочайшая точность (достаточно FP16 или даже INT8), превратили CUDA из нишевого инструмента в золотой стандарт индустрии. Путь был не усыпан розами, но он привел к тому, что сегодня CUDA для глубокого обучения является безальтернативной базой.
CUDA ядра: что это такое и почему их постоянно путают
В разговорах о видеокартах часто возникает путаница. Маркетологи говорят о тысячах ядер, программисты – о версиях тулкита, а инженеры – об архитектуре. Давайте разберем, что есть что, чтобы раз и навсегда закрыть вопрос: “CUDA ядра, что это?”.
Нужно различать три понятия:
- Во-первых, существуют CUDA cores (CUDA-ядра). Это физические, аппаратные вычислительные блоки внутри кремниевого чипа GPU. Чем их больше, тем больше параллельных потоков может обработать карта за один такт. Это “рабочая сила”.
- Во-вторых, есть Compute Capability (вычислительная способность или SM-версия). Это аппаратный уровень возможностей архитектуры. Он определяет, какие именно инструкции физически может выполнить чип. Например, старые карты не умеют аппаратно работать с форматом BF16, сколько бы драйверов вы на них не ставили.
- В-третьих, есть версия CUDA (например, CUDA 12.1). Это программная среда: компилятор, библиотеки и инструменты разработчика.
Рассмотрим на примере современной серверной видеокарты H100. У неё есть аппаратная архитектура Hopper с Compute Capability 9.0. Это её физический предел возможностей. Но при этом она может работать с программной средой CUDA 12 или CUDA 13.
Секрет в обратной совместимости. Программная CUDA умеет адаптироваться под железо. Если вы запустите код, написанный под CUDA 12, на старой карте (скажем, Tesla P40, поколения Pascal), программа будет работать, но просто не будет использовать новые инструкции, которых нет в старом кремнии.
Таким образом, аппаратные CUDA-ядра это мышцы. А программная CUDA – это инструкция по применению этих мышц.
Тензорные ядра: эволюция CUDA для нейросетей и линейной алгебры
Долгое время обычные CUDA-ядра были универсальными солдатами. Они считали всё подряд: физику в играх, рендеринг видео, научные расчеты. Но с бумом нейросетей стало ясно, что универсальность – враг эффективности.
Нейросети, как мы уже выяснили, это операции линейной алгебры: умножение матрицы на матрицу и сложение результата. Делать это на универсальных ядрах можно, но долго. NVIDIA проанализировала нагрузку и поняла, что нужен специализированный блок.
Так появились Tensor Cores (тензорные ядра). Это не замена CUDA-ядрам, а их эволюционное дополнение. Тензорные ядра CUDA – это узкоспециализированные калькуляторы, которые умеют делать по сути одну вещь: перемножать матрицы 4×4 (и других размерностей) за один такт, но делают это невероятно быстро и эффективно.
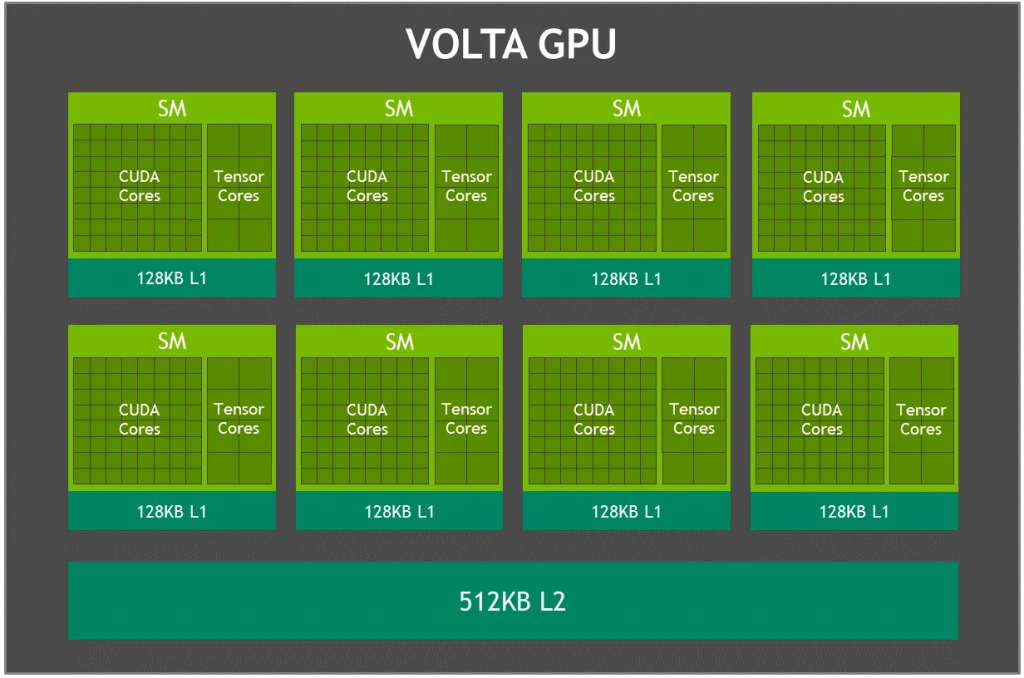
Важно понимать разницу: CUDA-ядра и тензорные ядра работают в тандеме. Если универсальные ядра обеспечивают гибкость и логику работы программы, то тензорные ядра включаются в момент тяжелых матричных вычислений, беря на себя основную нагрузку при обучении и инференсе нейросетей. Это позволило внедрить вычисления смешанной точности (FP16, FP8), кратно ускорив AI.
Подробнее о техническом устройстве тензорных ядер мы поведали в отдельном материале, где разбираем их архитектуру до транзисторов.
Надстройки над CUDA: как NVIDIA годами завоевывала рынок
Сама по себе “голая” CUDA – это сложный инструмент низкого уровня. Если бы каждому ML-инженеру приходилось писать на C++ ядра для перемножения матриц, революции ИИ не случилось бы. Гениальность стратегии NVIDIA заключалась в создании экосистемы готовых библиотек.
Компания методично выпускала надстройки, которые решали типовые задачи. Разработчику больше не нужно думать, как оптимально умножить векторы на GPU, за него это уже сделали инженеры NVIDIA.
cuBLAS, cuDNN, cuFFT и другие библиотеки
cuBLAS – это библиотека линейной алгебры. По сути, это реализация стандарта BLAS (Basic Linear Algebra Subprograms) поверх CUDA. Если вам нужно умножить матрицы и вы хотите сделать это максимально быстро, вы просто вызываете функцию из cuBLAS, не думая о том, как работают регистры видеокарты.
cuDNN (CUDA Deep Neural Network library) – это, пожалуй, самый важный компонент для современного AI. Библиотека содержит высокооптимизированные примитивы для глубоких нейросетей: свертки, пулинг, функции активации. cuDNN является двигателем, который крутится внутри PyTorch или TensorFlow. Без cuDNN обучение сетей было бы в разы медленнее.
cuFFT занимается быстрым преобразованием Фурье, что критично для обработки сигналов и анализа звука.
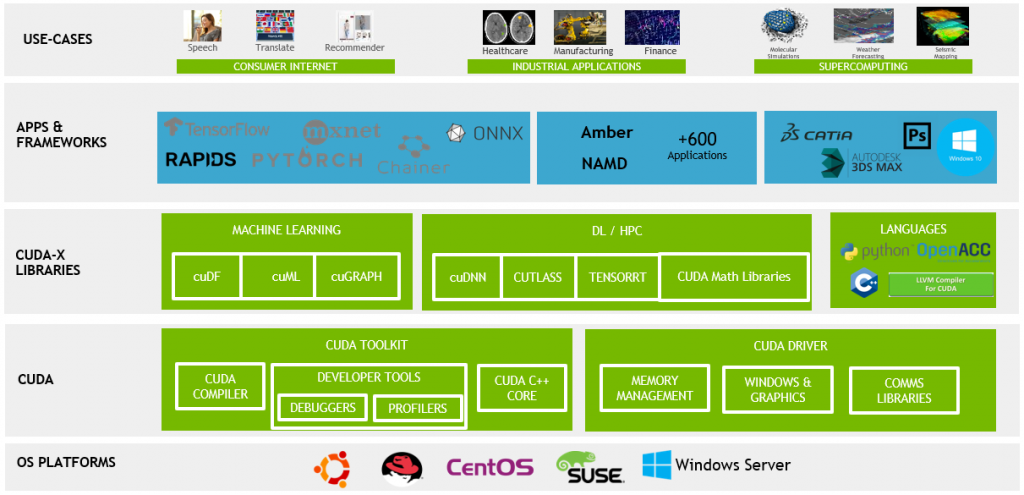
CUDA Toolkit: программная основа CUDA
CUDA и PyTorch: фундамент современного AI
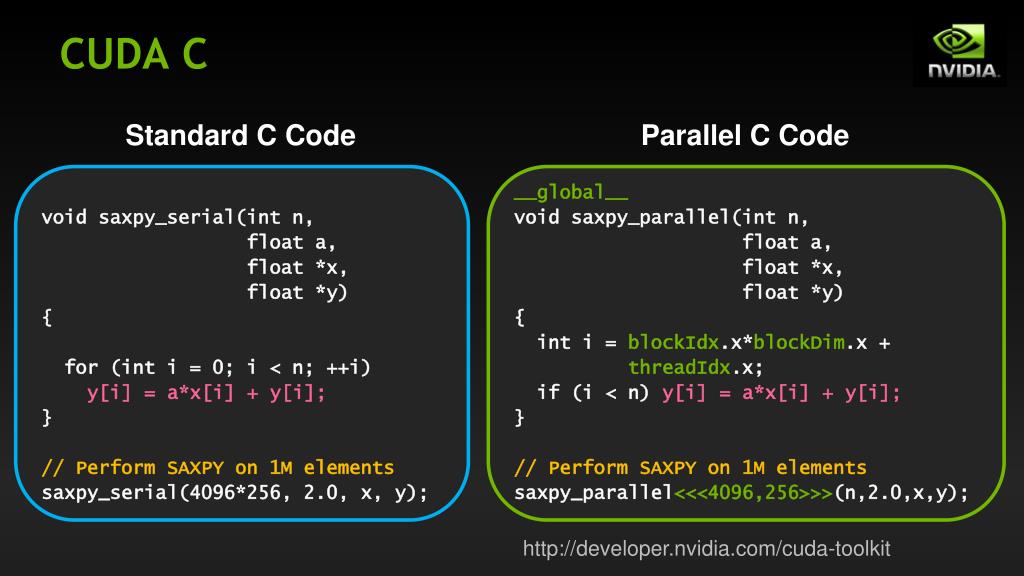
Поддержка cuDNN для PyTorch реализована настолько нативно, что разработчик часто даже не задумывается о том, что происходит на уровне железа. Но именно эта тесная интеграция софта и железа позволяет выжимать из видеокарт максимум производительности. TensorFlow, JAX – все они стоят на плечах гиганта по имени CUDA.
Выводы: как CUDA создала рынок и изменила NVIDIA
Оглядываясь назад, понимаешь, что CUDA – это не просто удачная технология. Это результат выверенной стратегии длиной в два десятилетия. Дженсен Хуанг верил в потенциал параллельных вычислений тогда, когда никто в это не верил.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год