


AMD представила ROCm v7

Введение
На конференции Advenced AI 2025, помимо передовых аппаратных ИИ-решений Instinct MI350X и MI355X, компания AMD также представила новую версию передового программного стека ROCm v7. AMD заявляет, что обновленное программное решение обеспечит прирост производительности искусственного интеллекта до 3,8 раз в ряде операций и расширенную поддержку управления ИИ-кластерами.
Подробнее о ROCm v7
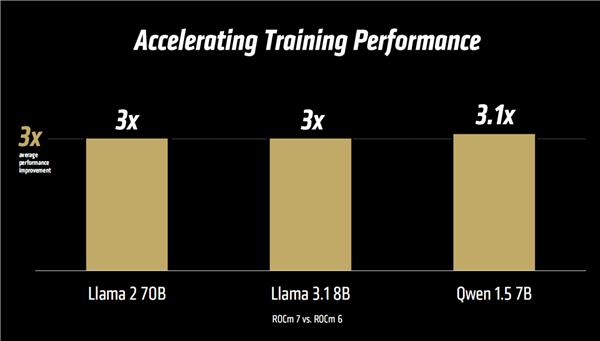
Программный стек ROCm v7, поддерживающий новейшие ускорители серии Instinct MI350 и MI355X, предлагает расширенную поддержку наиболее популярных ИИ-фреймворков (PyTorch, TensorFlow и т.д.), также добавляет работу с платформами vLLM v1, llm-d и SGLang. Кроме того, ROCm v7 также обеспечивает поддержку новейших ИИ-архитектур, таких как GEMM Autotuning, MoE, Attention и Python-кернелы, которые используются в наиболее современных и высокоэффективных языковых моделях. Еще одно нововведение ROCm v7 — поддержка новых форматов вычислений для обучения искусственного интеллекта, в частности, BF16/FP8. Это позволило 3-кратно увеличить скорость обучения языковых моделей Llama* 2, Llama* 3.1 и Qwen 1.5.
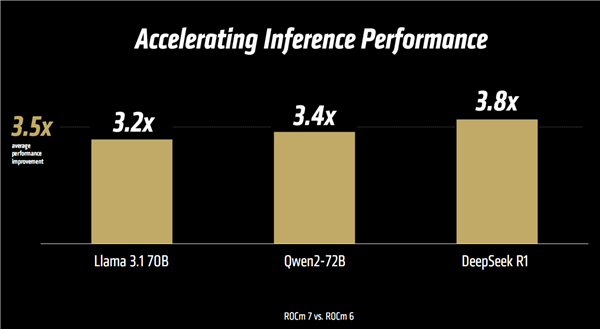
Однако основной фокус седьмой версии ROCm нацелен именно на инференс искусственного интеллекта. К примеру, теперь ROCm v7 позволяет запускать LLM в форматах квантизации FP8, FP6 и FP4, а также вводит оптимизацию Serving-решений, встроенные функции для доработки ИИ-архитектур, оптимизацию для распределенной обработки. Благодаря всем этим нововведениям, ROCm v7 предлагает 3,5-кратный прирост скорости инференса ИИ, 3,8-кратный прирост эффективности при запуске DeepSeek R1, 3.2-кратный прирост в Llama* 3.1 70B и 3.4-кратный прирост в Qwen2-72B при сравнении с ROCm v6.
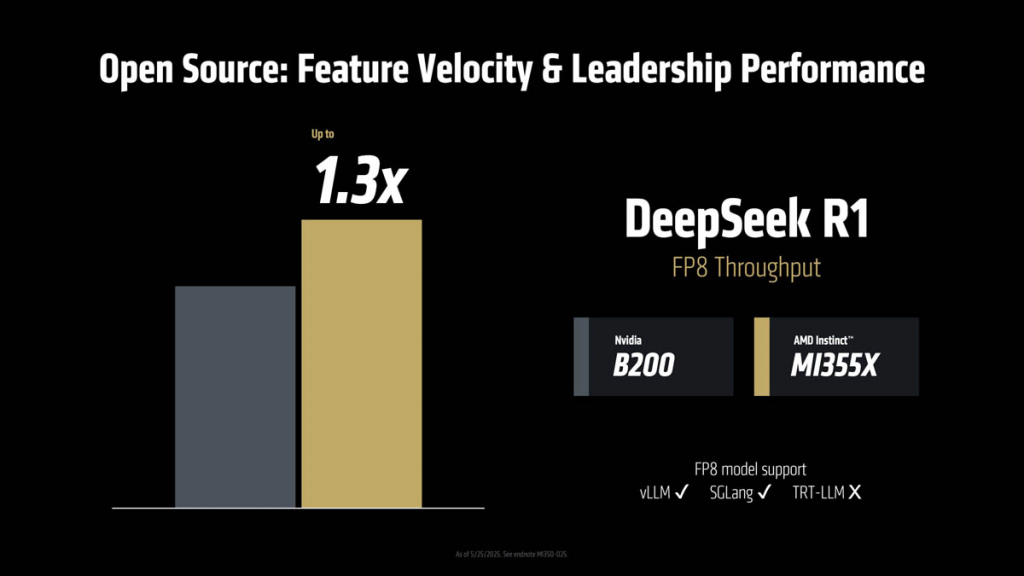
Примечательно, что программный стек ROCm v7 в связке с ускорителями MI355X опережает связку Blackwell B200 с CUDA в 1,5% по пропускной способности в инференсе DeepSeek R1 (режим FP8).
Выводы
AMD активно занимается совершенствованием своего программного стека ROCm v7, с каждым релизом повышая планку качества и вводя новые возможности. Если ранее платформа ROCm подвергалась большой критике ввиду ограниченной совместимости и проблем с реализацией, то сейчас ROCm v7 уверенно подбирается к своему ближайшему конкуренту в лице CUDA. А с учетом того, что Instinct MI350X и MI355X имеют все шансы стать одними из самых топовых ИИ-решений на рынке, востребованность ROCm v7 может кратно увеличиться.
*LLAMA — проект Meta Platforms Inc.**, деятельность которой в России признана экстремистской и запрещена
**Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год