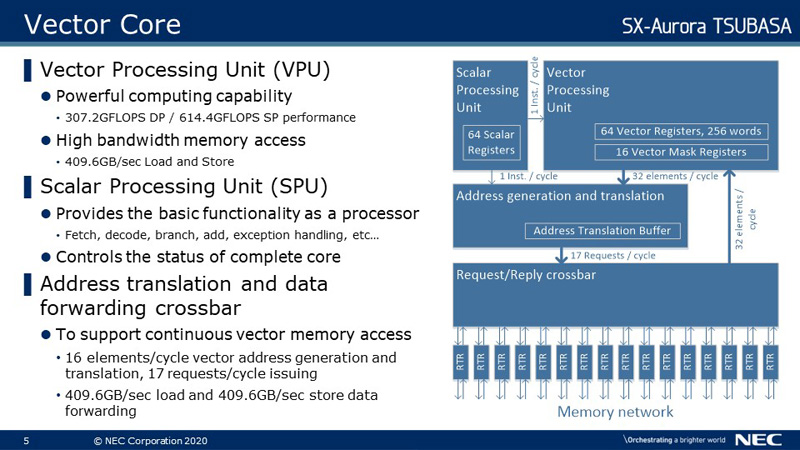
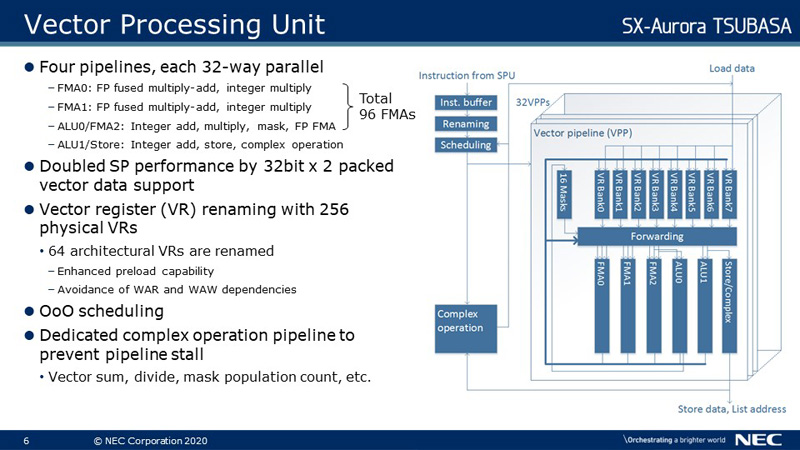
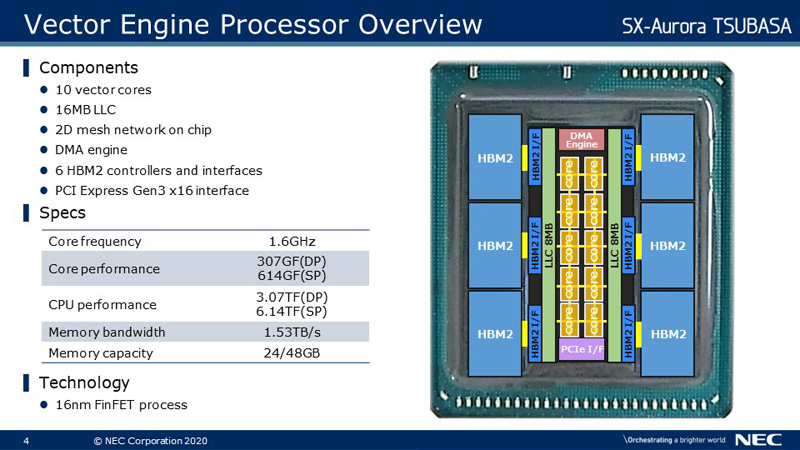
Компоновка процессора Vector Engine Type 20. Источник: NEC
Третье поколение, VE30, стало самым крупным обновлением в истории линейки: число ядер выросло до 16 (на 60% больше, чем у VE20), память перешла на более быстрый стандарт HBM2e, а пропускная способность подскочила до 2,45 ТБ/с, то есть выросла ещё почти на 60% относительно VE20. Пиковая производительность достигла 4,9 терафлопс FP64, а объём кэша увеличился до 64 МБ.
Важно не сравнивать эти цифры напрямую с современными AI-ускорителями типа NVIDIA A100 или H100. Те проектировались вокруг матричных тензорных операций и низкоточных форматов (BF16, FP8) для нейросетей; Vector Engine изначально строился вокруг FP64-векторизации и сбалансированного доступа к памяти для классического научного HPC. Поэтому уместнее сравнивать не у кого больше терафлопсов, а какая доля пиковой производительности реально достижима на конкретном алгоритме.
Один Vector Host может обслуживать одну, две, четыре или восемь карт VE, а стойка допускает десятки таких карт с масштабированием через MPI и высокоскоростную сеть между узлами.
Как с этим работает программист
Ключевая инженерная задача NEC – избавить разработчика от необходимости писать 256-элементные векторные операции вручную. Для этого создан собственный векторизующий компилятор, который анализирует обычный код на C, C++ или Fortran, находит подходящие для векторизации фрагменты и сам генерирует оптимальный машинный код.
Но автоматизация не означает независимость от структуры алгоритма. Лучше всего компилятор справляется с длинными регулярными циклами без сложных зависимостей между итерациями, классический пример SAXPY-подобного паттерна вида c[i] = a[i]*b[i] + c[i]. Такой цикл легко разбивается на длинные векторные блоки, проходящие через FMA-конвейеры почти без пауз.
Гораздо хуже ситуация с алгоритмами, где каждая итерация зависит от предыдущей, адреса данных непредсказуемы, а тело цикла насыщено условными переходами, например, обработка связных списков или преследование указателей. В таких случаях преимущество длинного вектора практически исчезает, и VE ведёт себя не лучше обычного скалярного процессора, хотя скалярная часть (SPU) всё же позволяет программе корректно работать.
Экосистема вокруг VE значительно уступает по масштабу CUDA: пользователю нужны собственные компиляторы NEC, библиотеки MPI и системное окружение платформы. Архитектура сохраняет преемственность программной модели NEC SX, а приложения SX-Aurora TSUBASA, но это скорее преимущество для унаследованных научных кодов, чем универсальный стандарт индустрии.
Где архитектура показывает преимущества
Естественная среда для VE – задачи, где данные представлены крупными числовыми полями, обрабатываемыми похожим образом: гидро и аэродинамика, распространение волн, теплоперенос, климатическое и погодное моделирование, вычислительная химия, молекулярная динамика, линейная алгебра и часть аналитических нагрузок.
Климатическая модель – хороший пример логики этой архитектуры. Атмосфера разбивается на трёхмерную сетку, каждая ячейка хранит температуру, давление, влажность, компоненты скорости. На каждом шаге по времени программа применяет похожие формулы к миллионам таких ячеек. Данных много, вычисления регулярны, двойная точность важна – то есть условия почти идеально соответствуют дизайну VE.
NEC также заявляла платформу для задач ИИ, машинного обучения и обработки больших данных. Здесь стоит сделать оговорку: современное обучение нейросетей, особенно больших языковых моделей, обычно оптимизируется под тензорные ядра и низкоточные форматы CUDA/ROCm-экосистемы. VE может быть эффективен для отдельных аналитических нагрузок и вычислений с преобладанием широких векторных операций, но не претендует на прямую замену NVIDIA-ускорителей в типичном пайплайне обучения диффузионных моделей или LLM.
Для инженера, привыкшего мыслить в терминах CUDA-ядер и warps, VE предлагает альтернативную ментальную модель: вместо управления тысячами лёгких потоков – работа с очень длинной, единой векторной инструкцией, поддержанной мощным потоком памяти и традиционными HPC-инструментами OpenMP/MPI. Первый подход похож на управление огромной фабрикой рабочих. Второй – на очень длинную и предсказуемую автоматизированную производственную линию.
Ограничения архитектуры
VE не стал массовым стандартом рынка, и причина не в слабости архитектуры, а в масштабе экосистемы. CUDA превратилась в фактический язык ускоренных вычислений: вокруг неё выросли библиотеки, профилировщики, облачные сервисы и огромное сообщество разработчиков. У VE своя, гораздо более нишевая программная среда.
Второе ограничение – узкая специализация. Векторная архитектура сильна там, где данные представимы длинными однородными потоками. Но значительная часть современных нагрузок это графовые алгоритмы, разреженные модели, событийно-ориентированные системы, трансформеры с постоянно меняющимися оптимизированными ядрами – устроена гетерогенно, и здесь масштаб экосистемы GPU обычно перевешивает элегантность длинной векторной инструкции.
Третье – стоимость переноса. Старые Fortran-коды научных институтов могут очень удачно перенестись на SX-Aurora. Новому проекту нужно оценивать не только скорость отдельного бенчмарка, но и наличие библиотек, готовых контейнеров, специалистов и облачного доступа. Производительность одного теста редко компенсирует слабую интеграцию в существующий рабочий процесс.
Заключение: Почему эта архитектура всё ещё важна
Ценность NEC Vector Engine не в конкретных цифрах спецификации, а в самой идее, которую эта архитектура иллюстрирует: производительность определяется тем, насколько устройство соответствует форме задачи, а не количеством ядер или заявленными терафлопс на бумаге.
VE показывает жизнеспособную альтернативу модели “GPU для всего”. Он наследует полувековой опыт классических векторных суперкомпьютеров NEC SX, но упаковывает его в привычную Linux-инфраструктуру с x86-хостом, PCIe-подключением, HBM2-памятью, DMA-передачей данных и стандартными для HPC инструментами OpenMP и MPI. Даже в эпоху доминирования GPU в задачах ИИ такая архитектура продолжает предлагать собственный, целостный ответ на главный вопрос вычислительной техники – как не дать быстрым арифметическим блокам простаивать в ожидании данных из памяти.