


Google представила DiffusionGemma-26B-A4B-it — диффузионная модель для генерации текста с 4-кратным приростом скорости

Введение
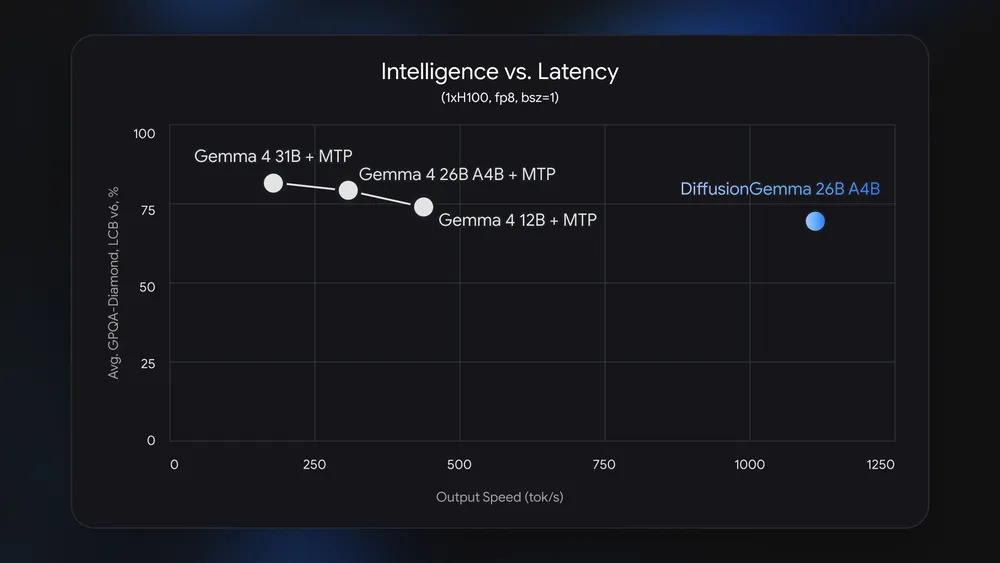
Google DeepMind объявила о выпуске DiffusionGemma — экспериментальной открытой модели объемом 26 миллиардов параметров, впервые применяющей диффузионный подход к генерации текста в семействе Gemma. Вместо последовательного вывода токенов, как это делают авторегрессионные модели вроде стандартной Gemma 4, DiffusionGemma создает целые блоки по 256 токенов за один прямой вывод, итеративно удаляя случайный шум и превращая его в осмысленный текст. Такой подход дает 4-кратный выигрыш в скорости генерации при локальном инференсе: более 1000 токенов/с на одном NVIDIA H100 и более 700 токенов/с на потребительской GeForce RTX 5090. Веса модели выложены под лицензией Apache 2.0 на Hugging Face
Подробнее о DiffusionGemma-26B-A4B-it
Новинка базируется на архитектуре Mixture of Experts с 26 миллиардами общих параметров, из которых во время инференса активны лишь 3,8 миллиарда. После квантования модель умещается примерно в 18 ГБ видеопамяти, что делает ее доступной как на мощных потребительских видеокартах, так и на полноценных ИИ-ускорителях. Основное преимущество DiffusionGemma раскрывается именно при локальном развертывании на одном ускорителе и небольшом размере пакета, тогда как в облачных системах с высоким параллелизмом авторегрессионные модели по-прежнему эффективнее утилизируют железо.
Основа DiffusionGemma-26B-A4B-it — новый диффузионный блок, разработанный на основе исследований Gemini Diffusion. Процесс генерации напоминает работу диффузионных моделей для изображений: стартовая точка — последовательность случайных токенов, затем несколько итераций очистки, на каждой из которых правильные токены фиксируются и служат контекстом для исправления остальных. Финальный проход выдает готовый блок текста. Двунаправленное внимание позволяет каждому токену взаимодействовать со всеми остальными в пределах 256-токенового окна, что дает преимущество в задачах, где результат зависит от нелинейных связей: редактирование текста, исправление кода, работа с математическими графами или последовательностями аминокислот.
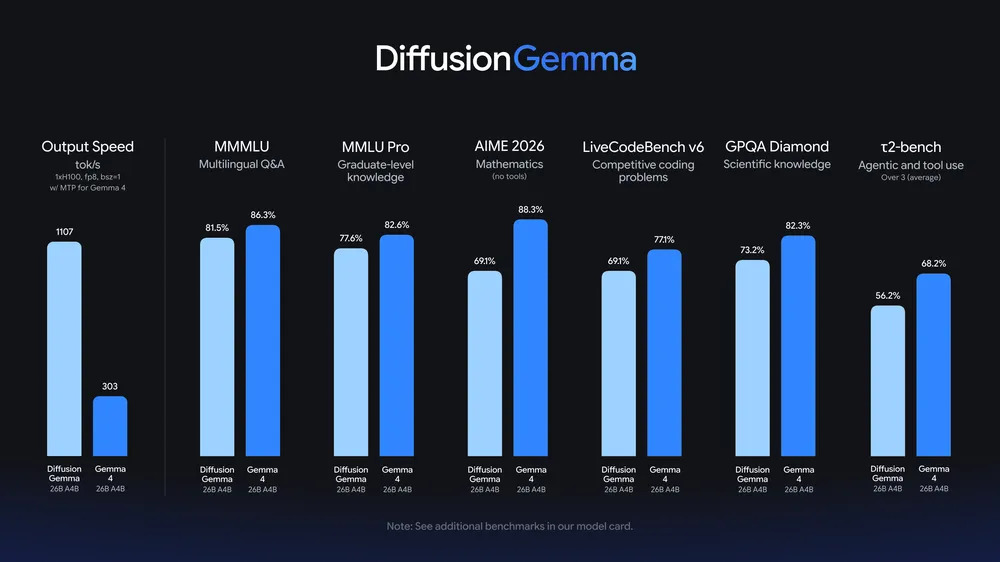
Скорость модели впечатляет: более 1000 токенов/с на H100 и более 700 токенов/с на RTX 5090, что в 4 раза быстрее классических авторегрессионных моделей сопоставимого размера. Такой рывок достигнут за счет переноса декодирования с пропускной способности памяти на вычислительные ресурсы, то есть модель не простаивает в ожидании подгрузки весов, а непрерывно считает, обрабатывая сразу большой кусок текста. Пользователь видит результат как печатный станок, штампующий целые абзацы, а не как пишущую машинку, выводящую по одному символу.
Расплатой за скорость служит снижение качества генерации по сравнению со стандартной Gemma 4. В Google прямо заявляют: DiffusionGemma — экспериментальный проект, ориентированный на максимальную интерактивность локальных рабочих процессов, редактирование, быструю итерацию и нелинейные текстовые структуры; для продакшен-задач, где важна безупречная точность, по-прежнему рекомендуется использовать Gemma 4. При этом заложенный в модель механизм итеративной самокоррекции — она видит весь блок целиком и правит ошибки в реальном времени, что частично компенсирует потери качества, а тонкая настройка под конкретную область способна вывести результат на конкурентный уровень.
Веса модели уже доступны на Hugging Face. Разботать с нейронкой можно через MLX, vLLM с поддержкой от Red Hat, Hugging Face Transformers, а скоро и через llama.cpp. Для любителей тонкой настройки Google опубликовала руководство по файнтюну с использованием Hackable Diffusion — модульного набора на JAX, спроектированного для компонуемости. Особый акцент сделан на оптимизации под ускорители NVIDIA: модель поддерживает 4-битное квантование NVFP4, которое повышает производительность вычислений без заметной потери точности, и протестирована на потребительских GeForce RTX 5090 и 4090, корпоративных Hopper и Blackwell, включая десктопные системы DGX Spark и DGX Station, а также на RTX PRO для AI-специалистов.
Выводы
DiffusionGemma — первая масштабная попытка перенести диффузионную генерацию с изображений на текст без оглядки на традиции авторегрессии, и этот эксперимент вполне можно назвать удачным: 1000+ токенов в секунду на H100 и 700+ токенов в секунду на RTX 5090 обеспечивает далеко не каждая классическая LLM. Конечно, модель не заменит классические LLM, но она открывает нишу, где время отклика критичнее максимальной точности: живые редакторы кода, инструменты для совместной работы в реальном времени, генерация нелинейных структур. Полностью открытая лицензия дают сообществу карт-бланш на исследование и доработку, а тесная интеграция с экосистемой NVIDIA и популярными фреймворками превращает новинку в готовый инструмент для некоторых продакшн-сценариев.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год