


Инференс Qwen3.5 на AMD Halo Box — руководство от AMD

Введение
Совсем недавно AMD анонсировала Halo Box — новейший ИИ-ПК на базе Ryzen AI Max+ 395, а если точнее, то прямой ответ на доминацию Nvidia DGX Spark на рынке домашних инференс-систем. Конечно, это далеко не первое решение на базе топового APU от AMD, но если ранее ассортимент был представлен в основном китайскими поставщиками Minisforum или Beelink, то теперь красные единолично выходят на сцену, чтобы не дать Хуангу полностью приватизировать этот рынок. В честь такого знакового события, AMD решила выпустить подробный гайд по инференсу локальных LLM семейства Qwen3.5 на ИИ-ПК с чипами Ryzen AI Max+ 395, который мы сегодня не менее подробно разберем по полочкам.
Что под капотом у AMD Halo Box
Разбор гайда не был бы полноценным без анализа начинки AMD Halo Box, но сильно распинаться об этом мы не этом не будем — в нашем блоге мы уже ни раз подробно рассказывали о характеристиках этого передового APU-чипа Ryzen AI Max+ 395, который и определяет все ключевые параметры AMD Halo Box, не считая ввода-вывода. Вместо этого, мы напрямую сравним характеристики AMD Halo Box с его главным конкурентом в лице Nvidia DGX Spark:
|
Характеристика |
AMD Halo Box |
NVIDIA DGX Spark |
|
Процессор (CPU) |
AMD Ryzen AI Max+ PRO 395, 16 ядер/32 потока, Zen 5 |
NVIDIA GB10 Grace Blackwell Superchip 20-ядерный ARM (10x Cortex-X925 + 10x Cortex-A725) |
|
GPU |
Radeon 8060S (RDNA 3.5), 40 вычислительных блоков |
Blackwell, 6144 ядер CUDA, 384 тензорных ядер 5-го поколения |
|
NPU |
XDNA 2 NPU до 50 TOPS |
– |
|
Основная память |
128 ГБ LPDDR5X-8000, 256 ГБ/с |
128 ГБ LPDDR5X-8533, 273 ГБ/с |
|
Сеть |
1x 2.5GbE RJ-45 |
1x 10GbE RJ-45, 2x 200GbE QSFP28 ConnectX-7 Smart NIC |
|
Хранилище |
2x M.2 2280 PCIe 5.0 (макс. 8 ТБ) |
1x M.2 2242 PCIe 5.0 NVMe (макс. 4 ТБ) |
|
Производительность INT8 |
126 TOPS |
500 TOPS (со структурной разряженностью) |
|
Производительность FP4 |
– |
1000 TOPS (со структурной разряженностью) |
|
Цена |
$3 999 |
$4 699 |
Как мы видим, ситуация весьма неоднозначная. По аппаратным характеристикам оба ИИ-ПК идут более менее ровно, но в ИИ-производительности дело принимает совершенно иной оборот. Дело в том, что нативным форматом вычислений Nvidia DGX Spark является FP4, и благодаря Blackwell-оптимизациям компактный ИИ-бокс обеспечивает производительность в колоссальные для такого устройства 1000 TOPS, но только со структурной разряженностью — на самом деле, реальная производительность DGX Spark достигает 500 TOPS, но и такой уровень весьма неплох.
Также аппаратная поддержка FP4 открывает доступ к использованию мощных движков инфернса, вроде vLLM или внутренних систем Nvidia. В INT8 ситуация не такая радужная, но производительность в 250 TOPS без структурной разряженности тоже смотрится весьма неплохо. У AMD Halo Box поддержки режима FP4 нет, поэтому запускать нейронки придется только в INT8, где ИИ-ПК обеспечивает умеренную производительность в 126 TOPS, которая складывается из NPU с 50 TOPS, GPU с 66 TOPS и CPU с 10 TOPS. Ввиду этого, работать с ИИ придется через движок инференса llama.cpp или его производные, вроде LM Studio или, как в случае с этим гайдом, Ollama, сжимая веса LLM и запуская активации в FP16.
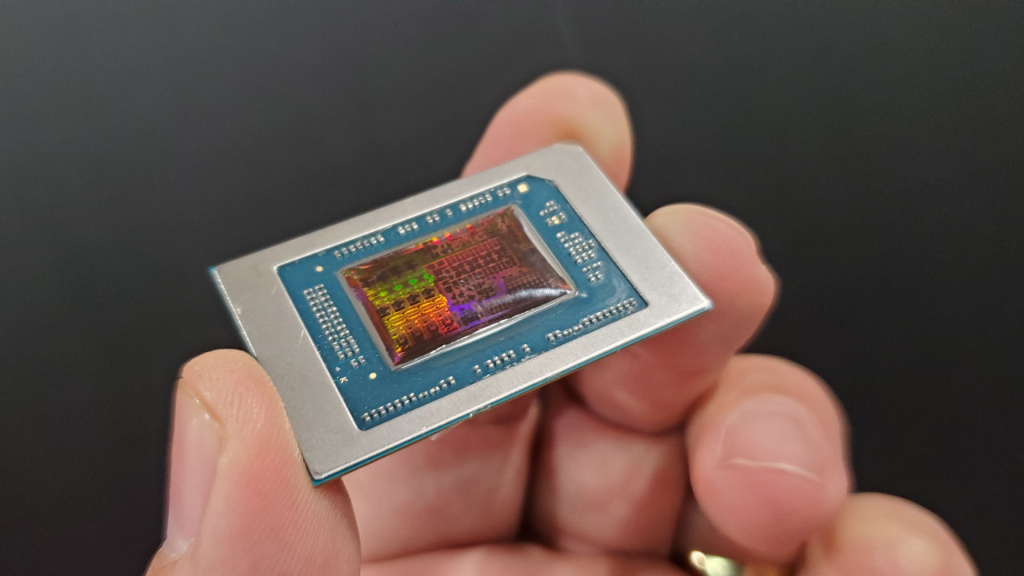
Интересный факт: В отличие от GB10, где Nvidia просто по отработанной схеме слепила CPU Grace и GPU Blackwell, архитектура AMD Ryzen AI Max+ PRO 395 более сложна и включает сразу 3 компонента, что может негативно сказываться на общей эффективности чипа, но отражает ставку AMD на свои APU-технологии, но это просто лирическое отступление.
Унифицированная память
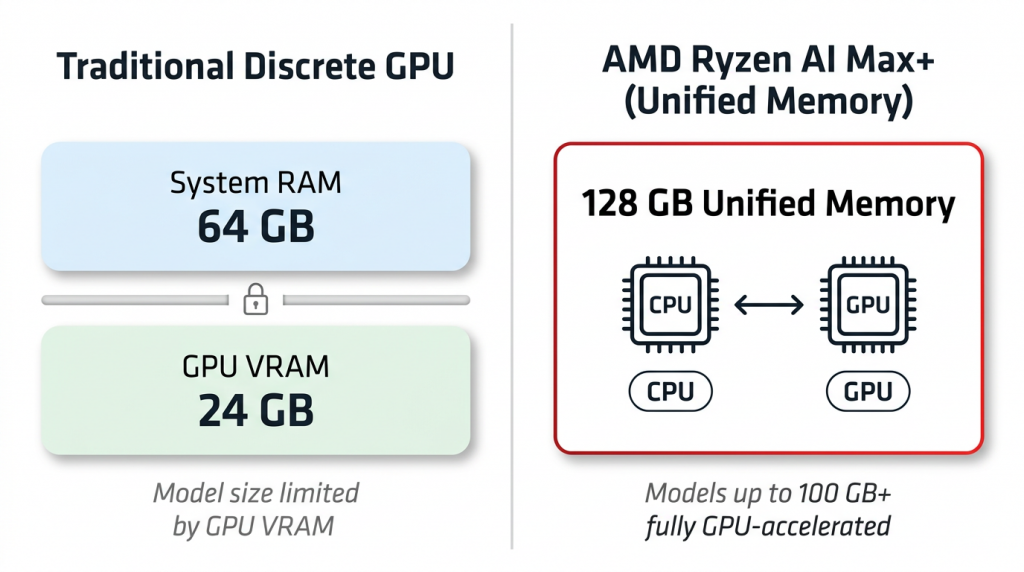
AMD делает большой акцент на том, что чип AMD Ryzen AI Max+ PRO 395 поддерживает 128 ГБ унифицированной памяти LPDDR5X, и это очень важный момент, ведь именно благодаря ей инференс нейросетей на AMD Halo Box вообще возможен в принципе.
Концепция унифицированной памяти предполагает, что все вычислительные компоненты (CPU+GPU+NPU) имеют общий доступ к пулу оперативной памяти в 128 ГБ. Вместо того, чтобы загружать веса модели отдельно в небольшой объем графической памяти GPU, как это происходит в дискретных видеокарта, в Halo Box нейронка обрабатывается в большом пуле из 128 ГБ быстрой оперативки LPDDR5X, благодаря чему на компактном ИИ-ПК можно запускать даже крупные 100b-модели, над инференсом которой будет трудиться и GPU, и CPU, и NPU одновременно. Вы также можете настроить через BIOS объем унифицированной памяти, выделяемый непосредственно для GPU (до 64 ГБ), чтобы гибко распределять ресурсы системы между компонентами в зависимости от текущих задач.
ПО стэк AMD
У прожженных ИИ-энтузиастов уже успел сложиться стереотип, что инференс через AMD ROCm — это сплошные мучения. На CUDA все всегда было просто — на стэке Nvidia работало буквально все, от нейронок до движков и инструментов оптимизации, без каких-либо заморочек и долгих ручных настроек. У AMD все было куда хуже — ROCm ассоциировался с постоянными багами, ошибками, небольшим ассортиментом функций, да и поддержка нейронок оставляла желать лучшего. Так было два года назад, но сейчас все изменилось — ROCm окреп и стал действительно достойным противником CUDA, проблем стало в разы меньше, и в целом ПО-стэк красных уже фактически стал Plug-n-Play решением. Эта же тенденция сохраняется и на AMD Halo Box — некоторые нюансы с ROCm, конечно, остались, но в сравнении с былыми временами, это небо и земля, так что не переживайте — при настройке актуальной версии ROCm 7.2.1 под инференс моделей Qwen3.5 волосы у вас точно не поседеют.
Руководство по инференсу Qwen-3.5 на AMD Halo Box
В рамках руководства AMD компания предлагает выполнять инференс через движок Ollama версии 0.20.x, который считается самым простым в развертывании и эксплуатации локальных моделей. Очевидно, что на AMD Halo Box можно накатить и другие движки инференса, но поскольку все ИИ-ПК ориентированы в первую очередь на начинающих ИИ-энтузиастов и массового пользователя, которые не хотят заморачиваться с командной строкой и предпочитают работать в приятном веб-интерфейса, AMD сразу предлагает начать работу в Ollama. Конечно, это может оттолкнуть юзеров, желающих получить от логического вывода максимальную гибкость, но им ничего не мешает накатить голую llama.cpp или тот же SGLang, поэтому ИИ-бокс AMD Halo придется по вкусу абсолютно всем, особенно с учетом более демократичного прайса, чем у DGX Spark.
Так вот, для начала нужно накатить на систему Ollama. AMD рекомендует выполнять установку на ОС Ubuntu 24.04 LTS — это не самая актуальная версия дистрибутива Linux, однако она наиболее стабильна, поэтому большинство инференс-станций работают именно на ней. Ничто не мешает вам поставить Ubuntu 26.04 LTS, но если начнутся баги — пеняйте на себя. Как только вы убедились, что система готова, введите команду curl -fsSL https://ollama.com/install.sh | sh.
Убедитесь, что загрузка прошла успешно, после чего можно приступать к установке моделей. В рамках гайда AMD будет тестироваться инференс моделей Qwen3.5 со стандартным квантованием Q4_K_M: 9b, 35b и 122b версии. Для их установки введите команды:
- ollama pull qwen3.5:9b
- ollama pull qwen3.5:35b
- ollama pull qwen3.5:122b
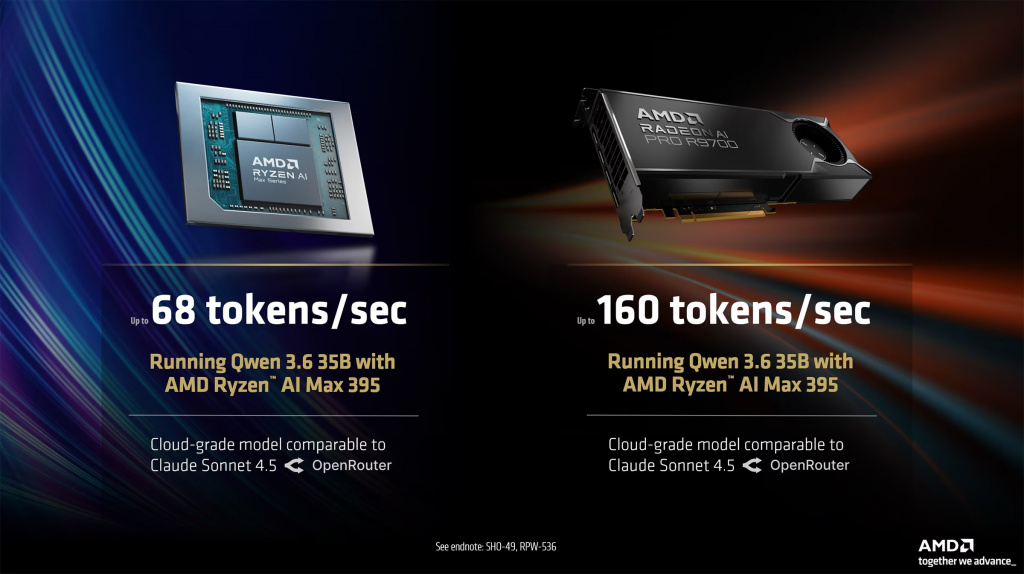
Как вы уже знаете, на рынок вышли более актуальные модели Qwen 3.6 от Alibaba, однако среди них отсутствуют решения свыше 100 миллиардов параметров и компактные решения менее 10 миллиардов параметров. Именно поэтому AMD остановила свой выбор на предыдущем поколении LLM, чтобы показать эффективность Halo Box в разных весовых категориях нейронок. Тем не менее, ничто не мешает вам накатить на Halo Box более актуальные ИИ-модели — в своей недавней статье AMD уже приводила данные со скоростью 68 токенов/с при инференсе Qwen 3.6-35B на AMD Ryzen AI Max+ PRO 395.
После установки нейросетей, запустите их командами:
- ollama run qwen3.5:9b
- ollama run qwen3.5:35b
- ollama run qwen3.5:122b
Само собой, запускать модели одновременно не нужно — выберите нейросеть, которую хотите использовать, и выполните команду run. Чтобы убедиться, что модели запущены на GPU, выполните команду ollama ps. После ввода должна отобразиться запущенная модель и загрузка графического процессора на 100%. Также AMD рекомендует отслеживать использование памяти графическим и центральным процессором в процессе инференса с помощью команды rocm-smi.
А теперь давайте ознакомимся с результатами инференса этих трех моделей на Halo Box, которые приводит компания AMD:
|
Модель |
Общие Параметры |
Активные Параметры |
Потребление памяти |
Скорость генерации |
|
Qwen3.5 9B |
9B Dense |
9B |
6,2 ГБ |
29,84 Токенов/с |
|
Qwen3.5 35B-A3B |
35B MoE |
3B |
20,5 ГБ |
42,04 Токенов/с |
|
Qwen3.5 122B-A10B |
122B MoE |
10B |
76 ГБ |
8,59 Токенов/с |
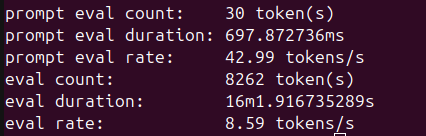
AMD уделяет особое внимание инференсу большой модели Qwen3.5 122B-A10B, отмечая, что даже не при максимальной загрузке графического процессора (61% производительности от GPU и 39% от CPU т.к. модель не помещается в выделенную память), Halo Box все же смог запустить крупную LLM, хоть и с весьма незаурядной скоростью в 8,59 Токенов/с, при использовании MoE-активаций и, по всей видимости, настройки контекстного окна, параметры которой AMD не раскрывает. Но если не брать в расчет сам факт того, что модель “просто запустилась”, то эффективность инференса больших LLM на Halo Box никуда не годится — APU-чип буквально не вывозит столь крупные нейронки в поддерживаемых режимах вычислений. С этим разобрались, но как дела обстоят у DGX Spark? Давайте сравним результаты инференса тех же нейронок на обоих ИИ-боксах:
|
Модель |
Скорость AMD Halo Box |
Скорость Nvidia DGX Spark |
|
Qwen3.5 9B |
29,84 Токенов/с |
108,88 Токенов/с |
|
Qwen3.5 35B-A3B |
42,04 Токенов/с |
60 Токенов/с |
|
Qwen3.5 122B-A10B |
8,59 Токенов/с |
29,7 токенов/сек |
Само собой, инференс Nvidia DGX Spark выполнялся в режиме NVFP4, что и обеспечило превосходство в скорости генерации токенов над AMD Halo Box даже в развертывании крупной модели Qwen3.5 122B-A10B. Кроме того, более простая архитектура чипа GB10 позволяет ему более эффективно расходовать системные ресурсы и управлять памятью, поэтому отрыв в токенах весьма велик. Тем не менее, моделей с поддержкой NVFP4 не так много, а на решениях AMD можно запускать фактически любые нейросети, которые помещаются в 128 ГБ VRAM, при этом стоимость ИИ-бокса красных на $700 дешевле, чем у аналогичного решения зеленых.
Выводы
Подводя итоги, можно уверенно сказать, что AMD Halo Box — это вполне себе неплохой ИИ-ПК, который может составить достойную конкуренцию Nvidia DGX Spark, причем, не только по цене, но и по производительности. Да, запуск больших LLM 100+ миллиардов параметров не может похвастаться скоростью, зато на инференсе MoE-нейронок с 35b параметрами или легких плотных нейросетей с 9b параметрами решение показывает достойную для своего класса производительность. Добавьте к этому то, что AMD довела до ума свой ПО-стэк ROCm, и у вас получится практически идеальное Plug-n-Play с легким запуском движком и нативным процессом развертывания локальных LLM. AMD Halo Box отлично подойдет для систем локального агентного инференса или даже агентных роев — вы можете спокойно запускать сразу несколько легких нейронок до 9b (в идеале с MoE), подключить их hermes-системе по типу OpenClaw и позволить нейронкам автоматизировать ваши рутинные задачи. Да, сейчас перекос по ИИ-эффективности все-таки склоняется в сторону Nvidia, но это ненадолго, ведь компания AMD уже анонсировала новое поколение APU-чипов AMD Ryzen AI Max+ PRO 400 Gorgon Halo, которые обеспечат поддержку до 192 ГБ унифицированной памяти LPDDR5X-8533 с возможностью выделения 160 ГБ для GPU, что обеспечит кратный прирост производительности следующего поколения ИИ-ПК. А с учетом того, что у Nvidia пока что нет аналогичного по характеристикам решения в том же сегменте рынка, в будущем у AMD будут все шансы стать лидером в сегменте компактных инференс-станций.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год