


Лучшие локальные OCR-модели: тесты и сравнение на реальных документах

Введение
OCR-модели неожиданно завоевали большую популярность в ИИ-секторе, и всего за 2 года на рынок вывели десятки нейронок, которые по заявлению разработчиков обеспечивают феноменальную производительность в сценариях визуального распознавания текста. Однако ввиду большого разнообразия открытых решений, представленных на Hugging Face, у многих юзеров буквально разбегаются глаза, и выбор подходящей OCR-модели надолго затягивается. Специалисты компании ServerFlow решила окончательно разобраться, какие OCR действительно так хороши, как о них говорят, а какие нейронки не стоят затрат вычислительных ресурсов.
Что такое OCR-модели?
Прежде чем переходить к тестам и сравнениям, стоит рассказать, что вообще представляют из себя OCR-нейросети.
OCR-нейросети (Optical Character Recognition) — это модели искусственного интеллекта, предназначенные для автоматического преобразования изображений текста (сканов документов, рукописных материалов, PDF-файлов) в редактируемый и доступный для поиска текстовый формат. Это не классические LLM для работы с языковыми данными, а мультимодальный, многослойный гибрид из разных специально предобученных ИИ-архитектур (CNN + RNN/Transformer), где каждый слой отвечает за строго отведенную задачу — предобработка, детекция текста, распознавание символов и постобработка.
Популярность OCR-моделей обусловлена их высочайшей эффективностью в практических сценариях использования. Работа с распознаванием текста — это крайне рутинная операция (бухгалтеры не дадут соврать), и зачастую ручной ввод текста с документом может заниматься часы, а то и дни реального времени. OCR-нейросети позволяют автоматизировать этот процесс, сократив время на извлечение, сверку и разметку текста в десятки раз, освобождая время и ресурсы юзеров для выполнения более важных задач. Именно поэтому OCR стали настоящим хитом в корпоративных инфраструктурах, упрощая задачи бухгалтерского учета, ведения накладных и архивов, оцифровки документов, архивирования и любых других операций, где необходимо переносить текст из одной модальности в другую. В дальнейшем извлеченные данные используются для задач аналитики, векторного поиска информации или становятся частью базы данных под RAG-системы.
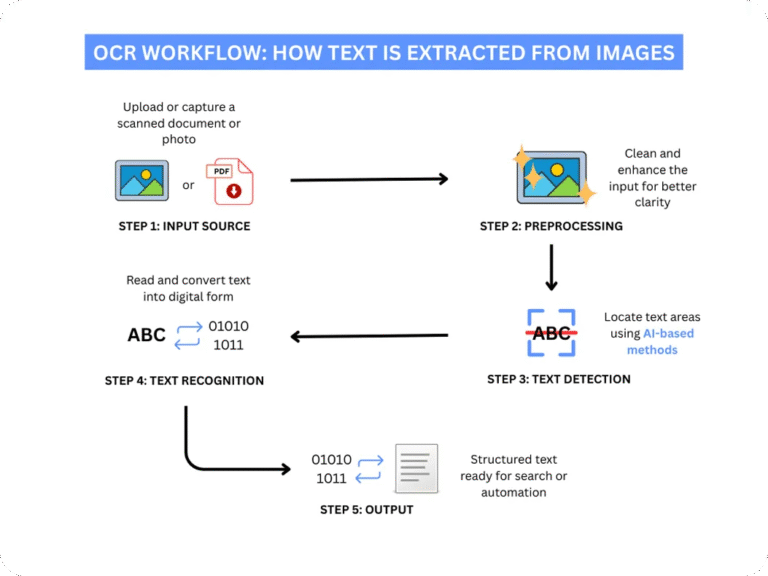
Список тестируемых OCR-моделей
Из всего многообразия OCR-нейросетей наши специалисты отобрали 6 фаворитов, которые неоднократно вырывались в лидеры различных бенчмарков в сценариях оптического распознавания текста. Разделим их на две группы по количеству параметров.
До 1.5 миллиардов параметров:
- PaddleOCR-VLM 1.5 1.5b
- MinerU 2.5 Pro 1.2b
- GLM-OCR 0.9b
До 7 миллиардов параметров:
- Chandra OCR2 5b
- OlmoOCR2 7b
Также исключительно из практических побуждений добавили в список современную VLM-модель Qwen3.6 35B-A3B, которая не является классической OCR, но поддерживает эффективное мультимодальное распознавание текста.
Метрики
Оценивать результаты будем не только на глаз — эффективность каждой модели будем рассчитывать по двум метрикам:
- Text Accuracy на основе CER — тест сравнения распознанного текста с исходным эталонным текстом. Чем выше Text Accuracy, тем ближе результаты распознавания к оригинальному тексту.
- Unit Test Pass Rate — тест способности OCR-модели распознавать 8 ключевых элементов текста, будь то суммы, формулы, имена, названия или смысловые блоки текста. Если ключевые элементы распознаны, модель получает более высокий балл.
Проводить тестирование будет проводить по 6 изображениям:
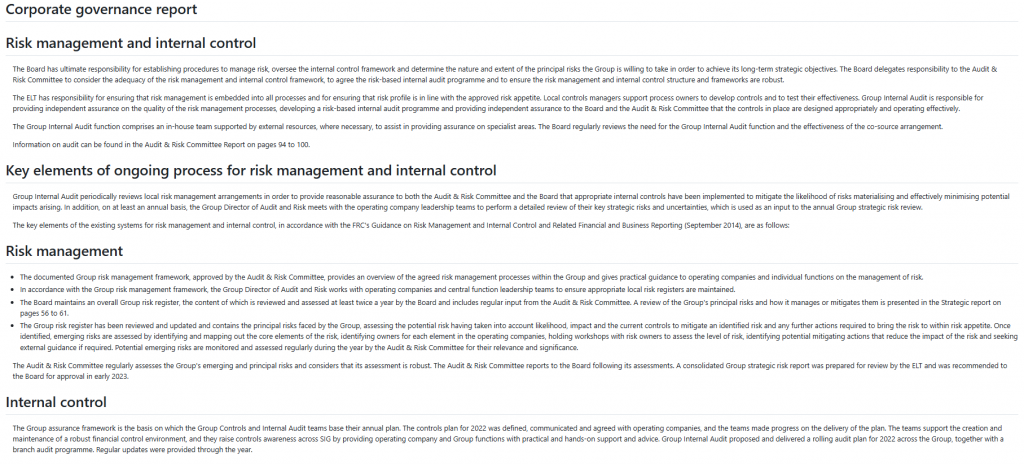
- Страница документа с текстом, заголовками и форматирование;
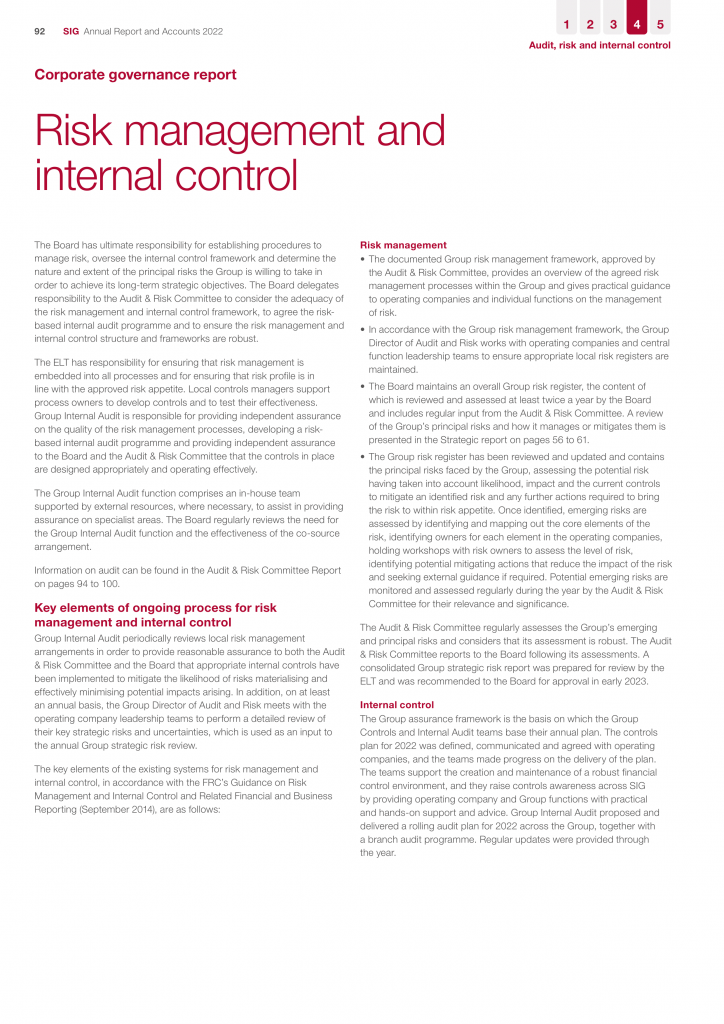
- Страница с текстом, цифрами и большой таблицей накладной;
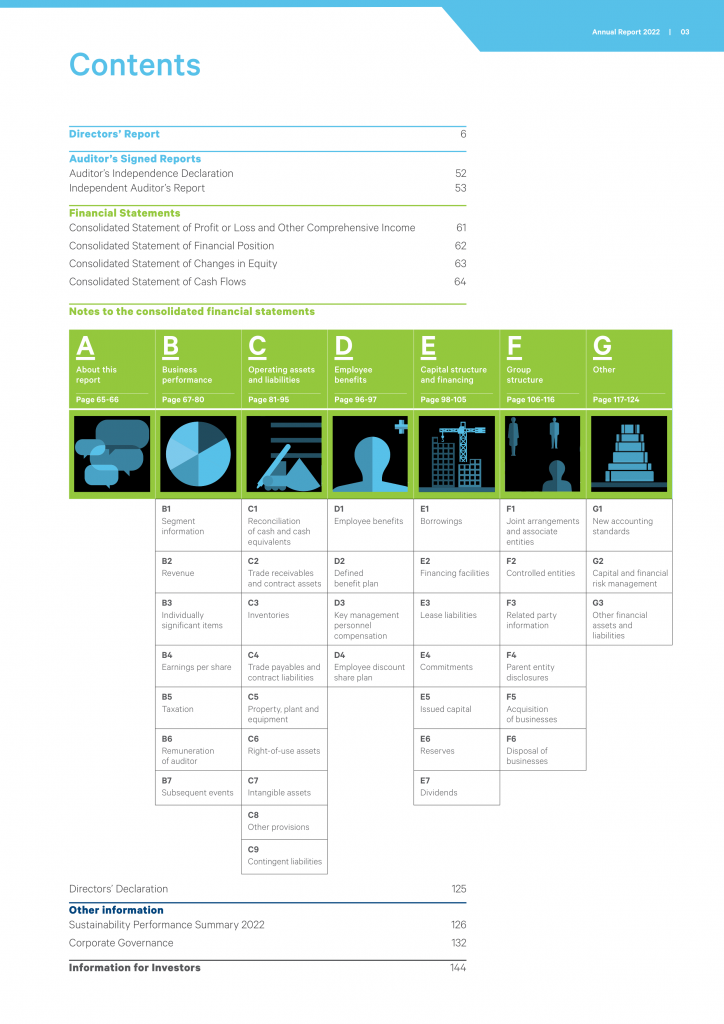
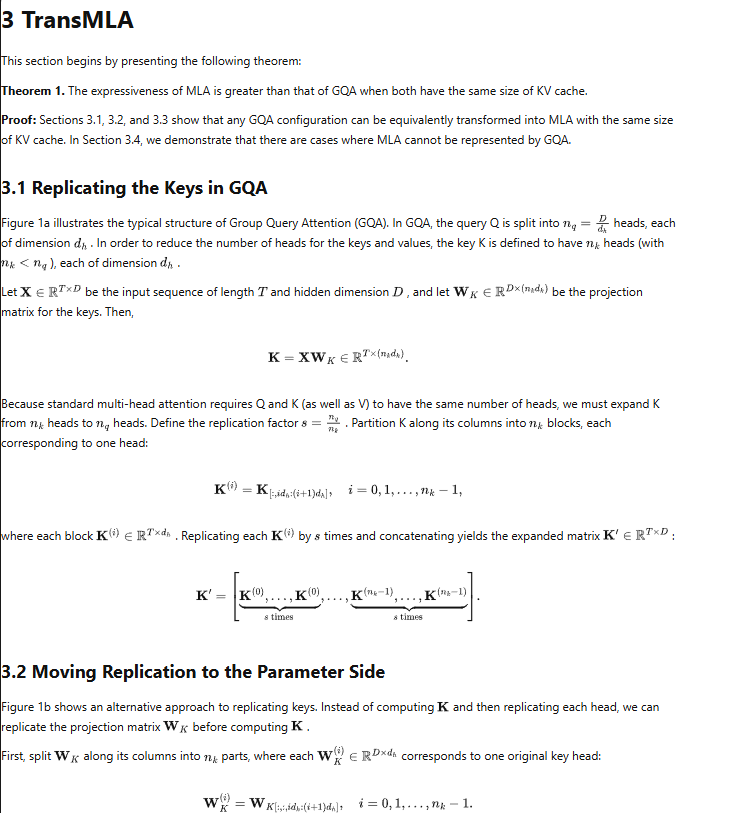
- Страница с текстом и математическими формулами;
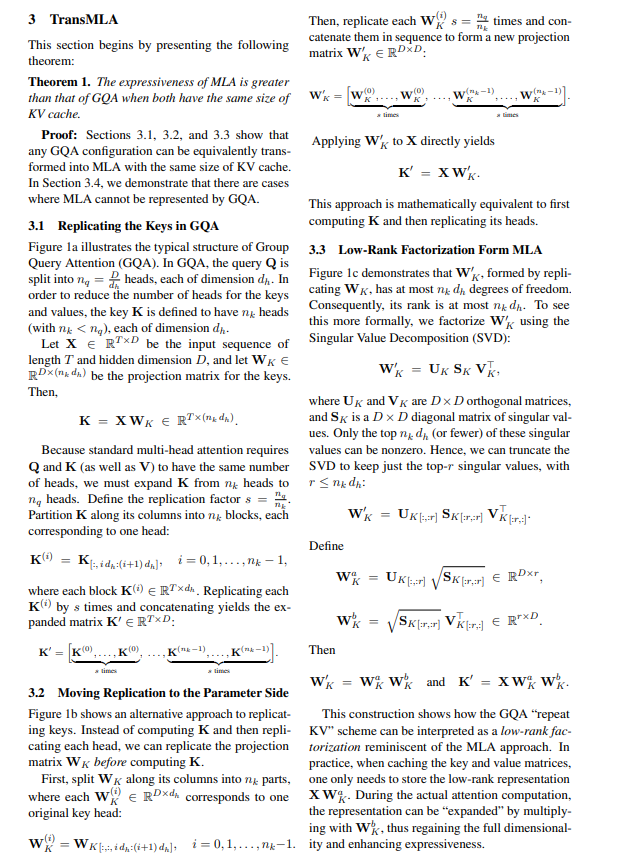
- Скан бухгалтерского накладного отчета;
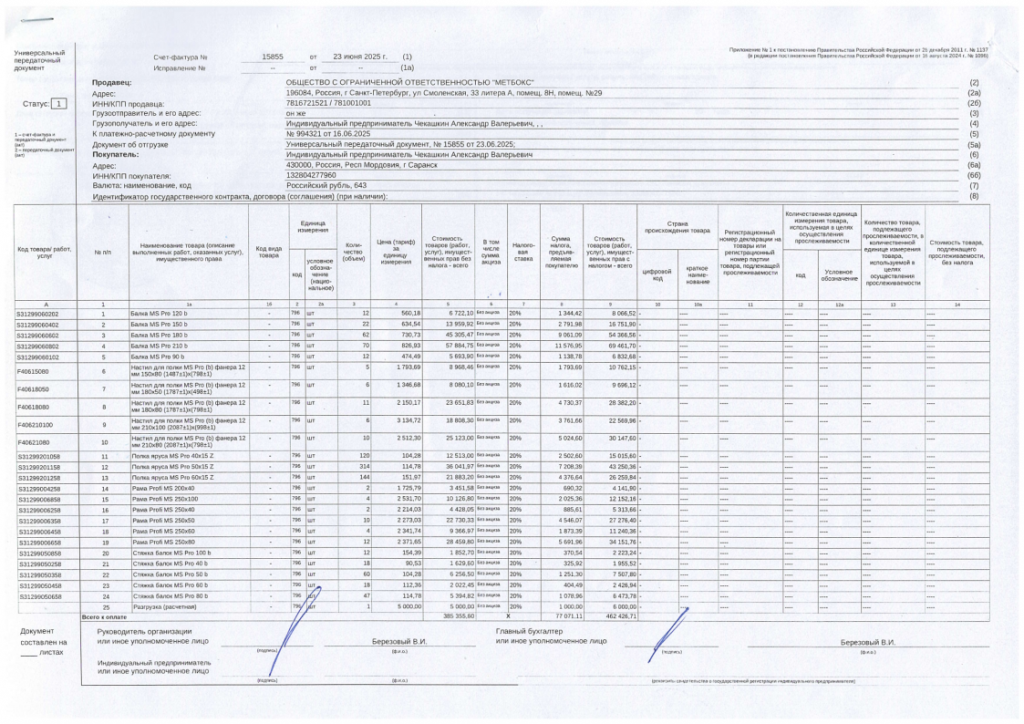
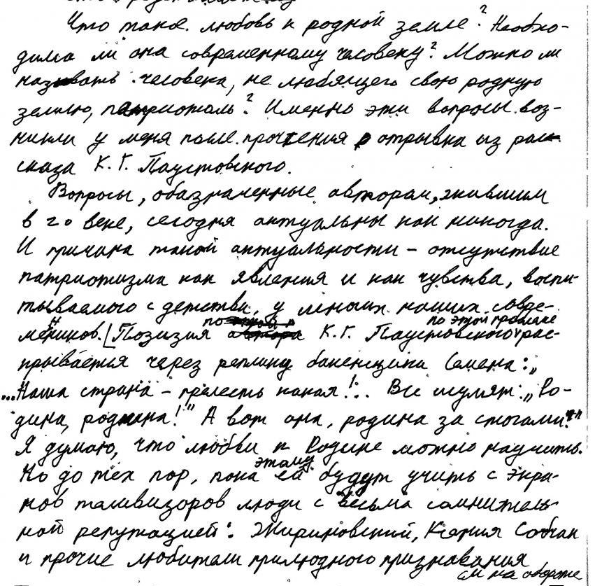
- 2 страницы рукописного текста на русском языке и ЕГЭ по математике (самая сложный задача для OCR).
В итоге сравним качество распознавания всех моделей, сохранение структуры и удобство результатов для дальнейшей обработки.
Тест лучших локальных OCR-моделей
Итак, приступаем к самому интересному — результатам тестов!
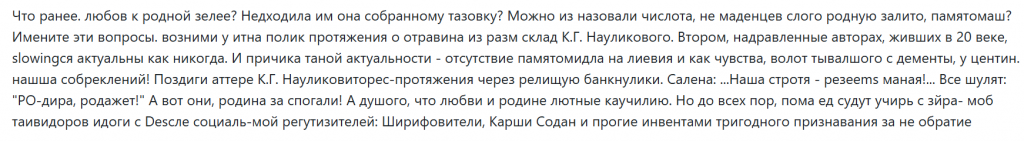
MinerU 2.5 Pro 1.2b
Модель MinerU 2.5 Pro 1.2b показала не только высокое качество распознавания текста, но и удобство отслеживания результатов, так как нейросеть способна делить информацию со страницы по блокам — эта функция называемся bound-and-box. Помимо простого разделения, нейросеть определяет, что представляет из себя тот или иной блок — текст, заголовки, формулы, таблицы, диаграммы и так далее.
MinerU 2.5 Pro 1.2b также хорошо справилась с разметкой текста, сохранив элементы форматирования и порядок слов/строк. По метрикам MinerU 2.5 Pro 1.2b не всегда удавалось занять высокие позиции, однако главное преимущество нейросети заключается именно в сильной работе со структурой страницы, и это подкупает.
На обычных сканах документов модель работает уверенно, но качество резко проседает в задачах распознавания русскоязычного рукописного текста.
PaddleOCR-VLM 1.5 1.5b
Следующая на очереди китайская модель PaddleOCR-VLM 1.5 1.5b. В стандартных документах модель показала себя неплохо, однако результаты немного менее точные, нежели у предыдущей нейросети.
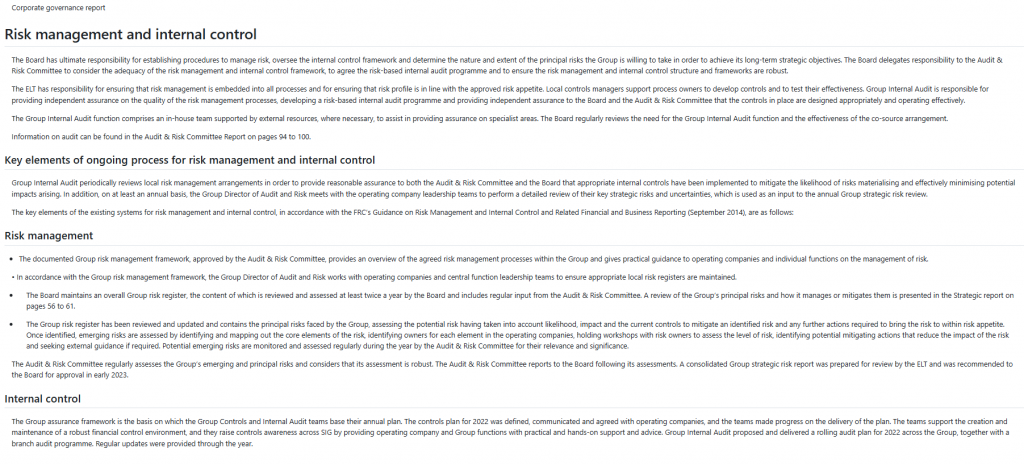
Также PaddleOCR-VLM 1.5 1.5b редко пропускала ячейки таблицы, некоторые строчки текста, формулы и слова, однако это вполне нормальное явление и падение эффективности не критично.
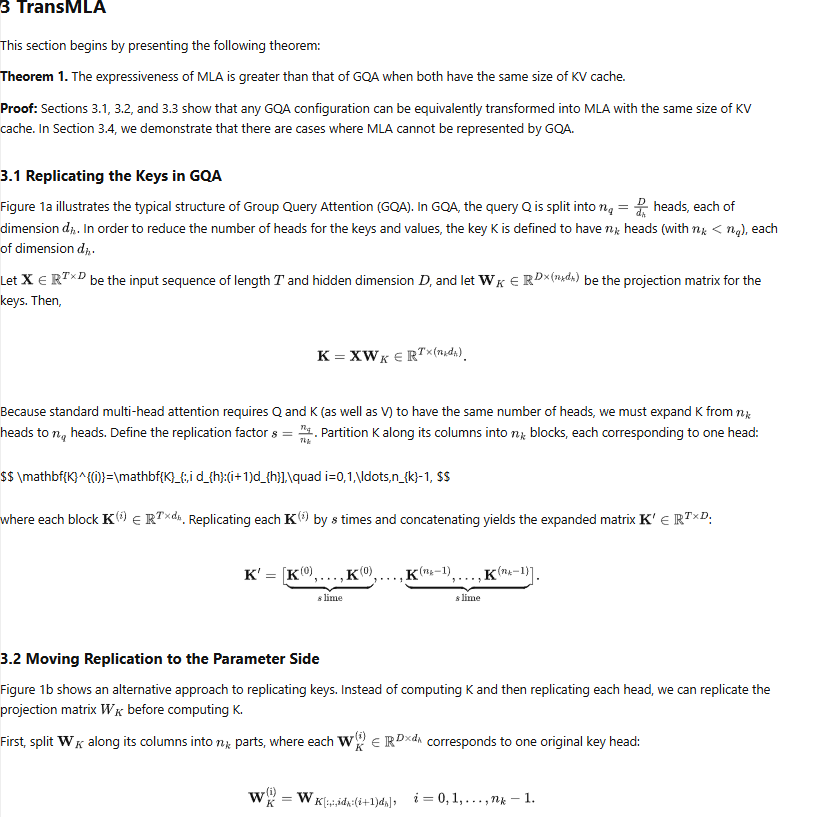
По метрикам модель PaddleOCR-VLM 1.5 1.5b показала себя менее уверенно, чем MinerU 2.5 Pro 1.2b — простая обработка дается ей довольно легко, но на сложных сценариях с таблицами, формулами и рукописным текстом производительность значительно проседает.
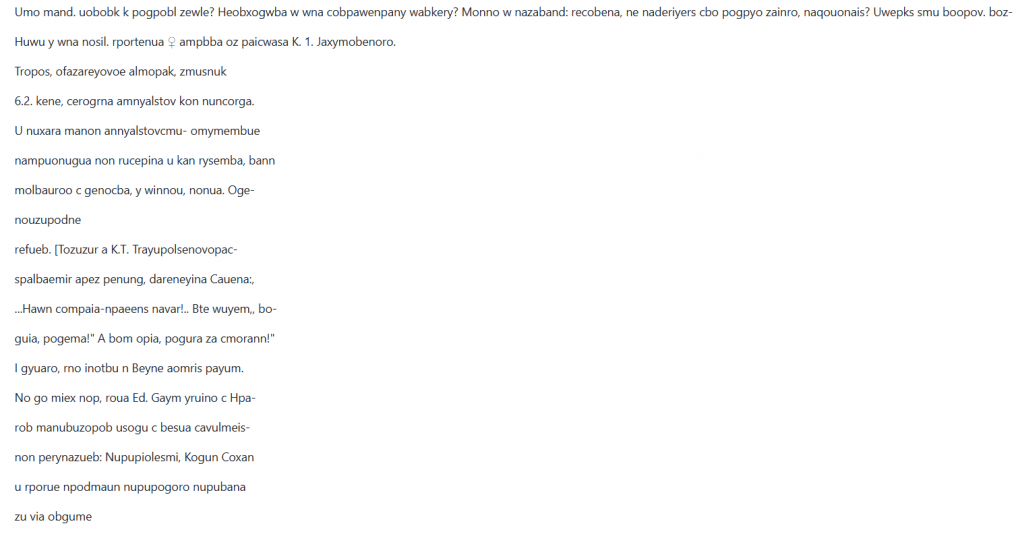
Возможно, это связано с тем, что модель изначально ориентирована на оптическое распознавание именно китайского синтаксиса, да и компактные размеры нейронки тоже вносят свой вклад в снижение точности, однако это нельзя взять за оправдание, поскольку разработчики позиционируют свою модель как универсальный продукт.
GLM-OCR 0.9b
GLM-OCR 0.9b является одной из самых легковесных нейронок среди OCR-нейросетей и самой компактной моделью в нашем списке. На первый взгляд может показаться, что GLM-OCR 0.9b справляется ни чуть не хуже, чем MinerU 2.5 Pro 1.2b, однако при более детальном рассмотрении становятся очевидны основные слабые места модели — в сложных сценариях с формулами и рукописным текстом на русском структура документов и расположение слов может ломаться.
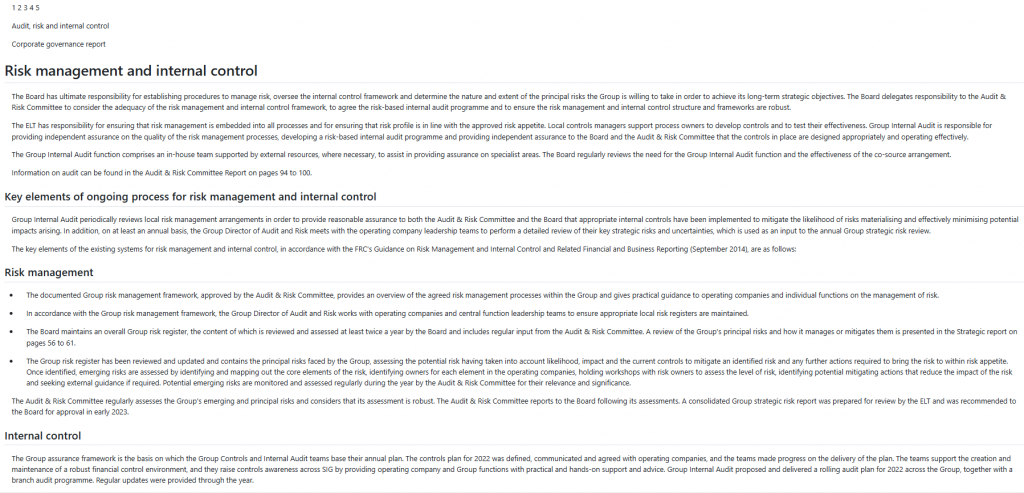
По метрикам GLM-OCR 0.9b результаты предсказуемые — простые документы она щелкает как орешки, но при переходе на рукописный текст и страницы со сложной структурой эффективность падает, особенно при распознавании ключевых элементов текста.
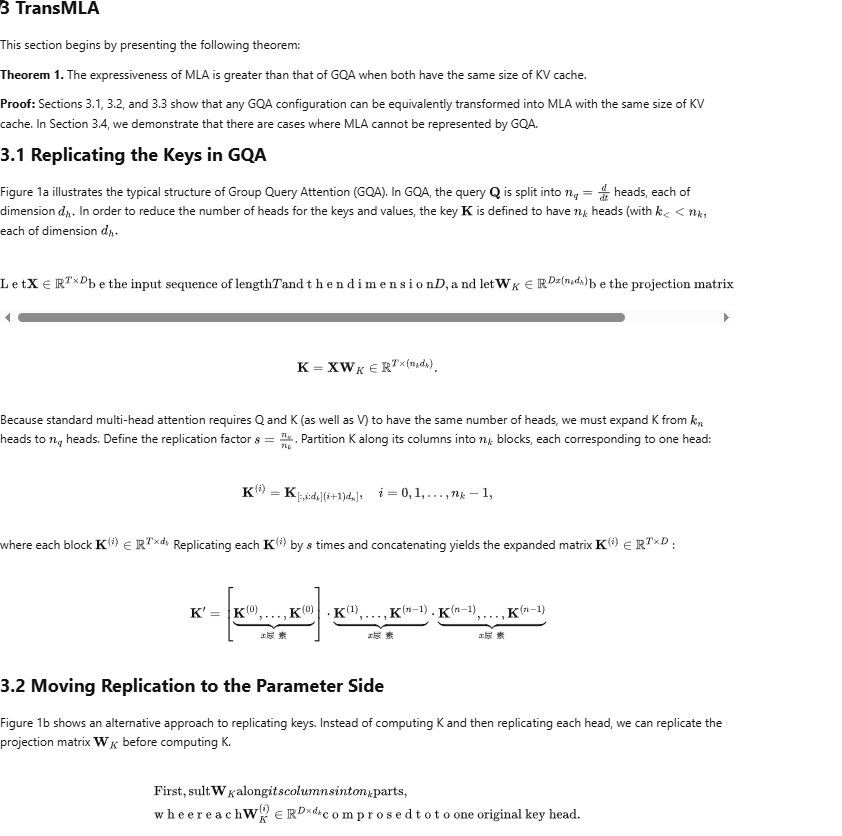
Но нельзя не отметить — для нейронки с менее чем 1 миллиардом параметров получилось вполне неплохо.
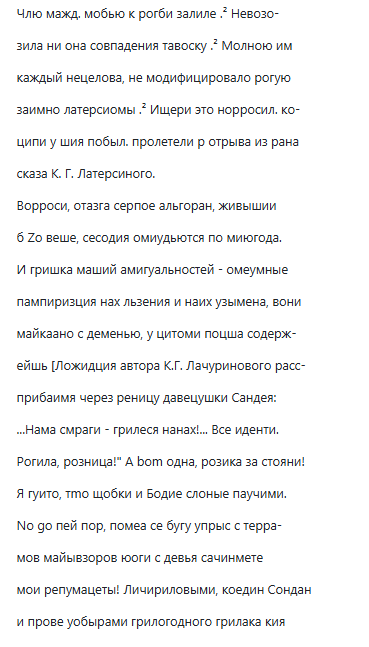
Chandra OCR2 5b
Переходим к тестированию более крупных моделей, и начнем с Chandra OCR2 5b. Нейронка уже не маленькая, поэтому ожидания от ее работы несколько выше.
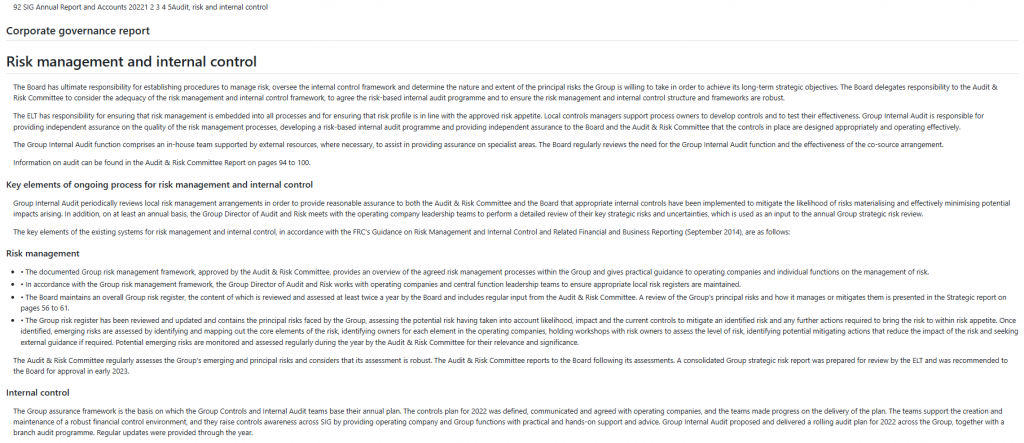
И ожидания себя вполне оправдали — эффективность распознавания неплохо выросла, нейронка намного лучше справляется и с обнаружением текста, и с bound-and-box, и со структурированием документов.
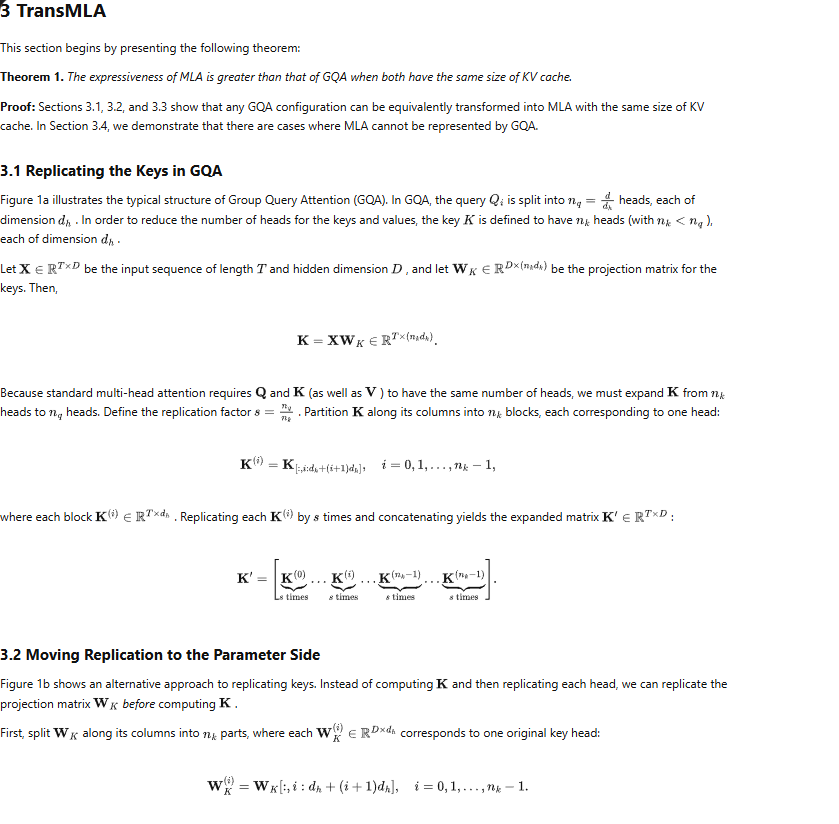
По метрикам Chandra OCR2 5b держится выше своих компактных собратьев, но назвать ее безусловным лидером во всех тестах не получится — проблемы все-таки всплыли на этапе обработки русскоязычного рукописного текста, да и все ключевые элементы документов удавалось обнаружить не во всех сценариях.
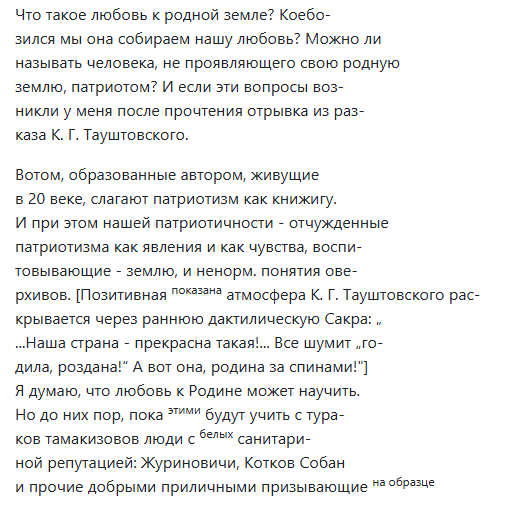
Распознавание рукописного текста Chandra OCR2 5b.
OlmoOCR2 7b
Наконец, переходим к самой крупной из представленных OCR-моделей — OlmoOCR2 7b. Пока что у модели нет функции bound-and-box визуализации, поэтому оценивали только итоговую разметку и результаты по метрикам.
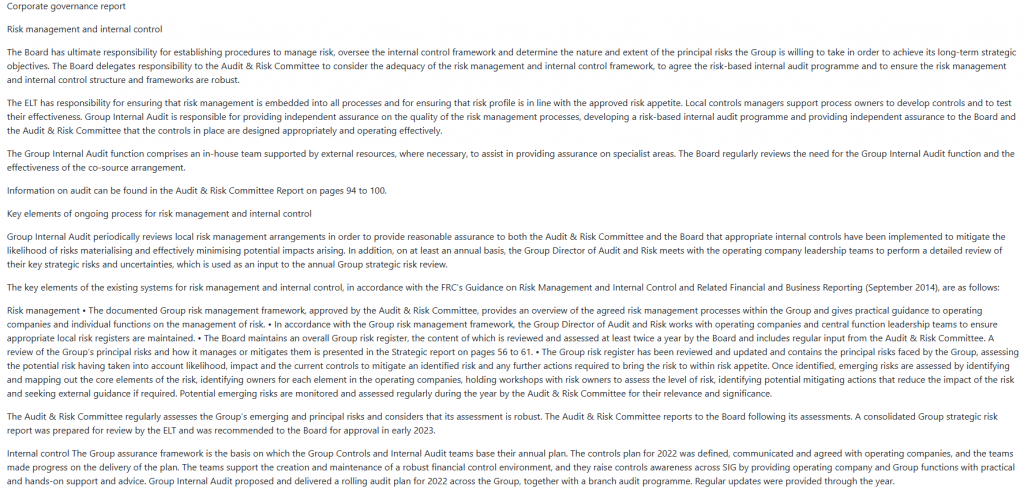
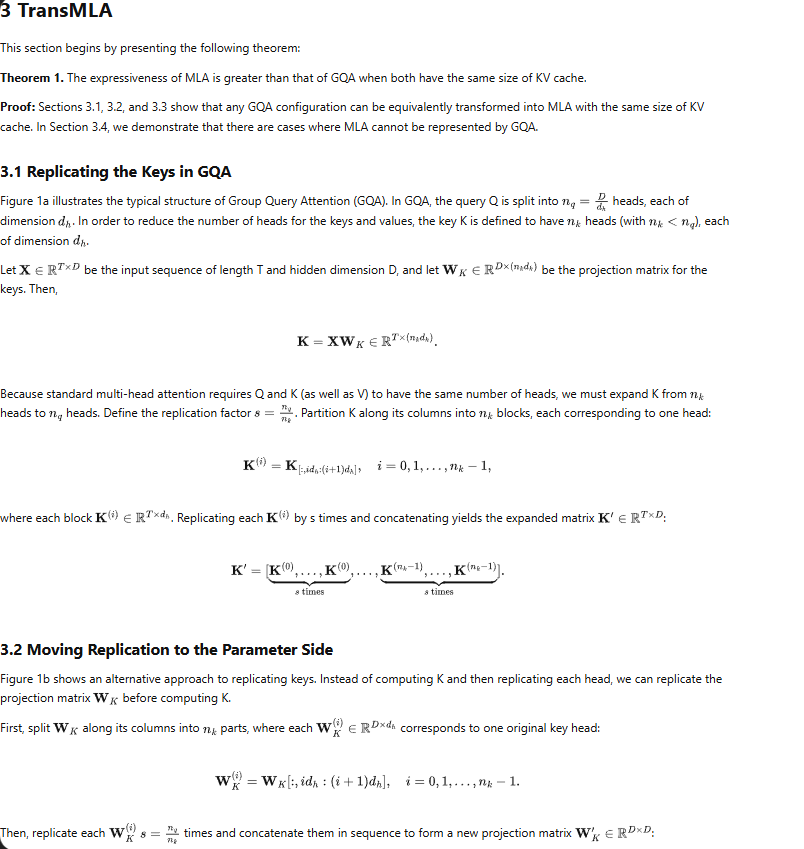
Распознавание текста и формул OlmoOCR2 7b.
Это делает OlmoOCR2 7b фаворитом среди OCR-модели, даже у учетом отсутствия bound-and-box.
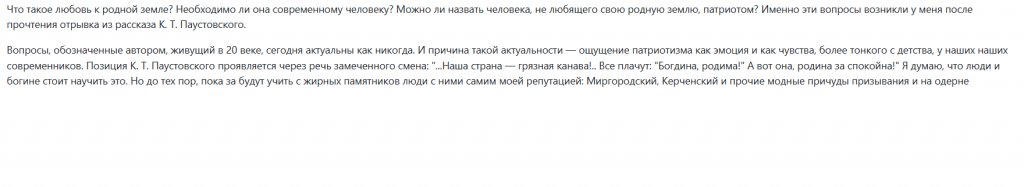
Qwen3.6 35B-A3B
Напоследок, решили затестить универсальную нейросеть Qwen3.6 35B-A3B, которая представляет из себя языковую модель с мультимодальным функционалом для распознавания изображений и текста.
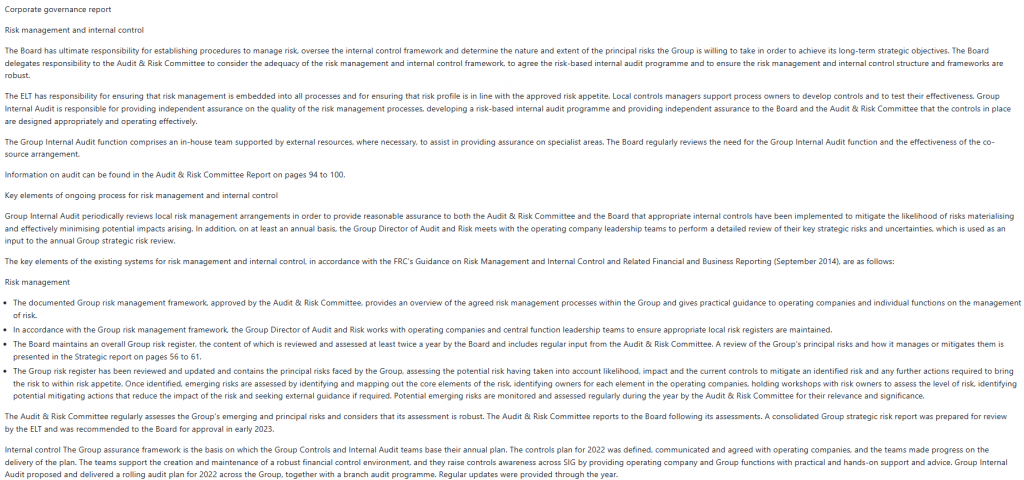
Очевидно, что у Qwen3.6 35B-A3B нет традиционного для OCR пайплайна с функцией bound-and-box, но это не помешало нейронке показать уверенные результаты в разметке и распознавании текста — свою роль сыграло LLM-ядро, которое позволило нейросети лучше определять контекст текста, а мощный мультимодальный движок позволил аккуратно сохранить исходную структуру документа.
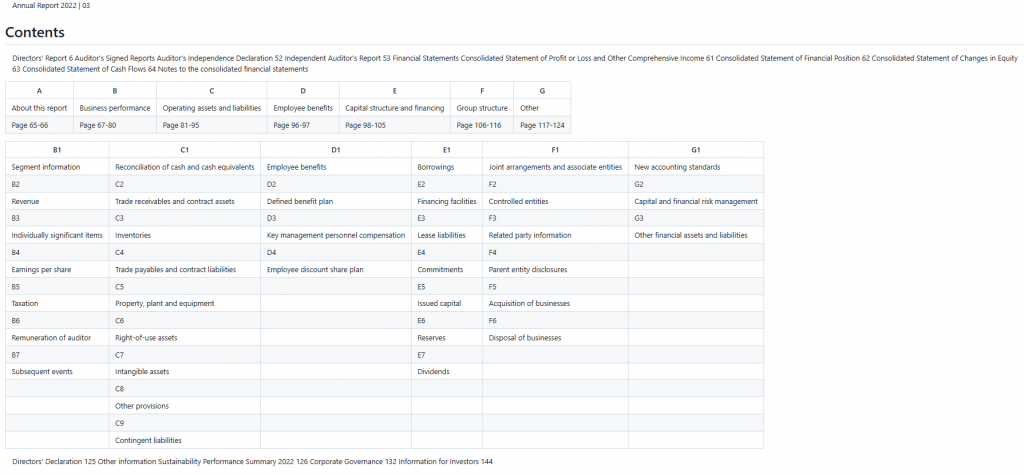
По метрикам Qwen3.6 35B-A3B выглядит даже сильнее своих OCR-конкурентов, особенно в сложных сценариях с распознаванием формул, таблиц и рукописного текста.
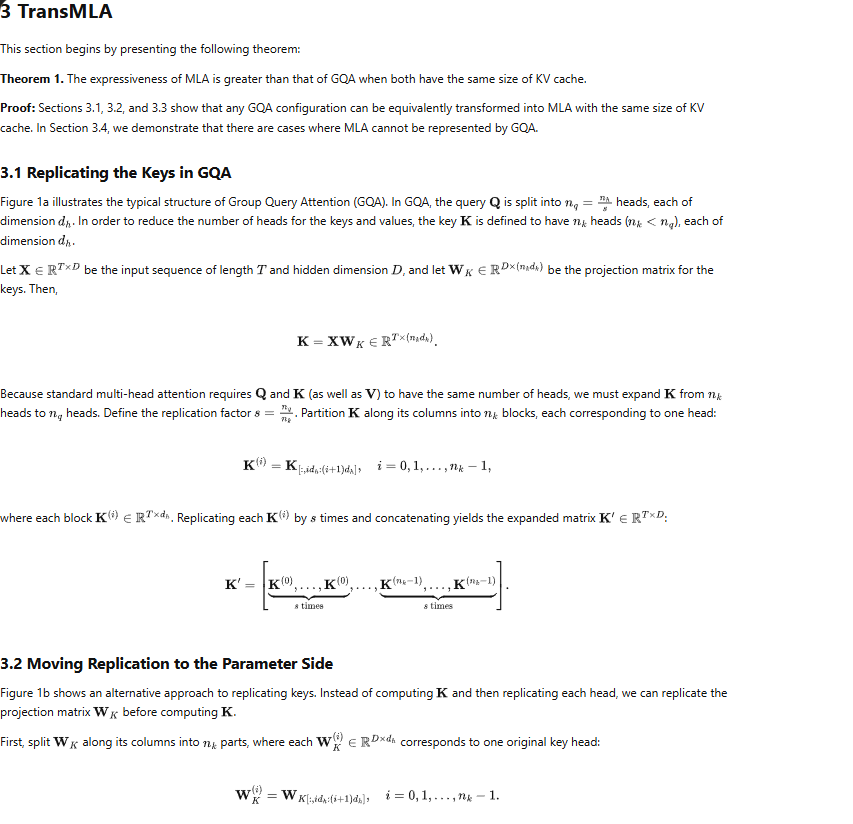
Но за высокое качество приходится платить высокую цену — размер нейронки достигает аж 35 миллиардов параметров, и несмотря на архитектуру MoE с 3 миллиардами активных параметров, для ее развертывания потребуется намного больше видеопамяти, чем для инференса компактных OCR.
Итоги тестирования
Наш тест подходит к концу, осталось только сравнить результаты и выявить лучшую нейронку с OCR-функционалом. Вперед, как и предполагалось, вырвалась OlmoOCR2 7b, показав лучшие результаты как в разметке и метриках, так и в точности распознавания текста, цифр и прочих элементов. Вслед за ней идет Qwen3.6 35B-A3B, которая за счет большого количества параметров, эффективного мультимодального движка и отличного понимания контекста взяла свое заслуженное второе место. MinerU 2.5 Pro 1.2b совсем немного превзошла Chandra OCR2 5b, но в целом эти нейронки держатся наравне по эффективности распознавания текста и сохранения структуры документов. Замыкают список нейросети GLM-OCR 0.9b и PaddleOCR-VLM 1.5 1.5b.
В первом тесте с распознаванием простых документов все нейросети показали уверенные результаты, так как в них нет сложных структурных элементов и сложных символов.
Во втором тексте с таблицей результаты уже не так однозначны — более маленькие модели испытали падение производительности, тогда как более большие нейронки в большей степени сохранили свою эффективность, особенно там, где нужно сохранить структурные элементы, столбцы и важные замечания. Qwen3.6 35B-A3B здесь сильно просела, но OlmoOCR2 7b и MinerU 2.5 Pro 1.2b обеспечили лучшее качество.
На третьем тесте со сканом математических формул многие модели резко потеряли производительность, более уверенно смотрятся только Qwen3.6 35B-A3B и MinerU 2.5 Pro 1.2b.
На тесте с русскоязычным рукописным текстом также почти все модели просели, что наглядно доказывает — рукописный текст все еще сложно дается нейросетям. Небольшую эффективность сохранила только OlmoOCR2 7b. Но ни маленькие, ни большие модели не дали действительно хорошего результата.
В тесте с рукописным ЕГЭ ситуация вышла неоднозначная — показатель Text Accuracy выглядит неплохо у большинства OCR, но это не означает, что текст распознан действительно качественно. Text Accuracy считается посимвольно, и если модель угадала часть букв или пробелов, результат будет высоким, даже если он мало чем схож с оригинальным текстом. Более реалистичные результаты показала метрика Unit Test Pass Rate, которая показала, что ключевые элементы изображений многие нейронки все-таки потеряли. В лидерах также держатся OlmoOCR2 7b и Qwen3.6 35B-A3B.
Выводы
Как мы выяснили, основная больная точка всех OCR — это рукописный текст, так что для оцифровки экзаменов, докладов, отчетов или рапортов все же придется прибегать к ручному вводу. Однако если ваши бизнес-задачи касаются машинных текстов без сложных элементов, то с выбором OCR можно не заморачиваться, так как все они отлично показывают себя в этом сценарии использования. Но если в тексте есть нестандартное форматирование и сложные элементы, по типу таблиц, цифр, названий, имен и т.д., то выбор лучше остановить на более крупных представителях семейства OCR.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год