


NVIDIA CUDA vs AMD ROCm через призму практики

Введение: зачем вообще сравнивать CUDA и ROCm
На презентациях и в бенчмарках выбор между CUDA и ROCm выглядит простым: сравнили теоретическую производительность и цену видеокарт, посмотрели пару графиков – и готово. На практике всё упирается в другое: какие версии драйверов реально собираются, какие фреймворки запускаются без плясок с бубном, как ведут себя большие языковые модели под нагрузкой и что произойдет после первого обновления стека.
В этой статье мы смотрим на CUDA и ROCm через призму эксплуатации, а не чистых цифр. Разберёмся, из чего состоят стеки, чем они похожи и различаются, какие задачи на них сейчас решают, где появляется разница в скорости и надёжности и как подойти к выбору платформы через короткий пилот, а не через веру в рекламные слайды.
Что такое NVIDIA CUDA и AMD ROCm и в каких условиях их сравниваем
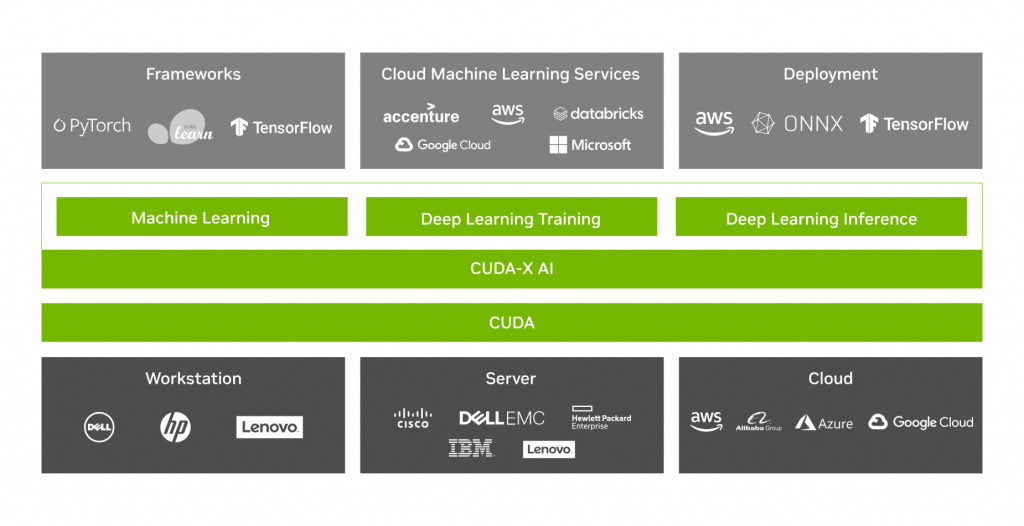
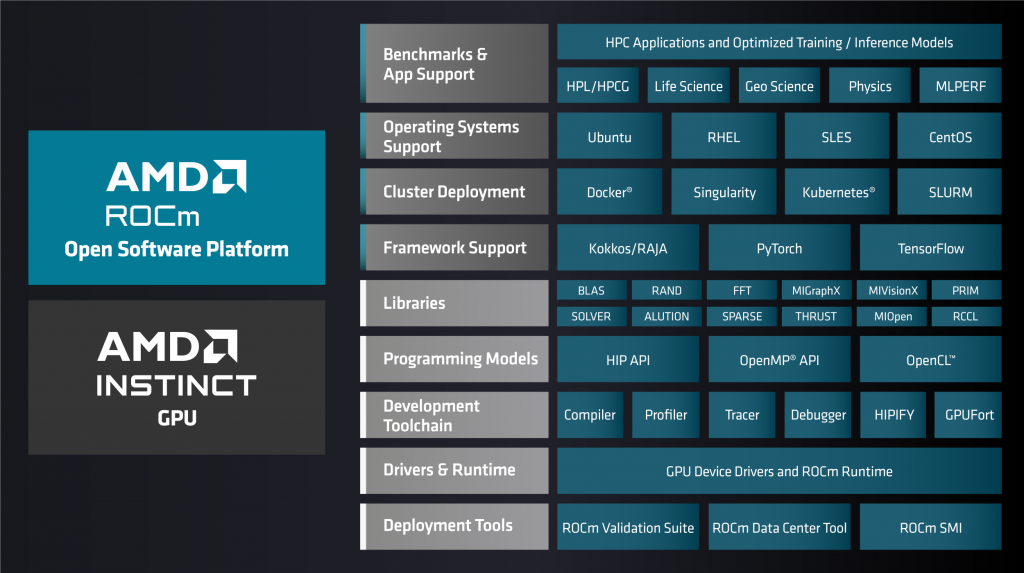
И CUDA, и ROCm – это не один драйвер и не библиотека, а целые экосистемы для вычислений на графических процессорах: компиляторы, библиотеки линейной алгебры и нейросетевых примитивов, средства для распределённых вычислений, профилировщики и готовые контейнеры. Однако есть одно краеугольное, идеологическое различие.
CUDA принадлежит NVIDIA и распространяется как закрытая платформа с проприетарными драйверами и библиотеками, полностью привязанная к их железу.
Совместимость: железо, системы, контейнеры
Какие GPU обычно используют под CUDA и ROCm
- Под CUDA чаще всего берут Volta V100, Ampere A100, Hopper H100/H200, а в ближайшие годы добавятся Blackwell B100/B200.
- Под ROCm основной упор идёт на Instinct MI50, MI100, MI200 и MI300 (в вариантах MI300X, MI300A, MI325X).
Операционные системы и драйверы
Контейнеры и Kubernetes
Стек NVIDIA и стек AMD: что из чего состоит
Ключевые элементы NVIDIA CUDA
- CUDA Toolkit: компилятор NVCC, базовые библиотеки, заголовки и примеры.
- cuBLAS: матричное умножение и линейная алгебра высокой производительности.
- cuDNN: свёртки, пулинг, нормализации и прочие примитивы для нейросетей – именно через него PyTorch и TensorFlow “общаются” с GPU.
- NCCL: коллективные операции для нескольких GPU и узлов, основа распределённого обучения.
- TensorRT: компиляция и оптимизация моделей для инференса.
- Nsight Systems/Compute: профилировка и поиск узких мест.
Ключевые элементы AMD ROCm
- HIP: языковой и программный слой, который позволяет писать код в стиле CUDA и собирать его под AMD.
- rocBLAS/hipBLAS: реализация линейной алгебры для GPU.
- MIOpen: свёртки и примитивы для нейросетей, аналог cuDNN.
- RCCL: коллективные операции для Instinct.
- rocProfiler и rocTracer: профилирование и трассировка.
- Готовые контейнеры ROCm с уже установленными PyTorch, vLLM и библиотеками.
Таблица совместимостей CUDA и ROCm
| CUDA компонент | ROCm аналог | Краткое описание |
|---|---|---|
| CUDA Toolkit | ROCm + HIP | Общий SDK и компилятор. |
| NVCC | hipcc | Компилятор GPU-ядер. |
| cuBLAS | rocBLAS / hipBLAS | BLAS для GPU. |
| cuDNN | MIOpen | Примитивы DL, свёртки. |
| NCCL | RCCL | Коллективные операции. |
| TensorRT | MIGraphX / vLLM-оптимизации | Инференс-оптимизация, зрелость ниже. |
| Thrust | rocThrust | Шаблоны параллельных алгоритмов. |
| Nsight Systems | rocProfiler | Высокоуровневый профилинг. |
| Nsight Compute | rocTracer | Низкоуровневая трассировка. |
| CUDA Graphs | HIP Graphs | Аналог графов выполнения. |
Эта таблица полезна, когда вы переносите существующий пайплайн с NVIDIA на AMD: почти у каждого элемента найдётся парный, но не всегда с одинаковой степенью зрелости.
Фреймворки и LLM-инструменты
PyTorch
На стороне CUDA PyTorch выглядит почти образцово: новые версии выходят в тесной связке с релизами NVIDIA, большинство операторов и объединённых ядер оптимизированы, а подавляющее большинство популярных моделей просто запускаются без дополнительного шаманства.
В связке с ROCm всё сложнее. Есть официальные сборки PyTorch с поддержкой ROCm, есть отдельные пакеты от команды ROCm. Для каждой версии ROCm существует ограниченный набор поддерживаемых версий PyTorch, и наоборот, поэтому матрицу совместимости приходится сверять каждый раз. Набор операторов закрывает основные сценарии, смешанная точность поддерживается, но иногда встречаются дыры: редкие слои без оптимизаций, падения при комбинации конкретных операторов, отсутствие некоторых объединённых ядер.
На практике это означает, что “завелось” и “стабильно крутится месяцами под нагрузкой” – разные этапы. Второй требует собственного пилота и нагрузочного теста именно с вашими моделями.
TensorFlow
TensorFlow исторически поддерживал и CUDA, и ROCm, но за последние годы основное внимание заметно ушло в сторону NVIDIA. Под CUDA это по-прежнему зрелое решение с предсказуемыми бинарными сборками и плотной интеграцией с cuDNN и XLA.
Под ROCm TensorFlow существует, но отстаёт по версиям и реже встречается в новых проектах. Ограничения те же: узкая матрица совместимости версий, меньше оптимизаций для новых операторов, необходимость чётко следовать рекомендациям AMD по настройке окружения. Поэтому под ROCm чаще выбирают PyTorch, а TensorFlow оставляют там, где он уже был развёрнут раньше.
vLLM, DeepSpeed, FSDP
Инструменты для работы с большими языковыми моделями развиваются особенно быстро.
- vLLM под CUDA поддерживается “из коробки”, официальные образы легко запускаются в Kubernetes. Под ROCm есть отдельные контейнеры и инструкции для MI300X, но список протестированных моделей пока гораздо уже.
- DeepSpeed на CUDA покрывает и экономию памяти, и сложные схемы вроде смеси экспертов, под ROCm поддержка частичная и требует внимательной проверки версий и патчей.
- FSDP в PyTorch поверх NCCL давно стал стандартом распределённого обучения, а поверх RCCL работает, но сильнее зависит от стабильности коммуникаций и качества ядер.
Общий вывод простой: с CUDA большинство инструментов уже сотрудничают “по умолчанию”, под ROCm же к каждому нужно подходить через документацию и отдельный тест.
Почему отличается производительность
Разрыв между CUDA и ROCm в типичных ИИ-нагрузках сейчас оценивают примерно в 10–30 процентов в пользу NVIDIA, тогда как ещё несколько лет назад он был существенно выше. На это влияет сразу несколько факторов:
- Качество и развитость библиотек линейной алгебры и свёрток: cuBLAS и cuDNN много лет оттачивают под конкретные архитектуры.
- Глубина поддержки форматов FP16, BF16, FP8 и 8-битных целых чисел в сочетании со специализированными тензорными ядрами.
- Объединение операций в более крупные ядра, сокращающее накладные расходы на их запуск.
- Эффективность NCCL и RCCL в многоузловых конфигурациях.
- Архитектурные отличия самих карт: объём и скорость HBM, внутренняя шина, наличие NVLink или его аналогов.
ROCm постепенно сокращает отставание за счёт оптимизаций под MI300X и новых версий библиотек, особенно в сценариях с упором на память и длинный контекст LLM. Но рассчитывать на идентичные цифры при прямом переносе пайплайна с тех же A100/H100 на MI300 без доработки всё ещё не стоит.
Отдельно стоит сказать про коммуникации. Пока вы ограничиваетесь одной картой, NCCL и RCCL почти не отличаются. При 8-16 GPU в узле и нескольких узлах в кластере начинаются нюансы: оптимальные схемы глобальной редукции, чувствительность к топологии сети, редкие зависания при больших размерах распределённой группы. Это одинаково верно и для CUDA, и для ROCm, но для ROCm таких “граничных случаев” пока больше.
Опыт разработки и переносимость
Если вы уже пишете собственные CUDA-ядра, закономерный вопрос – насколько реально переехать на ROCm. Здесь HIP и инструменты hipify действительно помогают: простой код, где вы запускаете несколько потоков и обрабатываете массивы, часто переносится почти автоматически.
Проблемы начинаются там, где в ход идут ручные оптимизации под конкретные поколения NVIDIA: специальные встроенные функции, сложное управление памятью, кооперативные группы, завязка на детали планировщика. Такой код придётся фактически переписывать и заново профилировать под архитектуру AMD.
Отладка и профилировка на обеих платформах обязательны, если вы хотите понимать, за что именно платите. Nsight в мире CUDA и rocProfiler/rocTracer в мире ROCm позволяют увидеть, где именно простаивает железо: в вычислениях, в памяти, в сети или на синхронизациях. Чем быстрее вы находите эти узкие места, тем дешевле обходится владение кластером.
Эксплуатация в датацентре
В продакшене основную боль обычно приносят не первые запуски, а обновления. И для CUDA, и для ROCm действует простое правило: не обновлять драйверы и библиотеки сразу на всём кластере. Всегда нужен тестовый контур и зафиксированные версии в манифестах, чтобы можно было быстро откатиться.
Наблюдаемость для обеих платформ одинакова по набору минимальных метрик. Важно видеть загрузку GPU и время простоя, использование видеопамяти, температуру и факты троттлинга, ошибки памяти и исправления ошибок, частоту падений процессов, пропускную способность и задержку 95/99-го процентилей для запросов, а также длину очередей. Без этого любое обсуждение что “CUDA быстрее” или “ROCm дешевле” превращается в обмен личными ощущениями.
По поддержке у NVIDIA сейчас преимущество: длинные циклы жизни драйверов, сертифицированные сборки от крупных вендоров, интеграция во все крупные облака и большой рынок специалистов. ROCm делает ставку на открытость и активно развивает образы и руководства под Instinct, но экосистема вокруг пока уже и требует большего участия вашей команды.
Риски и как выбирать
У CUDA главный минус – цена и зависимость от одного вендора. Серверные GPU NVIDIA обычно дороже аналогов AMD, а закрытость ключевых компонентов усложняет аудит и миграцию.
У ROCm другие уязвимости. Матрица совместимости “железо – ОС – ROCm – фреймворки” уже и строже, больше редких багов во фреймворках и инструментах для LLM, а многоузловые конфигурации требуют тщательного тюнинга.
Давайте упростим дерево решений до нескольких развилок:
- Нужен максимально широкий стек LLM и минимальное количество сюрпризов – логичнее брать CUDA.
- Критична стоимость владения и вы готовы инвестировать время в пилот и доводку – стоит посмотреть на Instinct + ROCm.
- Обучение на нескольких узлах – безопаснее стартовать с NVIDIA и параллельно вести пилот ROCm.
- Windows обязательна – практически автоматически остаётся CUDA.
- Нужен максимально прозрачный и открытый стек, а команда не боится разбираться в деталях – ROCm может дать интересный баланс контроля и цены.
Но, конечно, ничто лучше не покажет привлекательность того или иного решения, как практический опыт использования.
Мини-пилот на одну неделю
Чтобы не спорить на уровне теории, проще заложить короткий пилот и сравнить платформы на своих задачах.
Три минимальных шага такие.
- Установка и базовый контейнер: собрать образ с нужным стеком, проверить видимость GPU и работу PyTorch внутри.
- Тест инференса LLM: запустить vLLM с одной типичной моделью, замерить пропускную способность и задержку на реальных запросах и оставить под нагрузкой на несколько часов.
- Тест обучения или HPC: либо короткий прогон обучения модели среднего размера, либо типичный тест линейной алгебры/быстрого преобразования Фурье, в том числе на нескольких GPU или узлах.
Результаты фиксируем в простой таблице: конфигурацию, версии, команду запуска, ключевые метрики и обнаруженные риски. Через полгода по этой таблице можно будет воспроизвести эксперимент, оценить, как изменился стек, и принять уже осознанное решение: остаться на выбранной платформе, начать миграцию или запустить новый пилот на свежих релизах.
Заключение
Подводя итог, можно заключить – единственного верного решения не бывает. Выбор экосистемы зависит сугубо от ваших целей, предпочтений и возможностей. А если вы желаете опробовать железо перед покупкой или не можете определиться с выбором – в Serverflow готовы прогнать тест-пилот с вашими параметрами и софтом. Так вы сумеете избежать очевидных рисков и принять верное решение.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год