


Что означает W4A16, Q4F16, BNB-NF4 и FP8 на Hugging Face: простое объяснение для инженеров

Введение: почему суффиксы в именах моделей важны
Каждый день на Hugging Face появляются новые версии популярных моделей с различными суффиксами в названиях, например: BNB-NF4, Q4_K_M, W4A16 или MXFP4. Для тех, кто ищет оптимальную версию модели для быстрого инференса или обучения на своём оборудовании, эти обозначения чрезвычайно важны: они определяют, какие веса используются, в какой арифметике выполняются вычисления и какие рантаймы поддержат вашу загрузку. Неверный выбор может привести к ошибке загрузки или замедлению скорости обработки в несколько раз.
Представьте, что вы нашли на Hugging Face модель unsloth/Qwen3-VL-8B-Instruct-unsloth-bnb-4bit. Суффикс “bnb-4bit” несёт полезную смысловую нагрузку. Он говорит вам три критических вещи: что модель сжата до 4 бит (вместо стандартных 16 или 32), что используется метод квантизации BitsAndBytes, и что для её загрузки нужна специфическая поддержка в PyTorch/Transformers библиотеке. Если вы попытаетесь загрузить эту модель через vLLM без правильной конфигурации, получите ошибку. А если загрузите через старую версию Transformers, модель будет работать на порядок медленнее.
Суффиксы в названиях работают как “шпаргалка” для инженера. Квантизация и выбор формата вычислений – это одни из самых важных решений при развёртывании больших языковых моделей, потому что они определяют, будет ли модель работать вообще, её скорость, точность и потребление памяти. В статье о квантизации объясняется подробнее, но здесь обрисуем кратко: Квантование – это сжатие модели путём хранения весов в более низкой точности, чем в оригинале. Для более глубокого понимания основ рекомендуем прочитать статью «Квантование ИИ: что это такое и для чего нужно».
Быстрая шпаргалка: как читать метки в имени модели
Ниже приведена таблица с популярными суффиксами квантизаций и пояснения, что они означают.
Суффиксы квантизации
| Суффикс | Что означает | Веса | Вычисления / Активации | Где чаще всего используется |
|---|---|---|---|---|
| q4f16 | 4-бит веса с 16-бит активациями | INT4 | FP16 | Локальное выполнение, быстрые LLM, мобильные устройства |
| q4f32 | 4-бит веса с 32-бит активациями | INT4 | FP32 | Точные вычисления, тестирование, системы требующие высокой точности |
| q4_k_m | 4-бит K-quant с большим масштабированием (medium) | K-quant | FP16 | Оптимизированное сжатие, GGML/llama.cpp, хороший баланс скорость-качество |
| bnb-nf4 | Block-wise Nesterov Fractional 4-бит | INT4 NF | BFloat16 | BitsAndBytes, точное обучение LoRA, высокое качество при экономии памяти |
| bnb-4bit | 4-бит квантизация (стандартная BitsAndBytes) | INT4 | BFloat16 | Fine-tuning, обучение с ограниченной памятью, PyTorch интеграция |
| BNB-NF4 | Block-wise Nesterov Fractional 4-бит (капитальная версия) | INT4 NF | BFloat16 | Обучение больших моделей, LoRA адаптеры, HuggingFace Transformers |
| w8a8 | 8-бит веса, 8-бит активации | INT8 | INT8 | Симметричная квантизация, NVIDIA TensorRT, производственные системы |
| w4a16 | 4-бит веса, 16-бит активации | INT4 | FP16 | Компромисс между скоростью и качеством, мобильные GPU, edge вычисления |
| MXFP4 | MX Floating Point 4-бит (микро-плавающая точка) | MXFP4 | MXFP4 | Новые процессоры с поддержкой MX, максимальное сжатие, исследовательские проекты |
| FP8 | 8-бит с плавающей точкой | FP8 (e4m3/e5m2) | FP8 | H100/L40S/B200 GPU, высокопроизводительные системы, новые архитектуры (Hopper/Blackwell) |
| FP8-Dynamic | 8-бит FP8 с динамическим масштабированием | FP8 адаптивные | FP8 адаптивные | Динамические модели, вариативные входные размеры, адаптивное квантование |
| FP8-D | 8-бит FP8 с дополнительным масштабированием | FP8 | FP8 оптимизированные | Специализированные ускорители, точная контроль квантования |
| f16 | 16-бит с плавающей точкой (half precision) | FP16 | FP16 | Стандартное обучение и вывод, GPU вычисления, базовая точность |
| q0f16 | 0-бит веса (динамическая/гибридная схема) с FP16 | Динамическая | FP16 | Исследовательские модели, экспериментальные подходы |
| int4-mixed-AutoRound | INT4 смешанная квантизация с AutoRound оптимизацией | INT4 адаптивное | Смешанная INT4/FP16 | Автоматическое квантование, RL оптимизация, баланс качества и скорости |
Рекомендации
- Для большинства случаев: Q4_K_M — хороший баланс между качеством и скоростью
- Для высокого качества: Q6_K или FP8 (на современных GPU)
- Для максимальной компрессии: Q4_K_S или w4a16 (AWQ)
- Для CPU инференса: Q4_K_M в gguf формате (llama.cpp)
- Для новых GPU (H100/Hopper, MI300): FP8 обеспечивает лучшую производительность
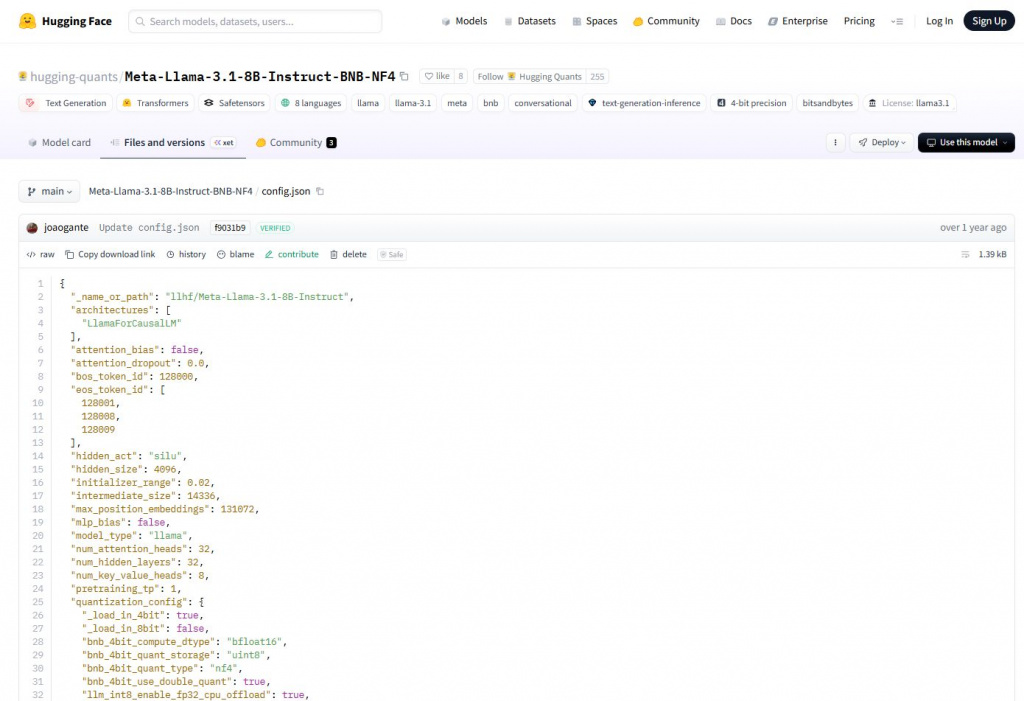
Разбор config.json: на что смотреть
"quantization_config": {
  "_load_in_4bit": true,
  "_load_in_8bit": false,
  "bnb_4bit_compute_dtype": "bfloat16",
  "bnb_4bit_quant_storage": "uint8",
  "bnb_4bit_quant_type": "nf4",
  "bnb_4bit_use_double_quant": true,
  "llm_int8_enable_fp32_cpu_offload": false
}
- _load_in_4bit: true — модель будет загружена в 4-bit формате. Это главный флаг, определяющий режим работы.
- bnb_4bit_quant_type: “nf4” — тип квантизации весов, здесь это NF4 (Normal Float 4-bit), специально разработанный BitsAndBytes для оптимальной компрессии.
- bnb_4bit_compute_dtype: “bfloat16” — вычисления и активации проходят в BF16. Это означает, что при forward pass данные преобразуются в 16-bit, чтобы избежать численных ошибок.
- bnb_4bit_use_double_quant: true — включена двойная квантизация: сами веса квантизованы, плюс квантизованы коэффициенты масштабирования. Это повышает стабильность, но добавляет небольшие вычислительные затраты.
Практические примеры с Hugging Face
- Qwen3-Next-80B-A3B-Instruct-MXFP4.gguf – это модель в GGUF-формате (для llama.cpp), сжатая с помощью MXFP4 (microscaling FP4), это смешанный 4-битный floating-point формат с блочной масштабизацией. При использовании llama.cpp проверьте, что ваша сборка поддерживает FP4, так как это экспериментальный формат на момент 2025 года, его поддерживают самые современные ускорители (B200/B300, MI355X). MXFP4 обещает кратное ускорение относительно FP16 в некоторых операциях, но требует новых GPU (Blackwell, MI355X) для полной поддержки.
- Qwen3-Next-80B-A3B-Instruct-Q4_K_M.gguf – это модель с GPTQ-подобной 4-bit квантизацией, конкретный вариант Q4_K_M означает 4-бит с k-квантизацией и средним вариантом пакования в уже знакомом GGUF-формате. Веса хранятся в 4 битах, но вычисления идут в FP16, что обеспечивает хороший баланс скорости и качества.
- Qwen3-Next-80B-A3B-Instruct-f16.gguf – модель без сжатия, в формате FP16 (16-битный floating-point). Это “эталонный” вариант, который даст вам максимальное качество, но потребует больше памяти. Используйте её, если у вас есть достаточно видеопамяти (для 80B нужно примерно 160 ГБ VRAM в FP16) или если вам нужна максимальная точность.
- Qwen3-Next-80B-A3B-Instruct-int4-mixed-AutoRound – модель, сжатая с помощью AutoRound (метод от Intel), использующий INT4 с адаптивной оптимизацией параметров квантизации. AutoRound показывает двухкратное улучшение в точности относительно других INT4-методов на низких битах. Загружается через Transformers с поддержкой AutoRound или через специальный рантайм SGLang.
- Meta-Llama-3.1-8B-Instruct-BNB-NF4* – это модель Llama* от Meta*, сжатая методом BitsAndBytes NF4. Загружайте её через HuggingFace Transformers с BitsAndBytesConfig. Вычисления по умолчанию идут в BF16. Это отличный выбор, если вы хотите дообучить модель (например с QLoRA) на GPU с 24 ГБ памяти.
- Qwen3-Next-80B-A3B-Instruct-FP8-Dynamic – это модель, подготовленная для FP8 вычислений на современных GPU (H100, MI300, B200, B300). “Dynamic” означает, что масштабирование весов и активаций вычисляется динамически во время инференса, что даёт большую точность, но медленнее статического предварительного масштабирования. Поддерживается в vLLM 0.5+ и TensorRT. На H100 такая модель будет работать в 2x-3x быстрее, чем FP16 вариант, с минимальной потерей качества.
- GLM-4.6-gguf-q2ks-mixed-AutoRound – это экстремальная компрессия: q2ks означает 2-битное сжатие с k-вариантом и стохастическим округлением. Такие модели занимают очень мало памяти, но качество значительно деградирует, и они пригодны только для специфичных задач, где скорость критична. Используйте подобные варианты с осторожностью.
- Llama-3.1-8B-Instruct-q4f16_1-MLC* – модель с q4f16 квантизацией (4-bit веса + FP16 вычисления). Это стандартная комбинация, работает в большинстве рантаймов. MLC в имени указывает на использование MLC Compiler для оптимизации.
Где какие форматы работают (краткая матрица совместимости)
Поддержка форматов квантизации в фреймворках
| Формат / Тег | Transformers (PyTorch) | vLLM | llama.cpp / gguf | TensorRT / HW |
|---|---|---|---|---|
| BNB-NF4 / bnb-4bit | полная поддержка | загрузка моделей | требует конвертации | не поддерживается |
| q4_k_m / GPTQ | через конвертеры | частичная | полная | не поддерживается |
| w8a8 (INT8) | через BNB / AWQ | частичная | требует конвертации | TensorRT полная |
| FP8 | PyTorch 2.5+ | с H100/MI300 | не поддерживается | H100/TensorRT |
| MXFP4 | экспериментальная | новые версии | требует конвертации | новые GPU (2025+) |
Практические советы
- Всегда проверяйте quantization_config: не полагайтесь только на имя файла. Откройте config.json и убедитесь, что понимаете, какой формат реально используется.
- Для локального инференса используйте llama.cpp с GGUF: это самый стабильный и быстрый вариант для потребительских GPU и CPU. Форматы q4_k_m и q5_k_m показывают лучший баланс скорости и качества.
- Для дообучения на одном GPU используйте BNB-NF4 с QLoRA: это позволяет обучать 13B+ модели на GPU с 24 ГБ памяти. Загружайте через Transformers + BitsAndBytesConfig.
- Для инференса с высокой пропускной способностью используйте FP8 на RTX PRO 6000 Balckwell или AMD Radeon AI PRO R9700: если у вас есть доступ к этому железу, FP8 даст вам двукратное ускорение относительно FP16 с минимальной потерей качества. Используйте vLLM или TensorRT.
- Для edge-устройств используйте INT8 или q4_k_m: если вы разворачиваете нейросеть на мобильном устройстве или Jetson, выбирайте минимально возможное сжатие, которое даёт приемлемое для вас качество.
- Экспериментируйте с MXFP4 осторожно: это новый формат, и поддержка в рантаймах может быть нестабильной. К тому же нативно поддерживается он довольно новыми ускорителями (MI350X, MI355X, H100, H200, B200). Если критична надёжность, придерживайтесь q4_k_m или BNB-NF4 (который поддерживается официально начиная с NVIDIA Pascal и частично AMD ROCm‑GPU).
Заключение
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год