


Что такое GLM4.6 и почему она конкурирует с DeepSeek V3

Введение
Модель GLM-4.6 – это свежий шаг в развитии открытых больших языковых моделей, за которым стоит китайская компания Zhipu AI. Она создана на архитектуре Mixture of Experts (MoE), насчитывает ~355–357 миллиардов параметров (с 32B активными на токен) и способна конкурировать с закрытыми коммерческими системами уровня Claude Sonnet 4.5 и DeepSeek V3 для различных задач.
В этой статье разберем, что представляет собой GLM-4.6, чем она отличается от предыдущих версий, как работает с контекстом до 200 000 токенов и почему ее агентные возможности и генерация кода вызывают интерес у разработчиков.
Основные характеристики GLM-4.6
GLM-4.6 – не эволюция ради новой версии, а обновление, которое заточено под практические задачи.
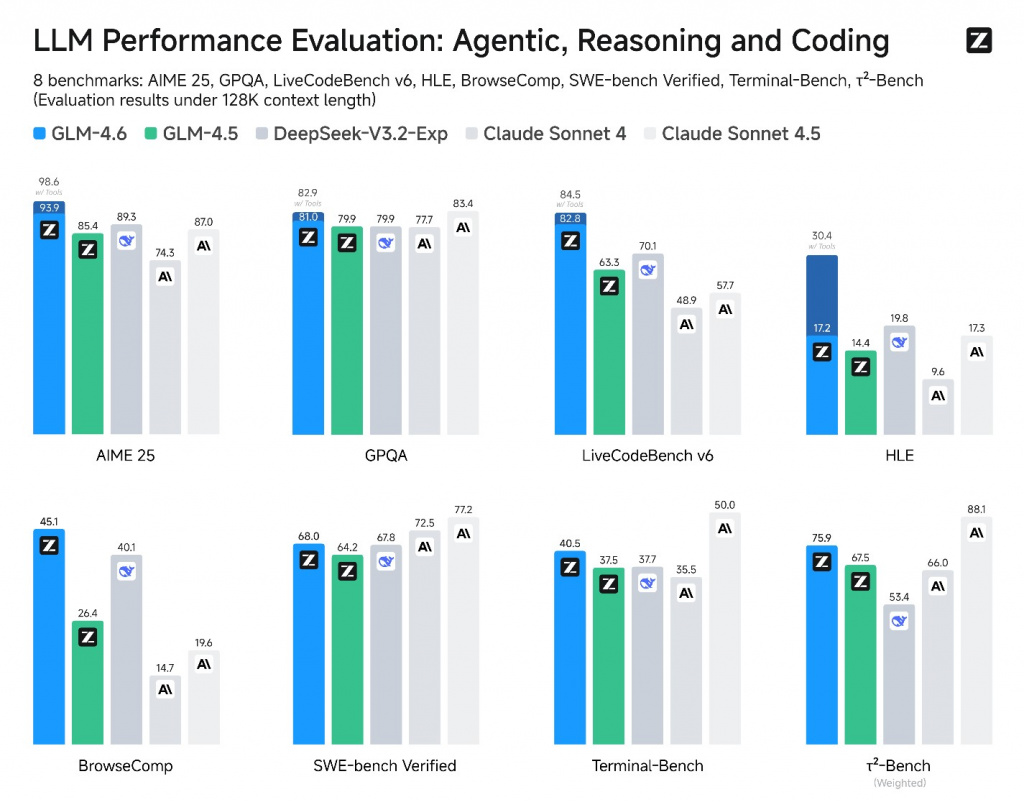
Модель усилили в четырех ключевых направлениях: работа с длинным контекстом, экономия токенов, улучшенное программирование и агентное поведение. Эти особенности делают ее удобной в инженерной работе и бизнес-интеграциях, а не только для диалогов.
Расширенный контекст
Главное обновление – поддержка контекста до 200K токенов вместо 128K у GLM-4.5. Это позволяет работать с материалами, которые раньше было невозможно отправить модели целиком.
Примеры задач, которые теперь решаются без разбиения текста на части:
- анализ исходного кода крупного проекта из десятков файлов;
- обработка многотомной технической документации;
- разбор логов сервера за несколько суток работы;
- аналитика длинных транскриптов митингов, интервью, судебных заседаний;
- чтение и сравнение двух книг или больших PDF-файлов.
Благодаря большому контексту модель лучше сохраняет целостность рассуждений и реже теряет связь между частями документа.
Эффективность использования токенов
Команда Zhipu AI оптимизировала архитектуру внимания и позиционное кодирование. Это позволило сократить количество служебных токенов и снизить стоимость запросов.
Что это дает на практике:
- экономия 15–30% токенов при длинных сессиях (в зависимости от задачи и тестов);
- быстрее обрабатываются большие документы;
- меньше нагрузка при потоковой генерации ответов;
- снижение стоимости работы через API на длинных цепочках диалога.
При тех же объемах данных GLM-4.6 требует меньше токенов, чем GLM-4.5, что делает ее выгоднее при длительных задачах.
Улучшения в генерации кода
GLM-4.6 усилили как кодовую модель. Она лучше справляется с синтаксисом, структурированием проектов и отладкой, а также фиксирует ошибки в логике.
Модель уверенно работает с основными языками программирования, такими как Python, JavaScript, Java, Go, C++, TypeScript.
Что умеет модель в реальных сценариях:
- писать функции и модули по описанию;
- рефакторить и оптимизировать код;
- переносить проект между фреймворками (например, Django → FastAPI);
- исправлять ошибки после просмотра логов;
- генерировать тесты и документацию;
- разбираться в чужом коде с комментариями.
По результатам тестов, таких как LiveCodeBench (LCB v6), SWE-Bench Verified и CC-Bench, у GLM-4.6 выше стабильность выполнения задач, меньше галлюцинаций и точнее следование стилю проекта.
Поддержка агентных систем
GLM-4.6 спроектирована с упором на агентные сценарии – модель не просто отвечает на вопросы, а умеет действовать и взаимодействовать с инструментами.
Ключевые возможности:
- точные вызовы функций (tool calling);
- планирование действий и многошаговые сценарии;
- работа в сложных многошаговых сценариях;
- интеграция с внешними API;
- поддержка RAG – работа с базами знаний и поиском по документам;
- использование в автоматизации процессов и чат-ботах.
Благодаря этим функциям GLM-4.6 подходит для построения инженерных ассистентов, DevOps-агентов, бизнес-ботов и автономных систем, которые выполняют конкретные задачи, а не просто ведут диалог.
Сравнение с конкурентами
GLM-4.6 позиционируется как открытая альтернатива коммерческим моделям уровня Claude Sonnet 4.5 и DeepSeek V3. Ее сильная сторона – сочетание инженерного фокуса, оптимизации и открытого доступа. Но, как и у любой модели, есть компромиссы. Ниже – разбор различий, основанный на тестах MMLU, AIME 2025, GPQA, LiveCodeBench (LCB v6), SWE-Bench Verified, CC-Bench и данных разработчиков Zhipu AI.
GLM-4.6 vs GLM-4.5
Переход от версии 4.5 к 4.6 можно назвать не косметическим, а инженерным. Модель стала стабильнее, глубже в reasoning-задачах и точнее в работе с кодом.
Главные изменения:
- Точность reasoning-задач. На тестах MMLU и GSM8K (арифметика и логические цепочки) GLM-4.6 показала рост точности на 3–4 п.п. по сравнению с 4.5. Это связано с доработкой слоев внимания и улучшенной системой выборки экспертов в MoE-архитектуре. Модель чаще приходит к правильным выводам в задачах с несколькими вариантами решений.
- Более предсказуемое поведение в диалогах. В GLM-4.5 при длинных цепочках иногда наблюдалось «дрейфование контекста» – модель начинала выдавать повторения или забывала начало диалога. В версии 4.6 эта проблема минимизирована: улучшено позиционное кодирование и добавлены новые механизмы контроля консистентности.
- Рост стабильности в кодинге. На LiveCodeBench (LCB v6), SWE-Bench Verified и CC-Bench модель стабильно решает больше задач, чем 4.5. Особенно улучшилась генерация многофайловых проектов: GLM-4.6 корректно удерживает структуру импортов и лучше соблюдает стиль исходного кода.
- Более надежное агентное поведение. Версия 4.6 точнее выполняет tool calling – корректно формирует JSON-вызовы, передает аргументы без искажений и логичнее планирует цепочку шагов. В 4.5 это часто требовало ручной донастройки.
- Оптимизация под реальные нагрузки. Благодаря переработке планировщика экспертов и упрощению слоев внимания снизилось время отклика при длинных запросах. В средних сессиях прирост скорости – до 15 %, при равной точности генерации.
Как итог, GLM-4.6 стала практичнее. Она не просто увеличила контекст, а сделала работу с ним предсказуемой. При этом сохранила баланс между скоростью и качеством reasoning – то, чего не хватало 4.5 в сложных инженерных сценариях.
GLM-4.6 vs Claude Sonnet 4.5 и DeepSeek V3
Сравнивая GLM-4.6 с закрытыми конкурентами, важно понимать их разную философию:
- Claude Sonnet 4.5 – модель Anthropic с фокусом на креатив и «человечность» диалога (с расширенным контекстом до 1M токенов в некоторых конфигурациях);
- DeepSeek V3 – инженерно-ориентированная MoE-архитектура с приоритетом reasoning-точности;
- GLM-4.6 – баланс между ними, но с открытым доступом и упором на практику.
Claude Sonnet 4.5 лучше ведет себя в креативных сценариях: написание длинных текстов, стилистика, интонации, работа с эмоциональными ответами. Он чаще выдерживает «тон» беседы и подходит для пользовательских сервисов, где важен язык, а не структура данных.
DeepSeek V3 превосходит GLM-4.6 в математике, символьных рассуждениях и формальных доказательствах. На MATH и GPQA-тестах он лидирует, благодаря более плотной настройке reasoning-блоков и алгоритмов выбора экспертов.
Claude иногда выигрывает в тонких сценариях общения, где требуется «мягкий» контекстный переход – GLM отвечает все еще чуть «суше» и инженернее. Однако на AIME 2025 GLM-4.6 показывает 93.9%, превосходя Claude Sonnet 4, но в инженерных задачах вроде SWE-Bench GLM-4.6 немного уступает Claude Sonnet 4.5.
Практическое использование
GLM-4.6 доступна как через облачные сервисы, так и для локального развертывания под MIT-лицензией, что выгодно отличает ее от закрытых моделей.
Ее можно использовать двумя путями: через API Zhipu AI или развернув модель на сервере. Рассмотрим оба варианта.
API Zhipu AI
Самый быстрый вариант – подключиться к API Zhipu AI. Для начала нужно зарегистрироваться на платформе zhipu.ai и получить API-ключ в личном кабинете.
После этого запросы к модели отправляются стандартным способом через HTTP или SDK. API поддерживает как текстовую генерацию, так и вызовы инструментов (tool calling), что позволяет подключать модель к внешним системам: базам данных, функциям Python, CRM или поисковым сервисам.
В типовом сценарии разработчики используют API для интеграции GLM-4.6 в веб-сервисы, чат-боты, IDE-ассистентов или системы автоматизации.
Запуск не требует сложной подготовки ― достаточно отправить запрос с моделью glm-4.6 и текстом промпта, после чего результат можно обрабатывать в коде приложения. API также поддерживает потоковую генерацию, полезную для интерфейсов чатов.
Hugging Face или ModelScope
Тем, кому требуется полный контроль над инфраструктурой и данными, доступно локальное развертывание. GLM-4.6 опубликована на Hugging Face и ModelScope, поэтому ее можно скачать вместе с конфигурацией и весами.
Развертывание требует GPU с достаточным объемом памяти – требования зависят от варианта весов и квантизации: от 1×40GB (4-бит с оффлоудом в RAM) до мульти-GPU (например, 8×H200 NVL) для высоких скоростей.
Поддерживается запуск через популярные фреймворки, такие как vLLM, DeepSpeed-MII и PyTorch Transformers. Локальный запуск позволяет встроить GLM-4.6 в корпоративную инфраструктуру, не передавая данные третьим сторонам, и настроить расширенные сценарии: RAG с приватными документами, внутренние DevOps-агенты или офлайн-решения в закрытом контуре.
Если нужен баланс между скоростью внедрения и гибкостью, можно выбрать комбинированный подход: тестирование и первые прототипы – через API, затем перенос на локальный inference при масштабировании и повышении требований к приватности. Это делает модель удобной для стартапов и для крупных компаний.
Преимущества и ограничения
GLM-4.6 – практичная модель, но ее возможности и ограничения важно понимать заранее, чтобы правильно планировать внедрение.
Преимущества:
- высокая устойчивость на длинных задачах: модель держит контекст в многошаговых сценариях и не теряет нить при длительных диалогах;
- точное выполнение инструкций: особенно заметно при работе с кодом, разборе структурированных данных и аналитических запросах;
- развитые агентные возможности: корректно вызывает внешние функции, обрабатывает параметры и строит цепочки действий;
- за счет оптимизации контекста модель уменьшает расходы на обработку длинных сессий по сравнению с аналогами;
- модель доступна для локального развертывания, что удобно для интеграций в закрытых инфраструктурах;
- производительность в реальных сценариях: совместимость с RAG-системами, DevOps-ботами, бизнес-агентами и инженерной автоматизацией.
Однако, кроме преимуществ, у GLM-4.6 есть и определенный ряд ограничений:
- Ограниченная точность в символьной математике. Как и большинство LLM, модель чаще решает математические задачи на уровне рассуждений, но может ошибаться в строгих алгебраических преобразованиях.
- Чувствительность к качеству запроса. При некорректной формулировке задачи повышается риск логических ошибок или неточностей.
- Возможны редкие галлюцинации. При отсутствии фактов в контексте модель все еще может придумывать информацию, поэтому важно проверять критически важные ответы.
- Нет встроенной защиты от ошибок пользователя. При использовании tool calling модель может отправлять некорректные параметры, если правильно не настроены валидаторы.
- Требовательность к ресурсам. Полная версия GLM-4.6 MoE в локальном запуске потребляет существенные вычислительные мощности.
- Конфиденциальность зависит от сценария. При использовании облачного API данные передаются внешнему провайдеру, поэтому для закрытых проектов лучше предпочесть локальный запуск.
В целом GLM-4.6 – рабочая инженерная модель, но не универсальная. Она отлично подходит для автоматизации и кода, но требует контрольных механизмов при работе с точными вычислениями и фактическими данными.
Заключение
GLM-4.6 – это рабочая модель для тех, кому важны не только красивые демонстрации, но и стабильность в задачах. Вот в каких случаях она хороша:
- разработка и поддержка программных проектов, автоматизация рутинного кодинга и улучшение DevOps-процессов;
- создание интеллектуальных агентов, которые не просто отвечают на вопросы, а выполняют действия через API-инструменты;
- работа с большими текстовыми массивами – технической документацией, аналитикой, отчетами, базами знаний;
- построение корпоративных чат-ботов и систем поиска с пониманием контекста (RAG);
- локальное внедрение в закрытых инфраструктурах без зависимости от внешних SaaS.
GLM-4.6 – хороший выбор для разработчиков, аналитиков, интеграторов и исследовательских команд. Это не универсальная модель для творчества или эмоциональных сценариев общения, но отличный инструмент для тех, кто ценит точность, воспроизводимость и контроль.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год