


EXL2: экстремальное квантование для локальных LLM и запуск больших моделей на обычной видеокарте

Введение, от GPTQ и AWQ к новому поколению квантования
В предыдущих материалах мы разбирали, как GPTQ научил большие языковые модели экономить память без потери смысла, а AWQ сделал квантование умным, учитывая активации. Эти подходы сформировали основу современной оптимизации моделей, они позволили запускать LLM в дата-центрах и на серверных системах с GPU уровня A100 или H100. Однако всё это оставалось уделом инфраструктуры, далёкой от домашних условий.
А что, если требуется запустить модель вроде Llama* прямо на домашней видеокарте, без кластера и сложных движков наподобие vLLM или TensorRT? Именно этот вопрос и привёл к созданию EXL2, нового формата квантования, который превратил локальный инференс из эксперимента энтузиастов в реальный инструмент для каждого разработчика.
EXL2 – экстремальное квантование, где неважно, что модель весила 30 гигабайт, теперь её можно сжать, загрузить в 10 ГБ VRAM и заставить работать стабильно. Это формат, который сделал квантование LLM по-настоящему домашним.
Пока GPTQ и AWQ совершенствовали точность и стабильность под нужды дата-центров, сообщество энтузиастов Ollama, LM Studio и KoboldCPP пошло другим путём. Их целью было не уменьшение ошибки на серверных нагрузках, а запуск мощных языковых моделей на видеокартах уровня RTX 4060 или даже 3060, без кластера и сложных инфраструктур вроде vLLM или TensorRT.
Что такое EXL2 и откуда он взялся
EXL2 родился внутри проекта ExLlama v2, который изначально занимался оптимизацией инференса Llama* и других крупных моделей. Разработчики искали способ ускорить загрузку квантизированных моделей, минимизировать VRAM и при этом не жертвовать устойчивостью вывода.
Так появился EXL2 формат, где каждая деталь подчинена производительности. Из технического эксперимента EXL2 быстро превратился в отраслевой стандарт в среде локальных LLM, сегодня его поддерживают все популярные платформы для работы с языковыми моделями. И теперь модель EXL2 скачать можно почти для любого семейства Llama*, Mistral, Phi и других.
Как работает EXL2, квантование без сантиментов
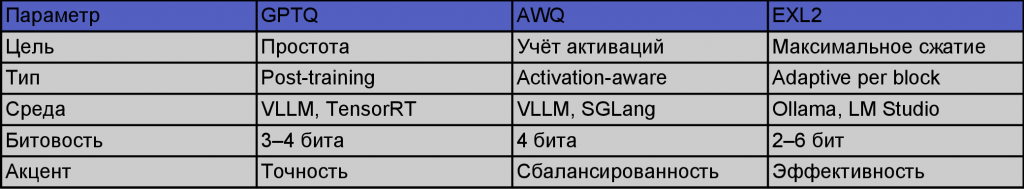
Главное в EXL2 – адаптивная групповая квантизация, когда веса модели делятся на небольшие группы и для каждой подбирается оптимальная битность квантизации. Если традиционные методы, такие как GPTQ и AWQ, фиксируют количество бит на весь слой или модель (обычно 4 бита), то EXL2 гибко регулирует битность для каждой группы весов. Важные участки, влияющие на смысл и грамматику, сжимаются умеренно: чаще с 4 битами, а незначимые участки могут ужиматься до 2 или 3 бит.
Технически процесс выглядит так: после анализа распределения весов и их значимости для вывода, части модели, которые наиболее критичны для качества генерации, получают повышенную точность. Остальные группы ужимаются сильнее, так происходит экстремальное сжатие, за что EXL2 и ценят инженеры локального инференса. В результате появляется карта битностей: у каждой группы свой минимальный необходимый объём информации.
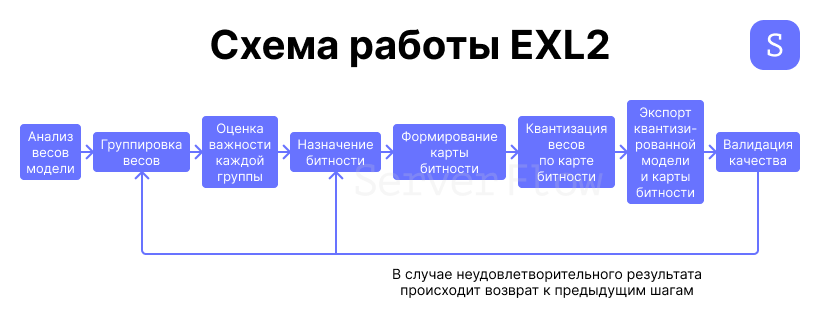
EXL2 реализует адаптивную групповую квантизацию шаг за шагом, чтобы добиться максимального сжатия при сохранении работоспособности модели на локальной видеокарте. Технически процесс включает несколько ключевых этапов:
- Анализ весов модели. После загрузки исходной нейросети алгоритм анализирует распределение всех весов: оценивается их разброс, статистика, а главное то, насколько каждая группа весов критична для точности предсказаний. Это делается либо по структуре слоёв, либо с помощью тестовых прогонов, оценивая влияние ошибки на качество генерации.
- Группировка весов и оценка их значимости. Веса делятся на группы, обычно по 64 или 128 элементов. Для каждой группы вычисляется важность: насколько именно её «сжатие» повлияет на смысловой выход модели. Например, веса в ключевых слоях (attention, FFN) анализируются отдельно.
- Присвоение битности. Для наиболее чувствительных к ошибке групп выбирается максимальная битность, обычно 4 бита, чтобы максимально сохранить нюансы. Группы, которые при квантизации в меньший разряд не теряют качества, ужимаются до 2 или 3 бит, что радикально экономит память.
- Формирование карты битностей. Полученные значения битности записываются в специальную “карту” – метаданные, где для каждой группы хранится свой параметр. Эта карта необходима для правильной реконструкции весов и, по сути, делает формат EXL2 адаптивным.
- Квантизация и сборка модели. Каждая группа весов перекодируется с нужной битностью, модель пересобирается, а к ней добавляется карта битностей. В итоге пользователь получает компактный файл: квантизированную модель с индивидуальным распределением битности по структуре.
- Проверка и валидация. На финальном этапе проводится тестирование генерации: если качество ухудшилось слишком сильно, наиболее “ужатые” группы получают дополнительный бит или перераспределяются.
В результате появляется квантизированная LLM, которую можно запускать на обычной видеокарте без потери функциональности для большинства решений. Именно такая гибкость и индивидуальный подход к сжатию делают EXL2 идеальным для локального инференса.
EXL2 против GPTQ и AWQ, три философии квантизации
Где используется EXL2 и как его попробовать
ollama run llama3:8b-exl2Преимущества и ограничения EXL2
Преимущества
Ограничения
EXL2 — символ нового этапа квантизации
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год