


AllenAI выпустила olmOCR 2: новый конкурент топовых OCR-нейросетей

Введение
Команда AllenAI (AI2) представила olmOCR 2 — новую модель распознавания документов, которая достигает рекордной точности в 82,4 балла, правда, пока только во внутреннем бенчмарке olmOCR-Bench.
Подробнее о olmOCR 2
Построенная на базе Qwen2.5-VL-7B, модель olmOCR 2 демонстрирует заметное превосходство над предыдущей версией olmOCR и решениями конкурентов, например, Marker (76,1), MinerU (75,2), DeepSeek-OCR (75,7) и PaddleOCR-VL (80). Модель обучена на наборе данных olmOCR-mix-1025, включающем 270 тысяч страниц — от научных статей и юридических текстов до исторических сканов и рукописей. Также нейросеть может генерировать ответ в форматах Markdown, HTML и LaTeX без постобработки.
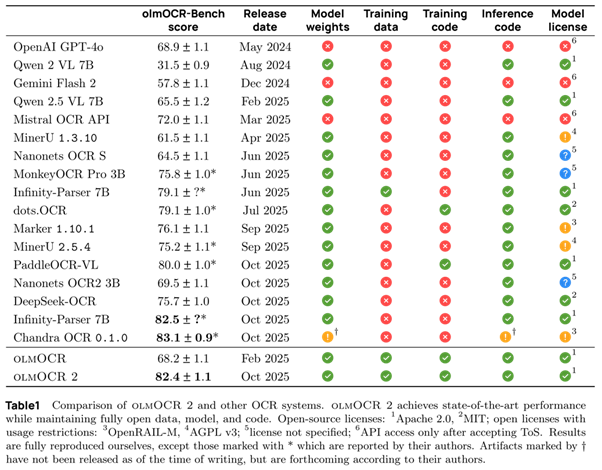
Ключевое нововведение olmOCR 2 заключается в применении обучения с подкреплением, где в роли награды выступает проверяемая корректность вывода. Система Group Relative Policy Optimization (GRPO) использует модульные тесты, которые проверяют сохранение структуры таблиц, точность математических символов и порядок чтения. Этот подход позволяет обучать модель на основе формальных критериев оценки, а не только на статистических метриках. Для этого AI2 создал синтетический набор olmOCR-synthmix-1025 из 2186 PDF-документов и более 30 тысяч тестируемых примеров, что позволило снизить стоимость инференса до 12 центов за страницу.
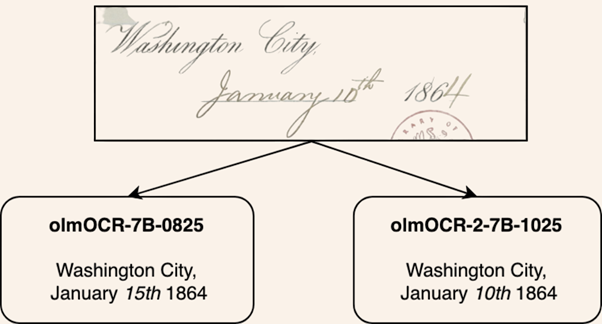
olmOCR 2 показывает устойчивые улучшения в тех областях, где традиционные OCR-системы обычно теряют точность: при обработке математических формул, сложных таблиц и многоколоночных макетов. Так, модель корректно интерпретировала дату в письме Авраама Линкольна от 10 января 1864 года, где прежние версии ошибались из-за неразборчивого почерка.
Выводы
Результаты тестов, веса модели и код обучения опубликованы на платформе Hugging Face, а также нейросеть доступна через API на DeepInfra и Parasail. olmOCR 2 делает шаг к воспроизводимому, детерминированному и проверяемому OCR, где каждая расшифровка документа может быть объективно верифицирована. Этот подход сближает распознавание текста с инженерными стандартами надежности и открывает путь к интеграции OCR в корпоративные, научные и архивные системы, где важна не только точность, но и проверяемость результатов.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год