


RAG vs Fine-Tuning: что выбрать для бизнеса и разработчиков в 2026 году

Введение
Как вы помните, совсем недавно мы рассказывали вам о RAG-технологиях, и у многих из вас может появится логичный вопрос: “Зачем вообще нужно использовать Fine-Tuning, если у нас есть RAG-интеграции?”. Несмотря на то, что обе технологии оптимизируют работу больших языковых моделей, делают они это принципиально по-разному. Если RAG работает как “подсказчик”, подключая модель к внешней базе знаний для генерации ответов на основе актуальных фактов, то Fine-Tuning действует как полноценная “прошивка”, при которой LLM не просто использует ваши корпоративные данные, а переобучается на них, чтобы навсегда усвоить специфическую терминологию и стиль генерации ответов. Так или иначе, вопрос выбора между Fine-Tuning и RAG все еще открыт, а из-за роста требований к точности, скорости и стоимости он еще и постоянно осложняется. В этой статье специалисты компании ServerFlow расскажут вам, в чем состоят ключевые отличия между RAG и Fine-Tuning, в каких сценариях использовать эти методы оптимизации LLM и какую стратегию их использования оптимально выбирать в 2026 году.
Что такое RAG и как он работает?
Прежде чем погружаться в основополагающие различия между RAG и Fine-Tuning, стоит напомнить, что скрывается за этими понятиями.
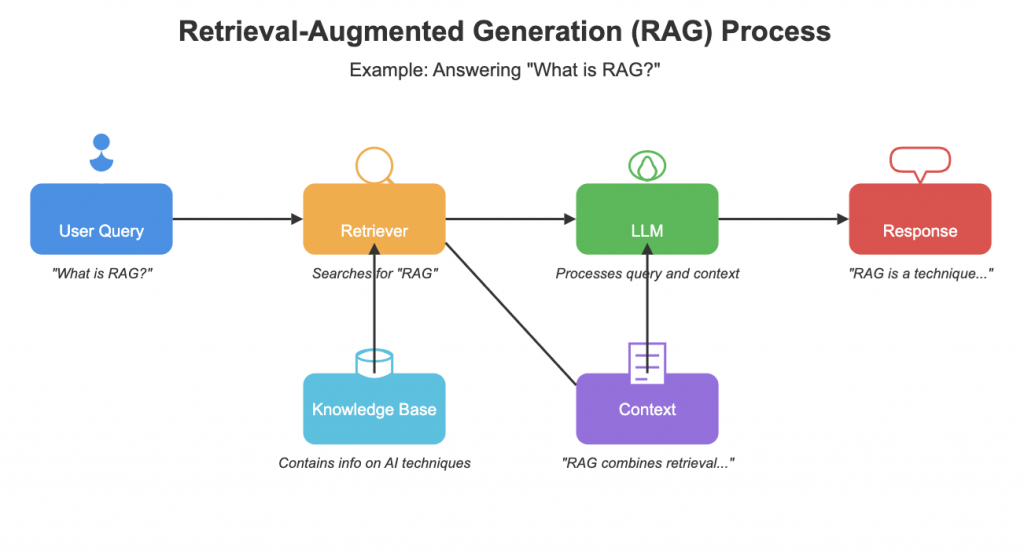
Retrieval-Augmented Generation (RAG) — это технология, которая соединяет большую языковую модель с внешними источниками знаний, не меняя структуру ее весов. Процесс работы RAG состоит из нескольких четких этапов:
- Когда пользователь задает вопрос, система сначала преобразует его в числовой вектор (эмбеддинг).
- Затем этот вектор используется для семантического поиска в специальной векторной базе данных, где хранятся обработанные документы компании.
- Найденные релевантные фрагменты текста передаются в LLM в качестве контекста, и модель генерирует окончательный ответ, основываясь на ранее найденной информации.
Благодаря этому используемая языковая модель получает доступ к актуальным данным и не ограничивается базовым датасетом. Кроме того, RAG значительно снижает количество галлюцинаций, так как модель опирается на проверенные источники и ей не нужно додумывать несуществующую информацию. Развертывание базовой RAG-системы обычно происходит быстрее и требует меньше вычислительных ресурсов по сравнению с полным циклом дообучения модели.
Однако у RAG есть и недостатки. Модель не усваивает знания навсегда — каждый ответ зависит от качества и скорости поиска. Это создает зависимость от хорошо организованной и поддерживаемой базы знаний. Кроме того, в высоконагруженных системах этап семантического поиска может вносить дополнительную задержку в генерации ответов.
Что такое Fine-Tuning и чем он отличается
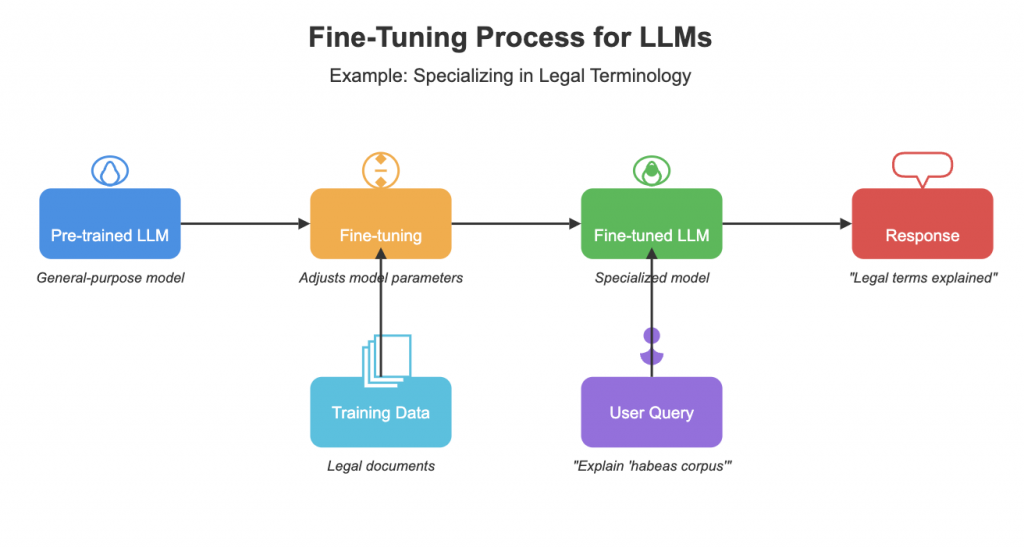
Fine-Tuning — это процесс дополнительного обучения предварительно обученной языковой модели на узком наборе данных, который оптимизирован под конкретную предметную область или конкретный тип задач. В отличие от RAG, этот метод не просто предоставляет модели справочные данные, а изменяет ее внутренние веса , делая ее полноценным экспертом в нужной области. Но процесс дообучения требует тщательной подготовки, который состоит из нескольких этапов:
- Сначала собирается высококачественный набор данных, который отражает целевой домен — например, юридические контракты, медицинские записи или техническая документация.
- Затем базовая модель (GPT, Qwen, DeepSeek, LLaMA и т.д.) проходит через дополнительные циклы обучения на этих данных, в ходе которых ее параметры тонко настраиваются. Для этого часто используются эффективные методы, такие как LoRA и QLoRA, которые снижают вычислительные затраты за счет обучения малого количества весов (обычно менее 1%). Финальный этап — тщательная оценка модели на предмет повышения точности ответов в специализированных задачах.
Главное преимущество Fine-Tuning — это монолитное закрепление знаний. Модель не просто получает доступ к новым фактам, а начинает понимать специализированную терминологию, стилистику и логику домена. Благодаря этому достигается высокая согласованность ответов, снижается зависимость от длинных контекстов в промптах и, как следствие, снижеются задержки при инференсе. Но за такие инновационные возможности приходится заплатить высокими требованиями к системным ресурсам: процесс обучения требует значительных вычислительных мощностей (GPU), определенного количества времени и экспертных знаний вашего разработчика в области машинного обучения. Модель, однажды обученная, “застывает” во времени, и для обновления знаний требуется снова проходить процесс переобучения. Также существует риск “катастрофического забывания”, когда модель теряет часть своих общих знаний и способностей в процессе дообучения, превращаясь в овоща, который знает ваш корпоративный этикет, но не может посчитать 2+2.
Сравнение RAG и Fine-Tuning: таблица различий
Подходы RAG и Fine-Tuning не являются прямыми конкурентами; они решают разные задачи и часто идеально дополняют друг друга в гибридных архитектурах. Следующая таблица наглядно демонстрирует их ключевые различия по основным критериям, важным для бизнеса и разработчиков:
|
Критерий |
RAG |
Fine-Tuning |
Комментарий |
|
Скорость внедрения |
Быстро (дни, недели) |
Медленнее (недели, месяцы) |
RAG позволяет быстро запустить MVP, тогда как Fine-Tuning — это более долгий цикл разработки. |
|
Стоимость (CAPEX) |
Относительно низкая |
Высокая (вычислительные ресурсы, данные) |
RAG требует меньше затрат на начальном этапе. Fine-Tuning сопряжен со значительными upfront-расходами. |
|
Обновляемость данных |
Автоматическая (обновление базы знаний) |
Требуется переобучение модели |
RAG идеален для динамичных данных. Обновление дообученной модели — дорогой и медленный процесс. |
|
Качество терминологии/стиля |
Среднее (зависит от промпта) |
Высокое (знания усвоены) |
Fine-Tuning обеспечивает безупречное владение стилем и жаргоном, так как они встроены в модель. |
|
Требования к железу |
Серверы с CPU/GPU для инференса и базы данных |
Мощные GPU-кластеры (A100/H100) для обучения |
Инференс RAG менее требователен. Fine-Tuning предъявляет экстремальные требования к hardware для тренировки. |
|
Гибкость |
Высокая (легко сменить базу знаний) |
Низкая (для смены домена нужно переобучать) |
RAG позволяет одной модели работать с разными базами знаний. Fine-Tuning модель заточена под одну задачу. |
|
Прозрачность |
Высокая (возможность цитирования источников) |
Низкая («черный ящик») |
В RAG можно проверить, на каких данных основан ответ, что критично в юриспруденции и медицине. |
Стоимость и ресурсы: что выгоднее
Итак, мы разобрались, чем же отличаются RAG и Fine-Tuning, но на самом деле выбор между этими подходами в чаще всего определяется не столько их эффективностью, сколько доступным бюджетом, срочностью и стратегическими целями проекта. RAG, как правило, выгоднее использовать на старте внедрения ИИ. Для его развертывания не требуются дорогостоящие GPU-кластеры для обучения — достаточно серверов с CPU/GPU для работы векторной базы данных и инференса модели. Основные затраты смещаются от CAPEX (капитальные расходы) к OPEX (операционные расходы) и связаны с поддержанием и обновлением базы знаний, а также с выполнением запросов, которые могут становиться дороже при масштабировании.
Fine-Tuning, напротив, требует значительных первоначальных инвестиций. Процесс обучения потребует доступа к мощным GPU (таким как A100 или H100) на продолжительное время, что влечет за собой высокие вычислительные затраты. Кроме того, необходимы ресурсы для сбора и разметки высококачественного набора данных для обучения. Однако после развертывания такая модель может работать на менее мощной инфраструктуре для инференса, а ее эксплуатация обеспечивает долгосрочную выгоду за счет глубокой экспертности и, потенциально, меньшей стоимости вывода одного запроса благодаря отсутствию этапа поиска данных во внешних источниках.
На практике компании часто совершают одну и ту же ошибку: начинают с экспериментов на тестовых машинах. Вроде бы все работает, но как только нагрузка растет — поиск в RAG начинает тормозить, а Fine-Tuning выполняется целую неделю, если не месяц, в конце кастрируя добрую половину функций LLM. Правда в том, что RAG и Fine-Tuning — это не только алгоритмы, но и разные требования к инфраструктуре. Для RAG нужен быстрый сервер с надежной векторной базой и оптимизированным инференсом. Для Fine-Tuning нужны обучающие узлы с запасом мощности и стабильностью 24/7. ServerFlow может обеспечить ваш бизнес обоими типами серверов. Наша компания предлагает широкий выбор готовых серверных конфигураций — от компактных узлов под RAG до полноценных ИИ-стоек для масштабного обучения LLM. Не нужно гадать, выдержит ли ваш сервер — наши специалисты уже все проверили за вас и предоставят готовую сборку под выполнение конкретных задач.
Комбинированные стратегии: когда лучше связка
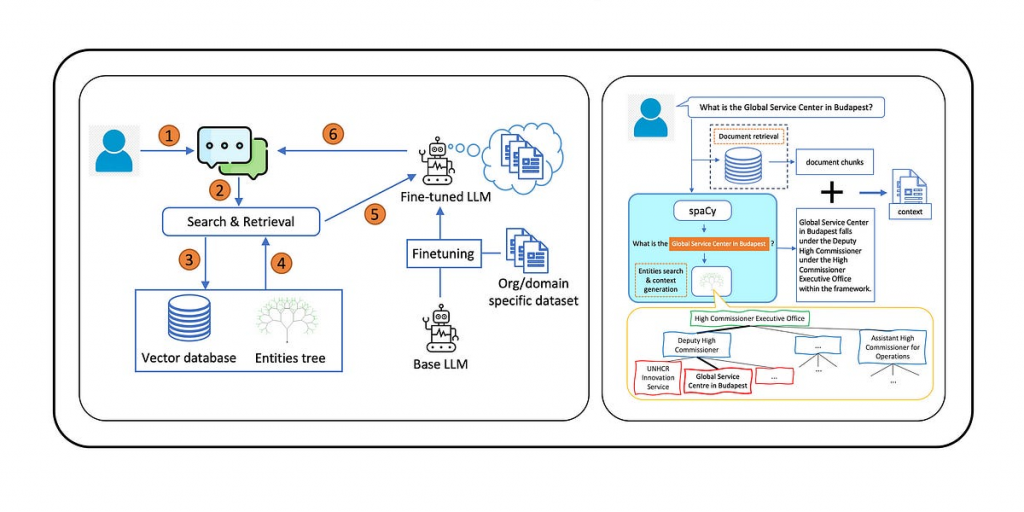
В 2026 году наиболее эффективным корпоративным стандартом становятся не отдельные подходы, а их гибридные комбинации. Этот метод, иногда называемый RAFT (Retrieval-Augmented Fine-Tuning), позволяет объединить сильные стороны обеих технологий, создавая мощные и сбалансированные ИИ-приложения.
Классический сценарий гибридного подхода: использование Fine-Tuning для усвоения терминологии и стиля, а RAG — для подкачки актуальных данных из внешних исчтоников. Например, чат-бот технической поддержки может быть дообучен на истории диалогов менеджеров компании с клиентами, чтобы перенять корректный, корпоративный тон общения, правильные формулировки и глубокое понимание продукта. Одновременно с этим, через RAG-контур он получает доступ к самой последней базе знаний с инструкциями по устранению неисправностей или информацией об обновлениях.
Другой пример — аналитическая система в юридической фирме. Дообученная модель будет бегло оперировать сложной юридической терминологией и структурой документов, в то время как Graph-RAG будет извлекать и анализировать взаимосвязи между судебными делами, прецедентами и нормами права, обеспечивая глубокий контекстуальный анализ. Такой гибридный подход позволяет достичь беспрецедентного уровня качества: Fine-Tuning отвечает за форму и глубину “понимания”, а RAG — за актуальность и достоверность содержания ответов.
Выводы
В условиях активного развития ИИ-индустрии в 2026 году использование таких передовых технологий, как RAG и Fine-Tuning, определяет конечную эффективность автоматизации ваших бизнес-процессов с помощью нейросетей. Но если раньше эти методы оптимизации применялись по-отдельности, то в нынешних реалиях парадигма сместилась от выбора “или-или” к мощному, гибридному подходу, где RAG и Fine-Tuning вступают в синергию, делая из вашей LLM не просто интеллектуального помощника, а полноценного сотрудника, который знает о бизнес-процессах буквально все. Но помните, что внедрение таких инновационных решений требует не только большого желания и знания преимуществ подходов, но и правильной технологической базы. Именно здесь готовые серверные решения от ServerFlow становятся ключевым элементом для быстрого и эффективного внедрения RAG и Fine-Tuning в вашу инфраструктуру.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год