


AMD Quark: инструмент для квантования моделей ИИ в экосистеме ROCm

Введение
Ещё недавно разработчики, создающие масштабные нейросети, сталкивались с одними и теми же вызовами: где взять достаточно памяти для языковой модели? Как заставить модели работать быстрее, а инфраструктуру потреблять меньше электроэнергии? Далеко не каждый может позволить себе огромные серверы только ради теста новой архитектуры.
Теперь представьте: у вас на руках удобный, открытый инструмент, с которым инференс ускоряется, а расходы падают. Всё это становится возможным с AMD Quark, официальным open-source решением для квантования, интегрированным в экосистему ROCm.
С выпуском ROCm 7.0 Quark стал центральным элементом стратегии AMD по конкуренции с гигантами рынка, CUDA и TensorRT, делая мир ИИ доступнее. Но как конкретно этот инструмент помогает запускать LLM и другие модели быстрее и дешевле на GPU AMD? Давайте разберёмся вместе.
Что такое AMD Quark и зачем он нужен
В мире оптимизации моделей нет времени ждать и переписывать код под каждый новый стандарт. Quark решает эту проблему элегантно: он является библиотекой оптимизации с открытым исходным кодом, «заточенным» под квантование. Это значит, что любой желающий может уменьшить разрядность весов и активаций в своей нейросети, не рискуя потерять точность.
Поддержка PyTorch и ONNX превращает внедрение квантования в пару строчек кода, а интеграция с Hugging Face снимает головную боль с поиском или публикацией новых моделей. Quark одинаково дружелюбен как к мощным серверным процессорам EPYC и Ryzen AI, так и к ускорителям Instinct и Radeon Pro.
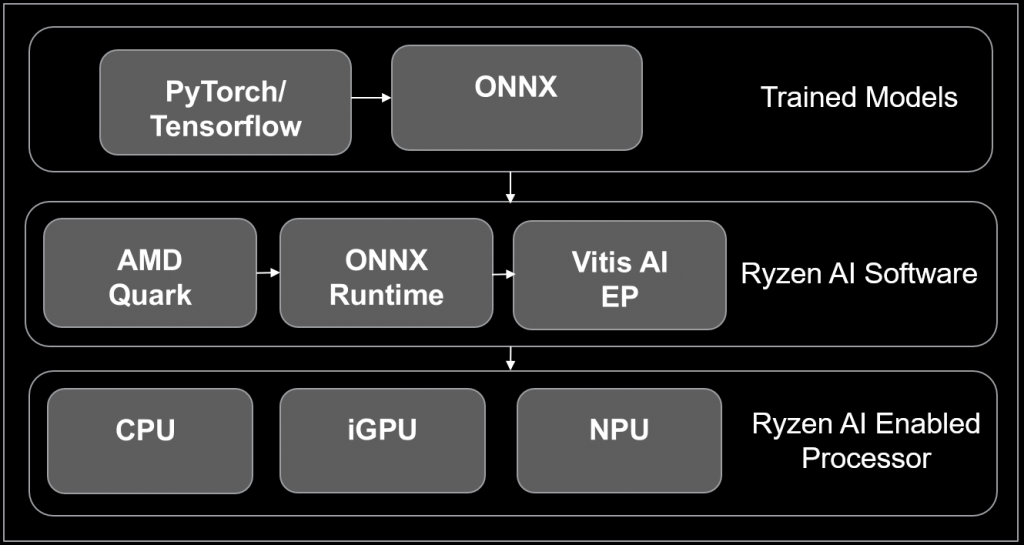
В практической разработке часто приходится балансировать между скоростью и качеством модели. Квантование Quark позволяет существенно уменьшать размер модели и максимально задействовать потенциал оборудования, но при этом поддерживать уровень точности, приемлемый для самых требовательных сценариев: генерация текста, сложная аналитика, обработка изображений и даже задачи распознавания речи. По сути, это шаг к массовой доступности ИИ. Теперь экспериментировать с большими языковыми моделями могут не только гиганты вроде OpenAI, но и индивидуальные разработчики, исследовательские команды, небольшие компании.
Поддерживаемые форматы и алгоритмы квантования
Теперь взглянем «под капот». Из чего же состоит магия Quark?
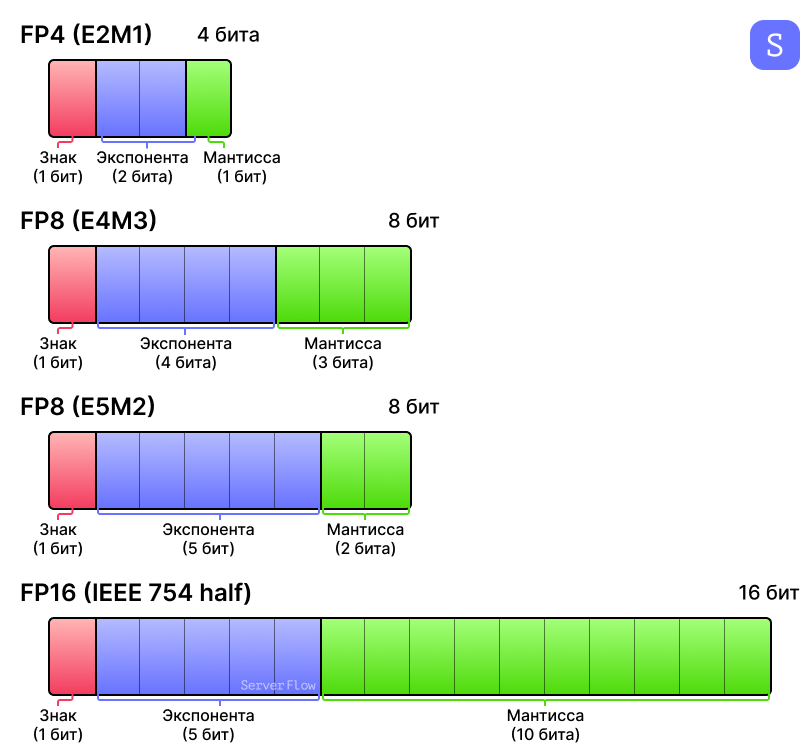
FP8, FP4, INT8, INT4, BF16, BFP16, а также новые форматы mxFP4 и mxFP6. Всё это поддерживается из коробки и позволяет гибко подбирать компромисс между быстродействием и точностью.
Поддерживаемые модели и сценарии применения
Интеграция с экосистемой: Hugging Face, vLLM, Llama.cpp
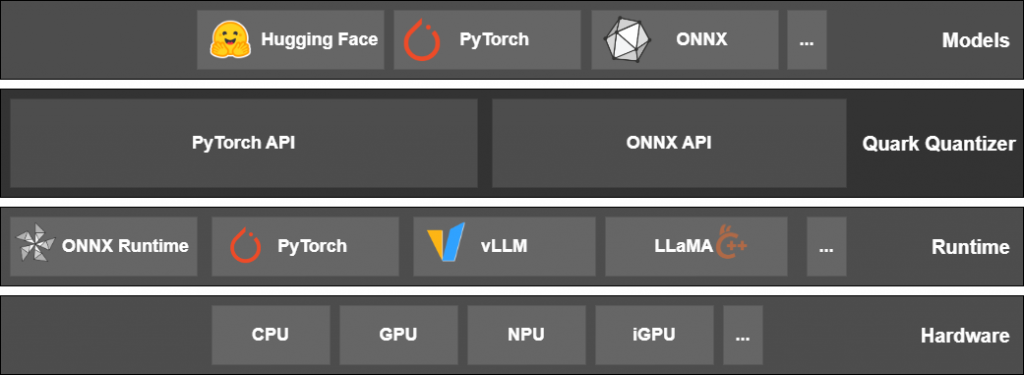
С vLLM можно просто выставить параметр quantization=”fp8″ и моментально получить ускорение инференса, минимум ручных доработок, плюс освобождение значительной части памяти под дополнительные задачи. Использование Llama.cpp теперь говорит не о компромиссе, а о возможности легко запускать модели на CPU и GPU, а экспорт в GGUF превращает перенос обученной нейронки в процесс, понятный буквально каждому разработчику.
Для open-source-комьюнити такой подход открывает новые горизонты. Сотни моделей стали совместимы с AMD, миграция занимает минуты, а интеграция дополнительных функций не требует переписывания значимых частей кода. Это уже не просто техническое удобство, а реальный стратегический плюс для команд, желающих быстро выводить решения на рынок и настраивать ИИ-инфраструктуру под свои уникальные задачи..
Заключение
Появление AMD Quark стало для индустрии ИИ настоящим глотком свежего воздуха. С этим инструментом оптимизация больших моделей больше не требует компромиссов между скоростью, компактностью и качеством. Пара с ROCm 7.0 и поддержкой ультранизких форматов открывает новый потенциал семейства Instinct.
Интеграция с Hugging Face, vLLM, Llama.cpp делает Quark частью современной экосистемы, а приверженность открытому коду ключом к развитию. Сегодня этот инструмент уже сравним с NVIDIA TensorRT, только без барьеров и с акцентом на доступность.
AMD делает ИИ ближе и проще, и Quark здесь играет одну из главных ролей. Будущее квантования и дальнейший рост экосистемы за этим подходом. Теперь это очевидно и тем, кто создает передовые модели, и тем, кто только начинает свой путь в мире искусственного интеллекта.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год