


Подробно о ROCm 7.0 для AMD GPU: что нового и стоит ли обновляться

Введение
Экосистема ROCm давно перестала быть «довеском» к драйверам для графических ускорителей AMD. Это полноценная платформа, которая соединяет воедино компиляторы, runtime-слой, библиотеки для глубокого обучения, механизмы построения вычислительных графов и инструменты профилирования. Именно ROCm стоит между аппаратной архитектурой и стеком машинного обучения, определяя не только производительность, но и набор доступных форматов чисел, уровень совместимости с современными фреймворками и практическую удобность эксплуатации в кластерах или виртуализированных инфраструктурах.
Релиз ROCm 7.0, официально представленный 16 сентября 2025 года, следует рассматривать не как локальное обновление библиотек, а как переоснащение всей экосистемы: начиная от API и драйверов, заканчивая поддержкой современных GPU-линеек и дистрибутивов Linux. Эти изменения напрямую влияют на совокупную стоимость владения (TCO) и скорость вывода моделей в промышленную эксплуатацию. Оптимизации в библиотеках и новых форматах чисел снижают энергозатраты, повышают пропускную способность систем и ускоряют переход от исследований к продуктовой интеграции.
Именно поэтому, если ваши вычислительные мощности строятся на AMD Instinct — от более зрелых MI100 и MI210 до актуального семейства MI300 и перспективных линеек, либо вы стремитесь снизить стоимость инференса за счет низкоразрядных форматов FP8 и FP4, релиз ROCm 7.0 стоит рассматривать не как рутинное обновление пакетов, а как платформенный апгрейд.
Что несёт ROCm 7.0 поверх 6.x: контекст и мотивация
Ключевое отличие серии ROCm 7.x от 6.x заключается в смещении акцента с базового набора драйверов и библиотек в сторону полноценной поддержки производственного инференса и масштабируемых сценариев. Совместимость с обновлёнными версиями PyTorch, JAX и TensorFlow, а также наличие контейнеров «из коробки» минимизируют затраты на адаптацию окружений.
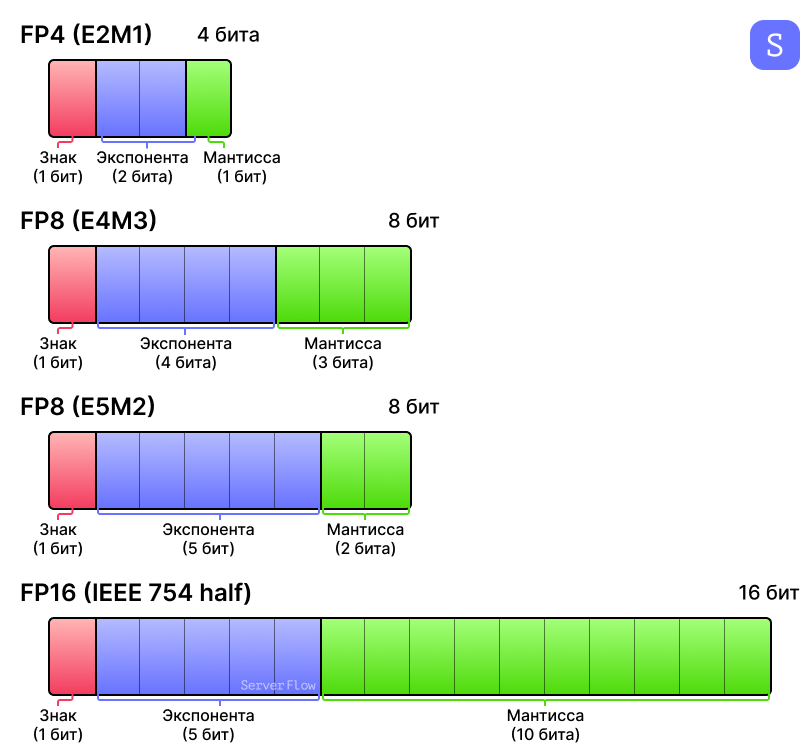
Встроенная же поддержка форматов FP8, FP6 и экспериментального FP4 позволяет радикально снизить стоимость обработки каждого запроса и уменьшить требования к памяти без значимой потери точности.
Но, важно оговорить, что на старых ускорителях AMD Instinct серии MI100 и MI200 поддержка FP4 и FP8 отсутствует на аппаратном уровне, поэтому эти форматы эмулируются программно в ROCm. Это соответственно снижает производительность и эффективность использования памяти по сравнению с новыми архитектурами CDNA3 и CDNA4. Поэтому запускать тот же FP4 на AMD Instinct MI100 не имеет смысла из-за отсутствия аппаратной поддержки этого формата. Программная эмуляция FP4 приведет к значительным потерям производительности, сводя на нет основные преимущества низкоразрядного квантования. Для MI100 лучше использовать уже устоявшиеся форматы, такие как INT8 или BF16, которые поддерживаются эффективнее и обеспечивают более сбалансированный компромисс между точностью и производительностью.
HIP 7.0, став частью релиза, заметно упростил переносимость кода и добавил инструменты диагностики, полезные при переходе с CUDA. Отдельная поставка системных драйверов и пользовательского стека ROCm теперь позволяет обслуживать кластеры гибче: обновления легче тестировать поэтапно, без риска нарушить стабильность всей системы. Всё это создаёт эффект синергии: код компилируется и переносится быстрее, обновления внедряются проще, а эксплуатационная стоимость при масштабном сервинге моделей снижается.
Поддерживаемые ускорители: куда смещён приоритет
Релиз ROCm 7.0 сфокусирован на свежих ускорителях Instinct, прежде всего на серии MI300 и более новых архитектурах CDNA3/CDNA4. При этом сохраняется поддержка MI200 (MI210, MI250X) и MI100, что обеспечивает плавный переход для существующих кластеров. Однако стратегический приоритет AMD очевиден: именно новейшие GPU становятся площадкой для самых глубинных оптимизаций, включая поддержку низкоразрядных форматов и распределённого инференса в современных фреймворках.
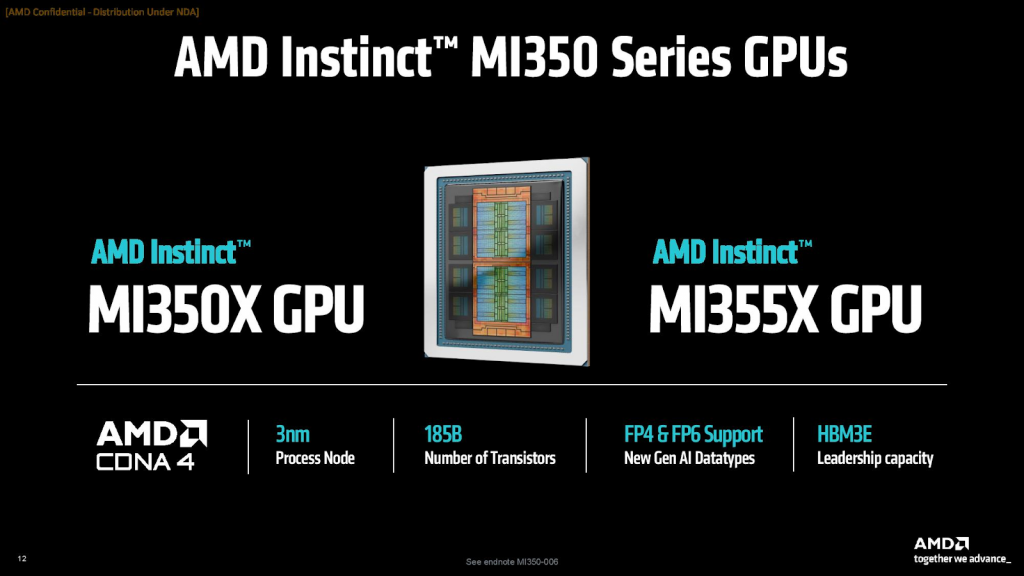
Часть GCN-устройств (например, MI50 и MI60) выведены из официальной поддержки, и это критически важно для планирования жизненного цикла инфраструктуры: такой парк уже может запускаться с HIP 7.0, но без гарантий на стабильность библиотек. Производительность и отладка новых фич приоритетно тестируются на «флагманских» ускорителях, поэтому пользователям старших серий стоит учитывать возможные ограничения в использовании новшеств.
ROCm 7.0 против 6.4: где виден выигрыш
Эффекты от перехода на ROCm 7.0 проявляются сразу в нескольких сценариях. В инференсе больших языковых моделей и мультимодальных систем выигрыши обеспечиваются за счёт низкоразрядных форматов FP8 и FP4, а также обновленной линейки библиотек и компиляторов. Требования к объёму HBM-памяти снижаются, а при той же ёмкости возрастает пропускная способность при обработке токенов.
При дообучении и полномасштабном обучении моделей решающую роль играют доработки в рантайм: улучшенная компиляция графов, оптимизированное размещение данных и более прозрачное профилирование снижают накладные расходы. Хотя абсолютные показатели зависят от конкретной модели и распределителя задач, общее впечатление — скорость перехода от эксперимента к результату заметно возросла.
Для эксплуатации и работы команд SRE важным стал шаг по разделению драйверной и библиотечной части ROCm. Это упрощает обновления и сокращает риск непредсказуемых проблем после патчей ядра или ОС. Поддержка свежих LTS-дистрибутивов минимизирует сбои в пайплайнах CI/CD и делает инфраструктуру предсказуемой в долгосрочной перспективе.
Фреймворки и инструментальная база: что меняется «из коробки»
ROCm 7.0 привносит целый стек актуальных фреймворков и библиотек: PyTorch 2.7 с оптимизациями работы в NHWC-формате, JAX 0.6.0, TensorFlow 2.19.1 с улучшенными средствами тюнинга, ONNX Runtime 1.22.0 и Triton Inference Server 3.3.0. Вместе они обеспечивают готовую совместимость с новыми форматами FP8/FP4 и позволяют использовать оптимизации без ручной компиляции.
Для сценариев масштабирования особое значение имеет углубленная интеграция с Ray, которая даёт возможность разворачивать распределённые вычисления с минимальными вмешательствами в исходный код. Для инференса LLM-доступны продуктивные решения: от минималистичного llama.cpp до vLLM с поддержкой новых форматов чисел. На практике это означает, что переход на ROCm 7.0 сокращает объем «ручной работы» при портировании и уменьшает время между прототипированием и вводом модели в продакшен.
HIP 7.0 и переносимость кода: чего ждать командам, сидящим на 6.x
HIP 7.0 вносит ряд изменений, которые не во всех случаях обратно совместимы с предыдущей веткой. При миграции с ROCm 6.4 в ряде проектов потребуется перекомпиляция кода и корректировка пайплайнов сборки. Такой шаг окупается: новый HIP обеспечивает более предсказуемое поведение при порте CUDA-кода, осмысленные диагностические сообщения и унификацию API с поддержкой низкоразрядных форматов.
Практика миграции подсказывает: разумно временно поддерживать параллельные окружения ROCm 6.4 и 7.0 в реестре, запускать канареечные обновления, прогонять критичные нагрузки через профилировщик и фиксировать показатели производительности и стоимости. Такой подход снижает риски и позволяет обеспечить плавный переход без потерь SLA.
ОС, ядра и виртуализация: эксплуатационные нюансы
ROCm 7.0 официально ориентируется на современные LTS-дистрибутивы: Ubuntu 24.04.3 с ядрами 6.8 GA и 6.14 HWE либо Rocky Linux 9 с ядром 5.14.0-570. Поддержка этих платформ обеспечивает стабильность в продакшене и избавляет от необходимости строить окружения на старых версиях.
Заметным шагом стали улучшения в области виртуализации GPU. Поддержка технологий SR-IOV (Single Root I/O Virtualization) и passthrough на MI300-семействе открывает возможность гибкого распределения GPU-пула между виртуальными машинами в приватных облачных платформах, совместимых с KVM и VMware ESXi 8. При этом важно помнить: разделение драйвера и пользовательского ROCm-стека требует внимательной синхронизации версий при обновлениях базовых образов.
Если у вас MI100/MI210: стоит ли переходить сейчас
MI100 и MI210 остаются в зоне поддержки ROCm 7.0, однако основные оптимизации заметнее на MI300 и выше. Для вычислений в форматах FP16 и BF16 прирост производительности может быть умеренным, а вот переход на FP8 (там, где это возможно) позволяет существенно сократить требования к памяти и увеличить пропускную способность при инференсе.

Практически это означает, что при эксплуатации устойчивых производственных кластеров разумно начать с канареечного обновления, измерить показатели латентности и стоимости обработки токена, и лишь затем переводить весь парк. Если у вас планируется расширение кластера или гибридная эксплуатация вместе с MI300, ROCm 7.0 упрощает унификацию стеков. Если же вы всё ещё связаны зависимостями от ROCm 6.4, придётся закладывать ресурсы на пересборку под HIP 7.0 и обновление системных образов. Таким образом, переход для владельцев MI100/MI210 оправдан в двух случаях: если важен доступ к свежим фреймворкам и контейнерам или если в ваших планах использование низкоразрядных форматов. Для максимально предсказуемых SLA и минимизации рисков на ближайшее время можно остаться на 6.4, подготовив план миграции по чек-листу.
Что «выпало» из поддержки и почему это важно для планирования
С релизом ROCm 7.0 AMD официально завершила поддержку ряда устройств на базе архитектуры GCN, включая профессиональные ускорители Instinct MI50 и MI60. Эти модели могут работать с HIP 7.0, но библиотечные оптимизации на них не гарантируются. Для владельцев таких систем возникает стратегическая необходимость: либо стабилизировать окружения на ветке 6.4, где поддержка сохраняется, либо рассматривать апгрейд в сторону линейки MI300 или профессиональных плат на архитектуре RDNA-Pro. Оба варианта позволяют минимизировать эксплуатационные риски, однако только обновление GPU-парка откроет доступ к ключевым преимуществам ROCm 7.0: производительности, сниженной стоимости инференса и улучшенным возможностям обслуживания.
Выводы
ROCm 7.0 — это не очередное обновление пакетов, а платформенный шаг вперёд. Он смещает экосистему AMD в сторону более дешёвого и масштабируемого инференса, улучшает переносимость кода и повышает предсказуемость эксплуатации в современных дистрибутивах и облаках. Для организаций это означает сокращение сроков между исследованием и внедрением прототипа, возможность контролировать стоимость вычислений и при этом не зависеть от одного вендора экосистемы AI.
AMD последовательно развивает ROCm, расширяя амплитуду поддерживаемых сценариев. Переход на 7.0 логичен для команд, которым важны низкоразрядные числовые форматы, свежие фреймворки и унификация стеков на смешанных пулах GPU. Для обладателей MI100/MI210 рациональным решением станет поэтапная миграция с измерением эффектов; для владельцев устаревших GCN-ускорителей — фиксация на версии 6.4 и стратегическое планирование обновления аппаратной базы. В обоих случаях вектор ясен: ROCm превращается в зрелый стек, готовый к использованию на корпоративном уровне.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год