


Как работают адаптивные форматы FP4, FP8 и FP16: ускорение и сжатие нейросетей на примере GPT-OSS и Qwen

Введение: почему точность стала гибкой
На ранних этапах развития нейросетей вычисления почти всегда выполнялись в одном фиксированном формате, сначала это был FP32, затем более лёгкий и быстрый FP16. Такой подход казался универсальным: один формат —> одна модель —> одно поведение.
Однако с ростом масштабов моделей, особенно трансформеров, стало очевидно: фиксированная точность мешает добиться баланса между производительностью, экономией памяти и сохранением качества. Большие языковые модели, такие как GPT и Qwen, требуют сотен гигабайт видеопамяти и колоссальных вычислительных ресурсов, поэтому каждый бит в представлении числа стал иметь значение.
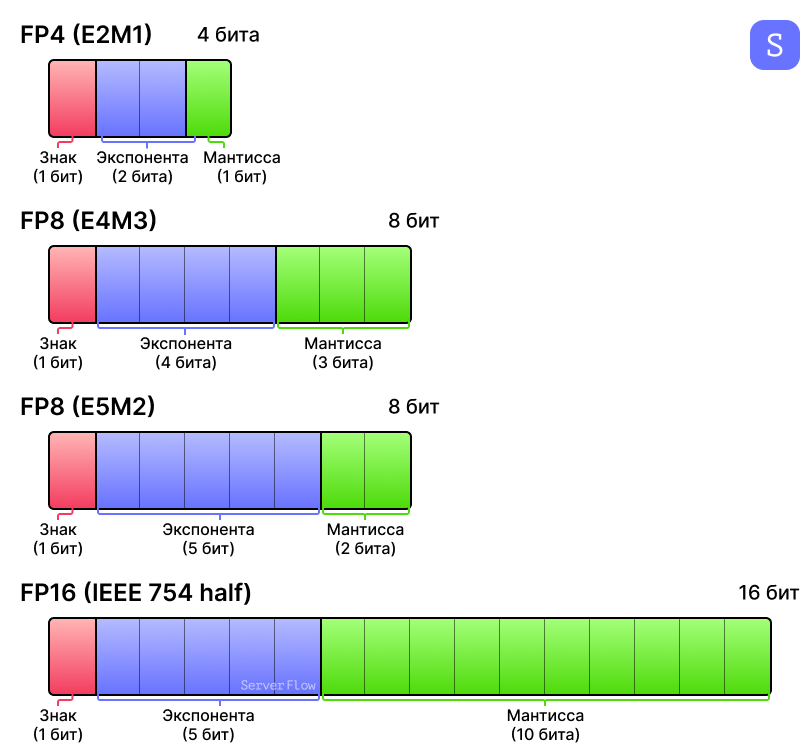
На этом фоне появился инновационный подход: адаптивная точность, при которой формат представления данных может динамически меняться в зависимости от задачи, фазы инференса или чувствительности конкретного слоя. Именно этот принцип лежит в основе форматов FP4, FP8 и FP16, которые сегодня становятся стандартом для ускорения и сжатия нейросетей.
В этой статье мы разберём, как устроены эти адаптивные форматы, почему они важны и как используются в современных ИИ-моделях на примере GPT-OSS от OpenAI и Qwen от Alibaba.
Какие форматы используются в современных моделях
Современные языковые модели всё чаще отходят от универсального формата вычислений. Вместо одной фиксированной точности используется набор числовых представлений, каждый из которых решает свою задачу: от ускорения до агрессивного сжатия. Рассмотрим три формата, которые определяют облик современных нейросетей.
FP16 и BF16 — прежний стандарт
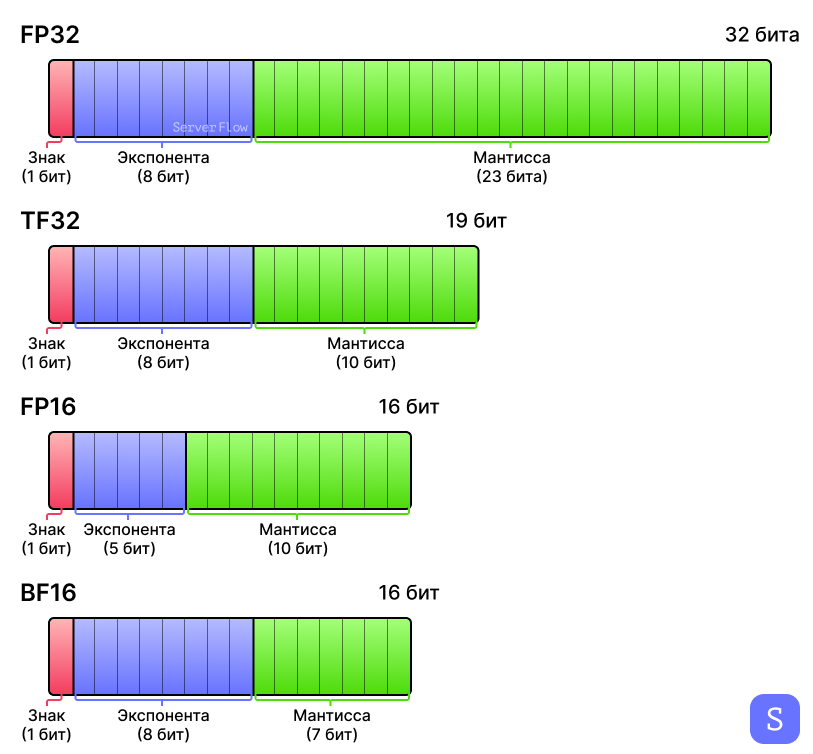
FP16 и его более устойчивый к перепадам значений вариант BF16 были основой большинства моделей последних лет. Они обеспечивают хороший баланс между скоростью и точностью и идеально подходят для обучения и инференса на современных GPU. Однако при работе с языковыми моделями масштабом в десятки и сотни миллиардов параметров этот формат становится избыточным. FP16 занимает слишком много памяти, ограничивая возможности запуска на одном ускорителе.
FP8 — новый мейнстрим
FP4 — экспериментальный, но многообещающий
Что такое адаптивные форматы (и зачем они нужны)
Пример: GPT-OSS и MoE-веса
Пример: Qwen3 и FP8-трассировка
Как это реализуется технически
Механизм переключения точности
Поддержка в аппаратуре
Преимущества адаптивных форматов
Второе преимущество: сокращение объёма памяти. Переход на компактные форматы позволяет снизить потребление видеопамяти на 50–70 процентов без критической потери точности. Это особенно важно для запуска моделей на локальных машинах, где ресурсы ограничены.
Ещё один важный плюс: возможность гибко настраивать компромисс между скоростью и точностью. Разработчик может выбрать, какие части модели можно агрессивно сжать, а какие оставить в более надёжных форматах. Такой подход позволяет балансировать качество генерации и производительность в зависимости от задач.
Наконец, адаптивная точность открывает путь к масштабируемости. Теперь крупные модели помещаются в память одного GPU и не требуют распределённых вычислений. Благодаря снижению объёма и более эффективному исполнению, их можно запускать даже на одиночных ускорителях, что упрощает экспериментирование и снижает технический порог.
Почему это стало возможно только сейчас
Идея адаптивной точности в нейросетях не нова, но долгое время она оставалась теоретической. Основное ограничение заключалось в отсутствии аппаратной поддержки. Форматы вроде FP4 и FP8 просто не могли эффективно обрабатываться на прежних поколениях GPU. Все вычисления приходилось выполнять либо в FP16, либо в FP32, что сводило потенциальную выгоду от более компактных представлений на нет.
Кроме того, фреймворки машинного обучения не были готовы к одновременному использованию разных числовых форматов. Инфраструктура ожидала, что все веса и операции будут приведены к одному типу. Любая попытка вручную смешивать точности приводила к дополнительным затратам на преобразование данных и к нестабильности при обучении или инференсе.
Лишь недавно ситуация начала меняться. Появились архитектуры, такие как NVIDIA Hopper и Blackwell, которые изначально проектировались с учётом поддержки низкоразрядных форматов. Вместе с ними развивались и фреймворки. PyTorch, TensorRT и JAX научились автоматически определять, какая точность нужна в каждом конкретном случае, и выполнять переходы между форматами с минимальными издержками. Появились инструменты, которые позволяют профилировать модель, измерять чувствительность к ошибкам и на этой основе подбирать оптимальное распределение точности по слоям.
Всё это сделало возможным то, что ещё несколько лет назад казалось слишком сложным: обучение и инференс в условиях смешанной точности с минимальной потерей качества и максимальным ускорением.
Заключение: гибкая точность — новая норма
Современные нейросетевые модели больше не ограничиваются одним фиксированным числовым форматом. Вместо этого они переходят к адаптивной точности, где каждый блок, слой или операция может использовать подходящий уровень представления данных. Такой подход помогает ускорить вычисления, уменьшить объём памяти и адаптировать модель под конкретные задачи и ресурсы.
Использование форматов FP4, FP8 и FP16 больше не рассматривается как альтернатива, а становится частью стандартной практики. Эти форматы не конкурируют между собой, а работают вместе. Их можно комбинировать внутри одной модели, выбирая, где допустимо сжать, а где необходима высокая точность.
Раньше такой уровень гибкости был невозможен. Не хватало ни аппаратной поддержки, ни софтверных инструментов. Сегодня ситуация изменилась. Аппаратные ускорители научились обрабатывать разные форматы напрямую, а фреймворки научились распределять точность автоматически. Идея, которая долгое время оставалась концепцией, теперь реализуется в реальных продуктах. Гибкая точность перестала быть экспериментом и стала новой нормой в работе с масштабными ИИ.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год