


Transformer Engine – революция в области генерации токенов ИИ.

Прорыв Nvidia в области AI вычислений.
Мощь современных моделей искусственного интеллекта впечатляет. Их способность понимать и генерировать человеческий язык лежит в основе множества прорывных приложений. Однако за кажущейся легкостью ответа ИИ скрывается ресурсоемкий процесс «размышлений» – пошаговой генерации токенов. Каждый токен (элемент текста) – это результат сложнейших вычислений внутри нейронной сети, требующий неимоверного количества времени и энергии. Фактически, для генерации одного токена модели с сотнями миллиардов параметров (как современные LLM) необходимо выполнить триллионы операций умножения-сложения (FLOPs) по всей глубине сети. Да и сам вывод токенов носит последовательный характер. Каждый следующий токен зависит от всех предыдущих, что создает принципиальное «узкое горлышко» и не позволяет ускорить генерацию текста простым добавлением чипов. Эта неэффективность генерации токенов ограничивает скорость взаимодействия с ИИ, повышает стоимость его эксплуатации и затрудняет масштабирование. Поиск путей кардинального ускорения и оптимизации подвёл компанию Nvidia к созданию поистине прорывной технологии – Transformer Engine.
Что такое Transformer Engine?
Transformer Engine (TE) — это не просто библиотека или алгоритм, а уникальная разработка NVIDIA, объединяющая софтовую и аппаратную часть графического ускорителя для кардинального ускорения обучения и инференса (вывода) моделей искусственного интеллекта, построенных на архитектуре Transformer. К таким моделям относятся все современные Large Language Models (LLMs) типа GPT, Llama, Mistral, Claude и многие другие.
Скорость важнее точности
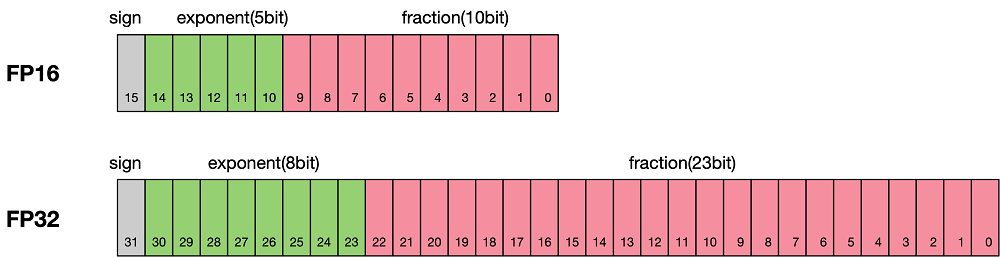
Сердцевиной революции TE является интеллектуальное использование пониженной точности вычислений, прежде всего форматов FP8 и FP4. Несмотря на их значительное отставание от FP32 и FP16 в плане точности, эти форматы кратно превосходят их в скорости и компактности, что критически важно для инференса.
FP8: 8-битные числа с плавающей запятой
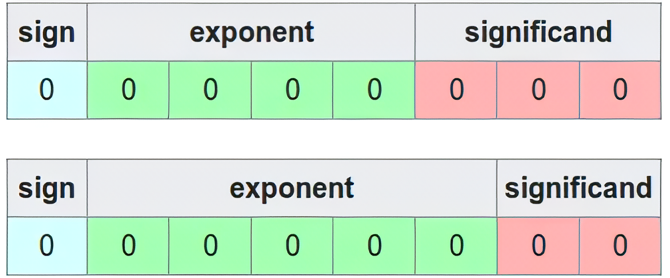
Растущая сложность моделей ИИ, требующая всё больше памяти GPU, привела к появлению в 2022 году формата FP8 — 8-битных чисел с плавающей запятой, оптимизированных для машинного обучения. Этот формат представлен двумя конфигурациями: E4M3 (4 бита под порядок, 3 под мантиссу) и E5M2 (5 бит под порядок, 2 под мантиссу).
Умножение матриц в FP8 выполнится в 2 раза быстрее, чем в FP16, но результат может отличаться на 5-10%. Для инференса ChatGPT это допустимо, для расчета траектории ракеты — нет. К тому же FP8 в четыре раза компактнее FP32 и вдвое компактнее FP16, что позволяет занять меньше памяти и совершить больше вычислений.
FP4: 4-битные числа с плавающей запятой
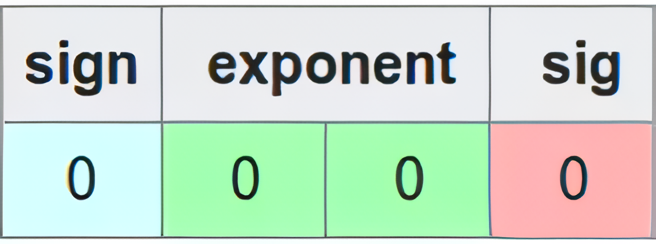
Несмотря на то, что FP4 не имеет аналогов по скорости и компактности, в Transformer Engine он применяется только как вспомогательный инструмент из-за значительной потери точности и крайней нестабильности.
В итоге Transformer Engine обеспечивает ускорение инференса в 5 раз, а обучение моделей происходит в 2 раза быстрее.
Архитектуры в которых имеется Transformer Engine
Hooper – первый носитель технологии
- Динамическое переключение между форматами FP8 (E4M3 для точности, E5M2 для диапазона) в зависимости от слоя нейросети.
- Ускорение обучения трансформеров до 6 раз по сравнению с FP16 (например, для модели Megatron 530B).
- Поддержка тензорных ядер 4-го поколения, оптимизированных для матричных операций в FP8.
Ada Lovelace – Второй шаг
- Ускорения инференса LLM (например, ChatGPT) вдвое (ускорение до 30x в генеративных задачах (текст в изображение), но не для чистого LLM) против предыдущего поколения A100.
- Экономия памяти: FP8 сокращает требования к VRAM в 2 раза, позволяя запускать модели на GPU с 24 ГБ памяти.
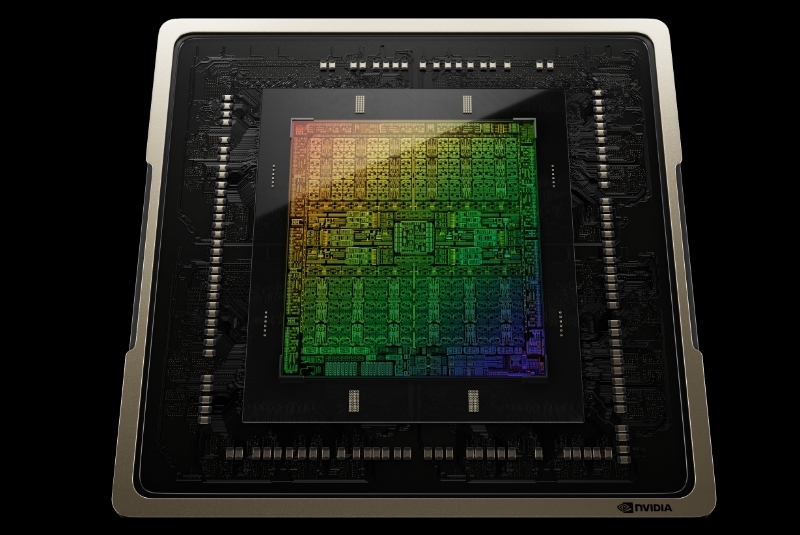
Blackwell как пик технологии
- Улучшенная динамическая обработка данных для тренировки моделей с триллионами параметров.
- Интеграция с NVLink Switch для масштабирования в кластерах ИИ. Это ускоряет инференс триллионных моделей в 30 раз.
- Два кристалла на базе TSMC 4NP с 208 миллиардами транзисторов соединены скоростным интерфейсом NV-HBI (10 ТБ/с), работая как единый GPU. Это позволяет преодолеть физические ограничения размера кристалла и увеличить производительность в 2.5 раза против Hopper.
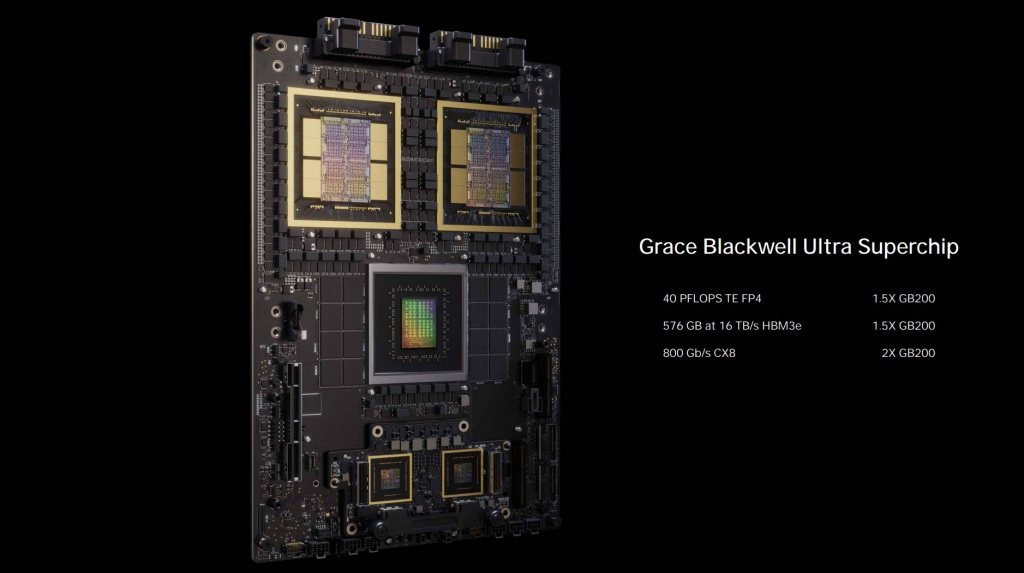
Конец эпохи Токенного Голода
Разрушение Временной Оси: Параллелизм вместо Очереди
Одновременная генерация: Благодаря оптимизации под тензорные ядра Hopper/Blackwell, Transformer Engine обрабатывает до 512 токенов параллельно за один такт. Для сравнения: классические трансформеры на RTX 4090 обрабатывали лишь 128 токенов.
KV-кэширование: Transformer Engine кэширует ключи (Key) и значения (Value) токенов, исключая повторные вычисления. Это сокращает задержку генерации на 40% для диалоговых систем.
Почему это революция?
Почему это не проходная технология от Nvidia, а настоящая революция? Давайте разберёмся:
Токены летят, а не ползут
Ускорение в 5-30x – не сухая цифра. Это исчезновение пауз в диалоге с ИИ, когда ответ рождается на вдохе, а не после мучительного ожидания.
Гиганты помещаются в карман
Многомиллиардные модели (как Llama), некогда требовавшие серверные кластеры, теперь способны существовать в компактных ноутбуках.
TE сжимает их вычислительную мощь, без ущерба функциональности, в аккуратные тонкие девайсы.
Экономия энергии
Сокращение энергопотребления на 50% – это невероятная экономия. В гигантских масштабах вычислений крайне важно, когда каждый ватт тратится не на “разогрев процессоров”, а на рождение идей.
Финал старой эпохи:
Transformer Engine не просто оптимизирует вычисления. Он стирает границу между человеком и машиной, делая общение с ИИ таким же естественным, как дыхание. Токены перестали быть “вычислительной проблемой” – теперь это чистая мысль, льющаяся без усилий. И в этом потоке тонет наше прежнее представление о пределах возможного.
Ответ “красных”
Цена Мощи
Несмотря на программные оптимизации в ROCm и аппаратные преимущества новых моделей Instinct, AMD серьёзно уступает Nvidia в продажах. На первый квартал 2025 года у Nvidia 92% рынка, у AMD 8%, а у Intel и вовсе меньше одного процента.
Вывод
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год