


Дебют AMD в MLPerf Training 5.0 — MI325 теперь эффективнее H200

Введение
4 июня 2025 года AMD приняла участие в тестировании ИИ-решений MLPerf Training 5.0, в рамках которого были определены лучшие ускорители для машинного обучения и ключевые показатели их эффективности. Это событие подчеркивает, что компания AMD нацелена на масштабный выход на рынок искусственного интеллекта и усиление конкуренции с Nvidia, которая в настоящее время является лидером в этом секторе.
Зачем AMD участвовать в MLPerf Training 5.0?
Обучение ИИ становится все более и более востребованной сферой — многие крупные компании все чаще предпочитают самостоятельно обучать генеративные языковые модели под свои нужды, а не использовать заранее предобученные LLM. Для более точного обучения и более экономичного развертывания, корпорации используют LoRA-модели. LoRA — это передовой метод тонкой настройки ИИ, который добавляет в модель небольшое количество обучаемых параметров. Во время обучения предварительно обученная модель замораживается и квантуется, что значительно снижает требования к памяти и вычислительным ресурсам. Ввиду этого, ключевым направлением развитие крупных ИИ-ориентированных корпораций, таких как AMD и Nvidia, становится разработка аппаратных и программных решений, которые предлагают наиболее эффективные возможности для обучения LLM. Для этих целей компания AMD предлагает ИИ-ускорители Instinct MI300X и MI325X и программный стек ROCm, которые в совокупности обеспечивают конкурентоспособную производительность в инференсе и, самое главное, обучении LLM. Для того, чтобы наглядно продемонстрировать и зафиксировать это, AMD решила принять участие в тестировании MLPerf Training 5.0 (вышло 4 июня 2025 года), которое проверит эффективность ИИ-решений компании при тонкой настройке языковой модели Llama* 2-70B-LoRA.
Результаты ускорителей AMD Instinct в тестах MLPerf 5.0 Training
В первых тестах обучения Llama* 2-70B-LoRA на базе ускорителей Instinct MI325X, ускорителям AMD удалось обойти по производительности решения NVIDIA H200 на 8%. Это одно из главных достижений, которое свидетельствует об ускорении темпов развития ИИ-решений компании, поскольку AMD удалось значительно уменьшить технологический разрыв между оборудованием Nvidia. Вполне возможно, что релиз передовых ИИ-ускорителей Instinct MI350X и Instinct MI355X, который запланирован на конференцию Advance AI 2025, еще больше укрепит позиции AMD на рынке ИИ. Тем не менее, очевидно, что AMD в данный отстает от передовых устройств Nvidia на одно поколение, чем и обуславливается сравнение именно с ускорителями на архитектуре Hooper, а не с наиболее современными Blackwell.
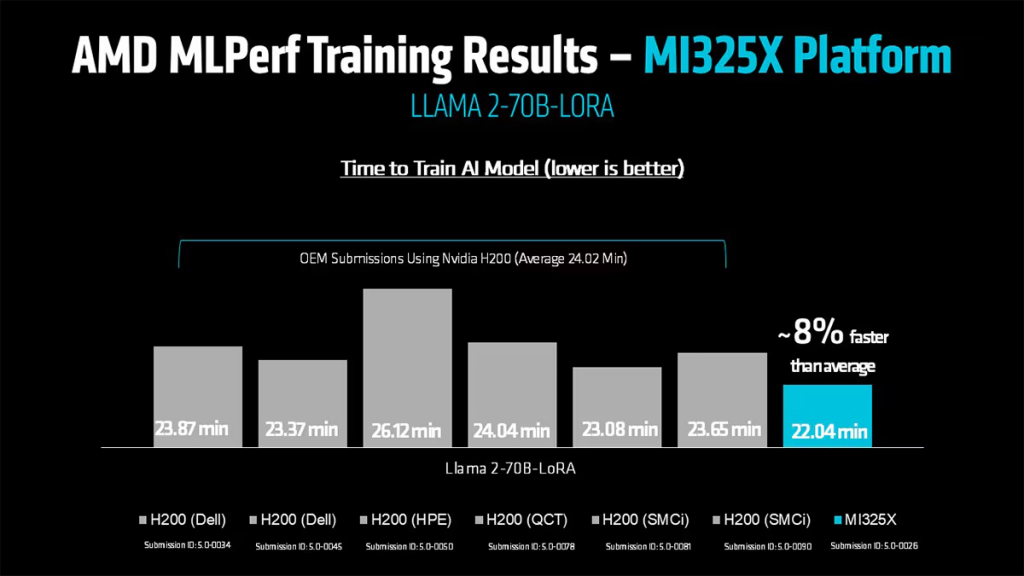
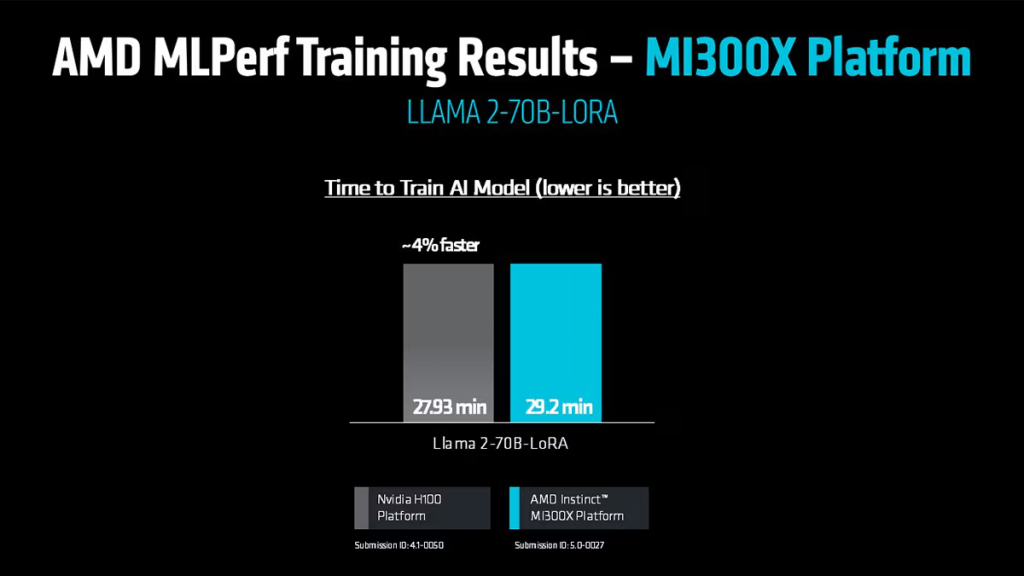
Помимо этого, менее производительные ускорители AMD Instinct MI300X также обеспечивают конкурентоспособную ИИ-эффективность по сравнению с платформой H100 при аналогичных накладных расходах, что и у решения Nvidia. Конечно, прирост производительности обучения на базе Instinct MI300X минимален (всего на 4% быстрее), но отличное соотношение цены и качества в сравнении с решениями Nvidia может сместить выбор пользователей в сторону устройств AMD.
Результаты Instinct от партнеров AMD в тестах MLPerf 5.0 Training
В бенчмарке также приняли участие ИИ-ускорители Instinct MI300X и MI325X в вычислительных системах от OEM-производителей и партнеров AMD, в частности, решений компаний Supermicro, MangoBoost, Dell, Oracle, Gigabyte и QCT. Все решения тестировались в одной задаче (тонкая настройка Llama* 2-70B-LoRA) и показали разные результаты эффективности при работе в различных инфраструктурных средах, что демонстрирует универсальность ИИ-ускорителей от AMD. Рассмотрим, как справились устройства от OEM-производителей:
- Supermicro использовала GPU-систему на базе Instinct MI325X с жидкостным охлаждением, достигнув результата в 21,75 минут. Это лучший результат для систем на базе Instinct MI325X. Помимо отличной ИИ-производительности, Supermicro также обеспечивала высокую энергоэффективность и отличные возможности масштабирования системы, что обуславливается использованием жидкостной системы охлаждения.
- MangoBoost использовала одноузловую систему на базе 8 GPU Instinct MI300X, обучив языковую модель за 29,6 минут. MangoBoost также задействовала в тестах более производительные платформы с 16 и 32 GPU Instinct MI300X, которые обучили модель за 16,32 и 10,92 минут соответственно. Такой подход показывает возможности эффективного масштабирования ускорителей Instinct MI300X.
- Dell со своей платформой на базе 8 GPU Instinct MI300X продемонстрировала средние результаты, завершив обучение за 28,99 минут.
- Oracle показала худший результат среди других OEM-производителей, настроив языковую модель за 30,42 минут, используя платформу на базе MI300X в конфигурации 8 GPU.
- Gigabyte в тесте производительности использовала платформу на базе 8 GPU MI325X настроив языковую модель за 22,1 минут.
- QCT представила аналогичные результаты для конфигурации MI325X с 8 GPU, обеспечив скорость обучения в 22,43 минут.
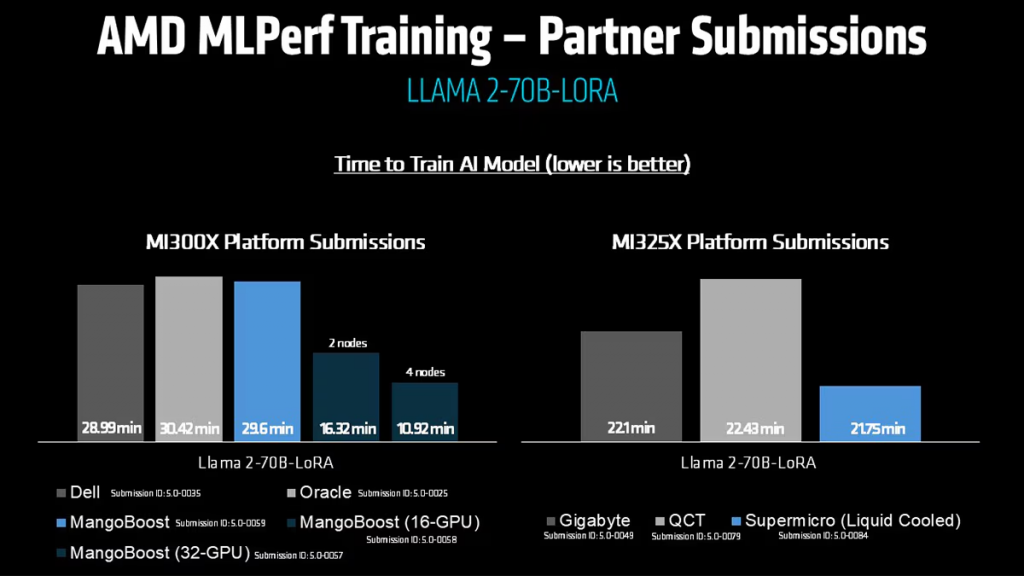
Тестирование разных OEM-платформ на базе решений серии Instinct MI300 демонстрирует не только ИИ-производительность этих ускорителей, но и доказывает их эффективность при работе в системах с воздушным/жидкостным охлаждением и одноузловой/многоузловой архитектурой.
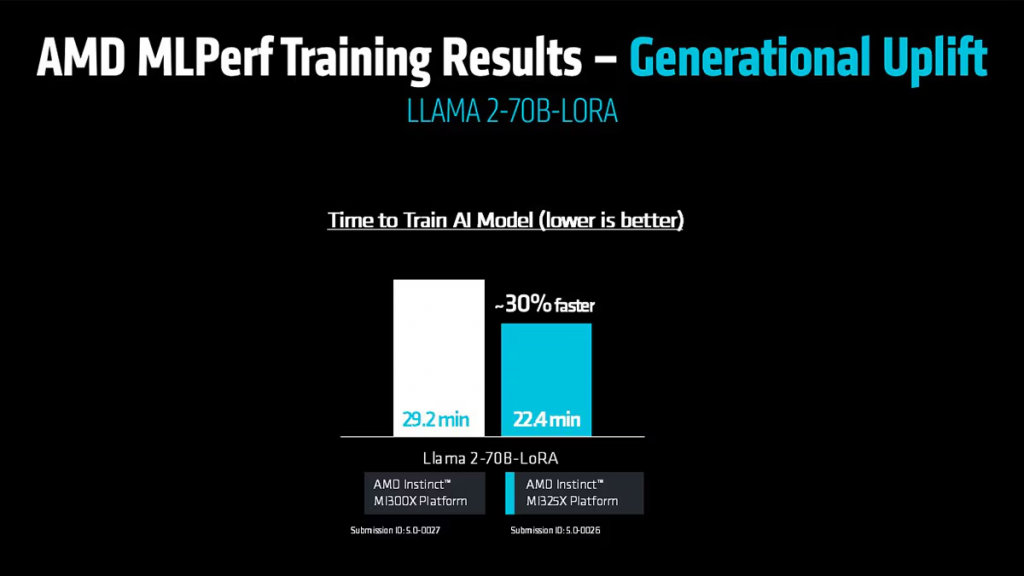
Также AMD продемонстрировала прирост ИИ-производительности между решениями Instinct MI300X и MI325X. Тест показал, что старшее поколение MI325X в 30% превосходит решение MI300X в задачах обучения искусственного интеллекта.
Роль программного стека ROCm
AMD напрямую заявляет, что столь высоких показателей компании удалось добиться благодаря использованию передового программного стека ROCm v6.5, который в данный момент недоступен для широкого круга пользователей. AMD подчеркивает, что за последние несколько лет компании удалось решить многие недостатки своей программной ИИ-платформы, сделав ее намного более полезнее и производительнее. При выполнении задачи тонкой настройки Llama* 2-70B-LoRA, платформа ROCm сыграла наиболее значимую роль, обеспечив максимальный уровень производительности графических процессоров Instinct MI325X и MI300X благодаря использованию инструмента Flash Attention, движка Transformer Engine и настройки ИИ на уровне оптимизатора. Помимо этого, при обучении также применялся оптимизированный контейнер Docker.
Сравнение с результатами Nvidia в тестах MLPerf 5.0 Training
Несмотря на все выдающиеся достижения AMD, ИИ-производительность ускорителей компании все еще не может сравниться с эффективностью передовых решений Nvidia, которые также участвовали в тестировании MLPerf 5.0 Training. Nvidia выставила на оценку свои ИИ-ускорители GB200, в результате чего бенчмарк продемонстрировал рекордные показатели скорости при обучении модели Llama* 2-70B-LoRA, достигнув 10,34 минут при использовании кластера NVL72 с 8 GPU GB200. Эти результаты более чем в 2 раза превышают ИИ-эффективность ускорителей AMD Instinct MI325X.
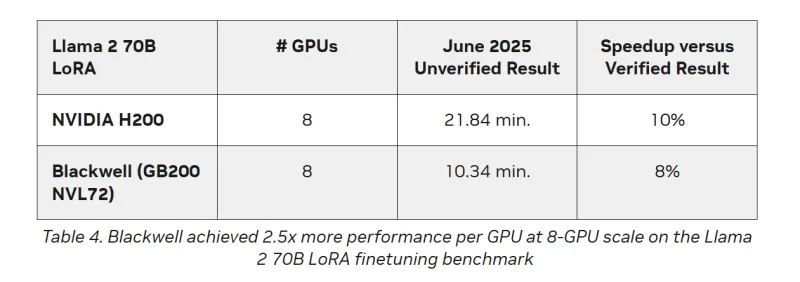
Помимо модели Llama* 2-70B-LoRA, Nvidia также продемонстрировала лучшие результаты при обучении модели Stable Diffusion v2, завершив настройку за 12,86 минут при использовании чипов GB200, а при обучении большой языковой модели Llama* 3.1 405b ИИ-кластер NVL72 с 512 чипами GB200 настройка была завершена за 121,09 минут.
Выводы
Не стоит отрицать, что компания AMD достигла больших высот в рамках своей стратегии AMD 2.0 по наращиванию конкурентоспособности на рынке ИИ — с каждым годом ИИ-ускорители компании обеспечивают значительный прирост производительности, поэтому не исключено, что в следующем бенчмарке MLPerf Training, AMD сможет выйти в лидеры и начать на равных соперничать с устройствами Nvidia. Тем не менее, Nvidia тоже не стоит на месте и будет оставить свои позиции в секторе ИИ, поэтому AMD придется приложить немало усилий, чтобы представить эффективное решение, которое будет эквивалентно по производительности устройствам на базе архитектуры Blackwell и будущей платформы Rubin.
*LLAMA — проект Meta Platforms Inc.**, деятельность которой в России признана экстремистской и запрещена
**Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год