


Что такое Hugging Face и почему там столько моделей нейросетей

Введение
Любая ML-команда рано или поздно сталкивается с одной и той же триадой проблем: где взять модель, как убедиться, что завтра она поведет себя так же, как сегодня, и как быстро вынести ее в продакшн без написания сотен строк инфраструктурного кода. До появления Hugging Face ответом на эти вопросы была комбинация из личных Google Drive и корпоративных S3-бакетов.
Сегодня Hugging Face – это де-факто стандарт распространения моделей в индустрии: крупнейшие лаборатории – Mistral, Meta, Google, Microsoft, Stability AI – публикуют свои релизы прежде всего на Hub, а не на своих серверах.
Что такое Hugging Face
Hugging Face – это одновременно компания, публичный Hub и набор open-source библиотек. Hub представляет собой централизованный репозиторий для хранения моделей, датасетов и демо-приложений (Spaces).
Библиотеки – Transformers, Diffusers, Datasets, PEFT, TRL и другие – формируют полный жизненный цикл ML: от загрузки предобученной модели и тонкой настройки до сервинга в продакшне. Вместе Hub и библиотеки образуют связную среду, в которой артефакт, созданный на одном этапе, без трения переходит на следующий.
Чем Hugging Face отличается от «просто GitHub»
GitHub – это система контроля версий кода. Hugging Face – это реестр ML-артефактов, и разница принципиальная. В GitHub репозиторий хранит текстовые файлы, а Hugging Face хранит бинарные веса размером от сотен мегабайт до сотен гигабайт с поддержкой частичного скачивания и LFS-совместимого хранения.
На Hub существуют особые сущности – model card и dataset card: структурированные README с метаданными в YAML-шапке (задача, язык, лицензия, метрики), которые индексируются и доступны для фильтрации.
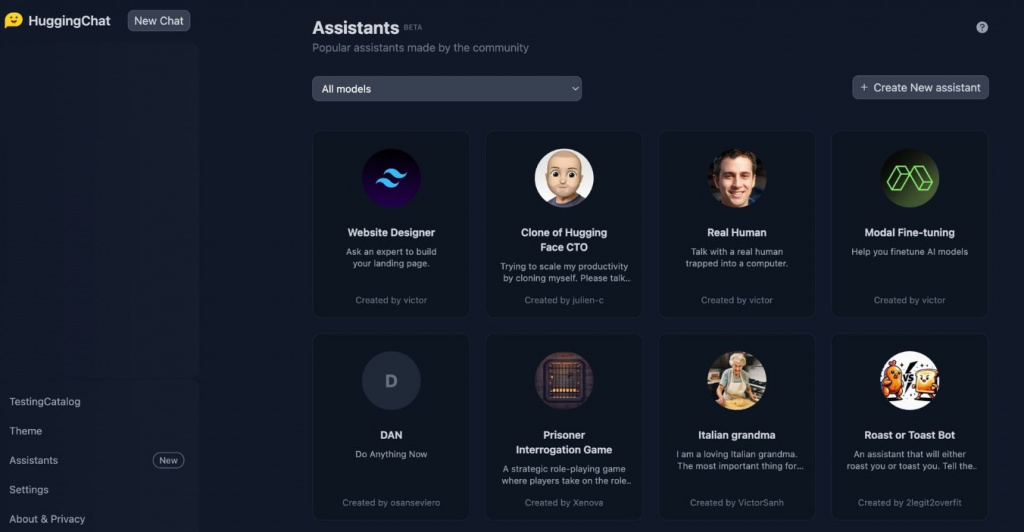
Виджет инференса прямо в браузере позволяет опробовать модель без единой строки кода. Наконец, механизм gated access дает владельцу модели контроль над тем, кто и на каких условиях может ее скачать – функциональность, для которой в GitHub нет аналога.
Executive summary
Ниже приведены ключевые тезисы, которые позволяют быстро оценить роль Hugging Face в стеке конкретной организации:
- более 2 млн. моделей и 500 тыс. датасетов – крупнейшее хранилище в мире;
- Transformers работает с PyTorch, TensorFlow и JAX – неважно, что использует ваша команда;
- можно зафиксировать конкретную версию модели по хешу (pinned revisions), чтобы обновления автора не сломали ваш код;
- техника PEFT/LoRA позволяет дообучать большие модели на обычных видеокартах (8-16 ГБ), а не тратить миллионы на суперкомпьютеры;
- Inference Endpoints поднимают модель за минуты без DevOps. Для своих серверов есть бесплатные аналоги (TGI, vLLM);
- некоторые (Llama, Gemma) нужно запрашивать вручную – учтите это при автоматизации;
- есть свободные лицензии (MIT, Apache), есть только для некоммерческого использования, есть проприетарные;
- Enterprise-тариф дает приватные хранилища, единый вход (SSO) и контроль доступа;
- Safetensors – новый стандарт весов, значительно ограничивающий возможности хакеров внедрить вредоносный код (в отличие от старых .bin файлов).
Эти тезисы формируют базу для осознанного решения о внедрении – без маркетинговых упрощений и без избыточного скептицизма.
История и роль в индустрии
Понимание истории Hugging Face важно не для общей эрудиции, а для понимания того, почему платформа устроена именно так и какие архитектурные решения являются следствием эволюции, а не случайными выборами:
- 2016-2018. Основание как стартапа с чат-ботом для подростков.
- 2019. Публикация библиотеки Transformers, ставшей стандартом для работы с трансформерами (BERT, GPT-2). Переломный момент – переход от продукта к инфраструктуре.
- 2020-2021. Запуск публичного Hub (реестра моделей). Крупные лаборатории начинают публиковать модели напрямую.
- 2020-2022. Запуск Spaces и библиотеки Datasets. Проведение инициативы BigScience с релизом открытой LLM BLOOM.
- 2022-2023. Взрывной рост благодаря Llama (Meta). Hub становится главной площадкой для open-weight LLM. Запуск Inference Endpoints, появление PEFT и TRL.
- 2024-2025. Развитие enterprise-функций (приватные инсталляции, governance) и интеграция с облаками через Inference Providers.
Ключевой вывод из этой истории: Hugging Face – не изначально спроектированная платформа, а органически выросшая экосистема.
Карта экосистемы Hugging Face
Экосистему удобно представлять как четыре концентрических блока, каждый из которых добавляет новый уровень абстракции поверх предыдущего.
Hugging Face Hub (Models / Datasets / Spaces)
Hub – это три типа репозиториев с единым Git-совместимым бэкендом. Репозитории моделей содержат веса, конфиги, токенизаторы и model card.
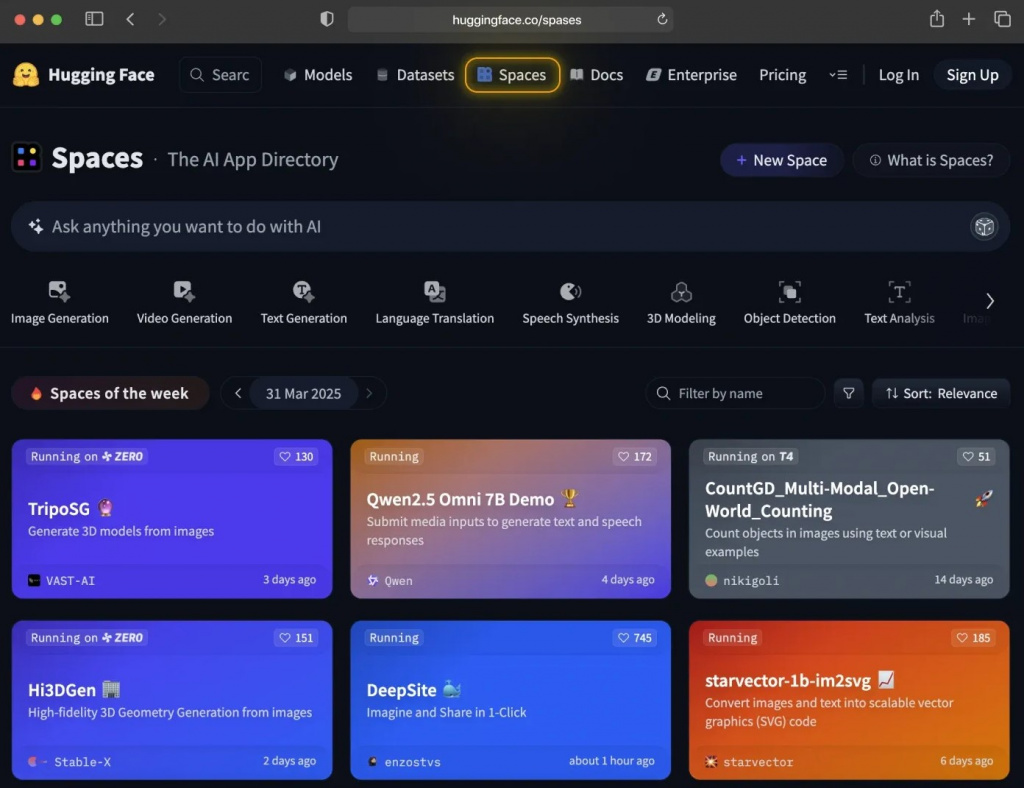
Репозитории датасетов – данные в различных форматах (Parquet, JSON, CSV, Arrow) и dataset card с описанием источника, метода сбора и ограничений. Spaces – это задеплоенные Gradio или Streamlit приложения, работающие на управляемых контейнерах HF. Каждый тип репозитория может быть публичным, приватным или принадлежать организации.
Библиотеки и инструменты
Библиотечный слой Hugging Face охватывает весь ML lifecycle – от загрузки данных до деплоя финальной модели. Ключевые библиотеки и их назначение:
- Transformers – инференс и обучение языковыхмоделей;
- Diffusers – генерация изображений и видео;
- Datasets – загрузка, кеширование и препроцессинг данных;
- Tokenizers – быстрая токенизация на Rust;
- Accelerate – прозрачная поддержка multi-GPU и mixed precision;
- PEFT – адаптеры (LoRA, QLoRA, prompt tuning);
- TRL – обучение с подкреплением;
- Safetensors – безопасный формат хранения весов.
Также доступен huggingface_hub – CLI и Python API для работы с Hub.
Инференс и сервинг
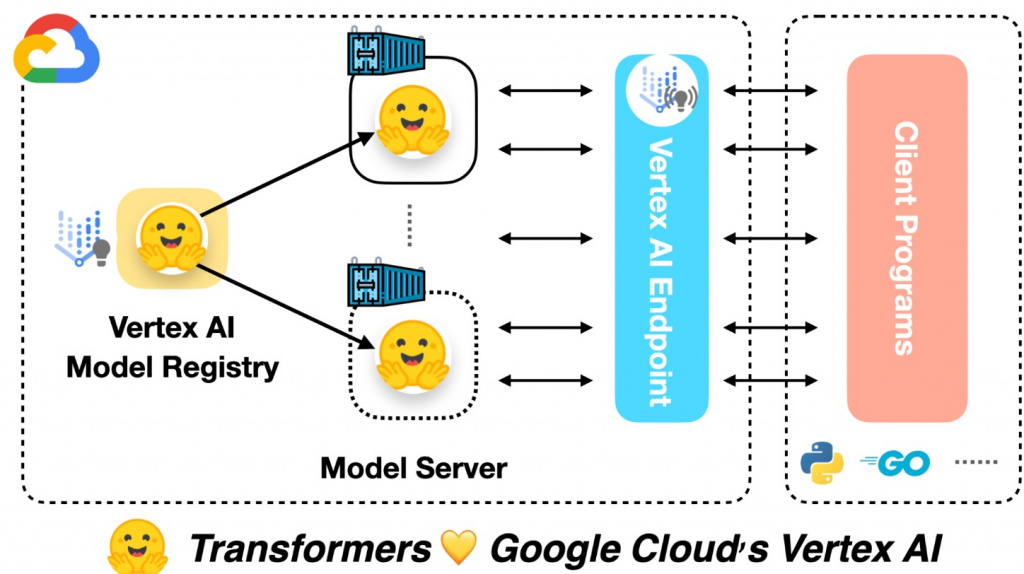
Hugging Face предлагает два пути для продакшн-инференса. Managed-путь: Inference Endpoints – это полностью управляемый сервис, где пользователь выбирает модель, тип инстанса и регион, а HF берет на себя деплой, масштабирование и мониторинг.
Inference Providers – интеграция с партнерскими облаками (AWS, Azure, Replicate и другие), позволяющая запускать модели через единый API.
Обучение и тюнинг
Для обучения и тонкой настройки Hugging Face предоставляет Trainer API внутри библиотеки Transformers – он покрывает стандартные сценарии supervised fine-tuning. Для распределенного обучения используется Accelerate, который абстрагирует различия между PyTorch DDP, DeepSpeed и FSDP.
Коммерческие и enterprise-возможности
Enterprise-план переводит сервис из публичного инструмента в управляемую корпоративную платформу. Ключевые возможности: приватные репозитории с гранулярным контролем доступа, SSO через SAML/OIDC, аудит-лог всех действий с артефактами, управление токенами на уровне организации (revoke/rotate без участия пользователя), возможность развернуть Hub в собственной инфраструктуре (Hub Enterprise on-prem).
Hugging Face Hub – что это такое?
Репозиторий на Hugging Face внешне напоминает GitHub-репозиторий, но отличается по смыслу хранимых артефактов и механикам работы с ними.
Репозиторий модели содержит веса (Safetensors/PyTorch), config.json, файлы токенизатора, generation_config.json и model card (README.md). В датасетах – данные (Parquet/JSON) и скрипты загрузки. Spaces – код приложения и зависимости.
Model Cards – это машиночитаемый паспорт модели. YAML-шапка содержит тип задачи (pipeline_tag), лицензию и метрики. В текстовой части ключевой раздел – limitations, где указаны известные ограничения и смещения модели.
Hub использует Git. Для production критически важно использовать фиксацию ревизий (pinned revisions) – указание конкретного хеша коммита вместо ветки main (параметр revision в from_pretrained). Это гарантирует, что обновления автора не сломают ваш пайплайн. Теги (v1.0) менее надежны.
Лицензии: как смотреть, как выбирать, типовые варианты
Лицензии указаны в поле license model card. Ключевое правило – проверять перед коммерческим использованием. Типовые варианты:
- Apache 2.0, MIT, CC-BY-4.0 – разрешают коммерческое использование с указанием авторства (attribution);
- CC-BY-NC-4.0 – только для некоммерческого использования (требуется отдельное соглашение для бизнеса);
- Llama Community, Gemma Terms – проприетарные, часто с ограничениями по числу пользователей и запретом на дистилляцию;
- RAIL – запрещает конкретные вредоносные сценарии.
Если лицензия не из первых трех вариантов – внимательно читайте полный текст. Для скачивания требуется согласие с условиями и часто верификация (например, Llama 3, Gemma). В CI/CD нужно использовать токен аккаунта, который уже прошел gating вручную.
Библиотеки Hugging Face – кто за что отвечает
Экосистема библиотек Hugging Face выглядит монолитно снаружи, но внутри каждая библиотека решает строго определенную задачу и имеет свои ограничения:
| Библиотека | Назначение | Ключевые сценарии | Ограничения |
| Transformers | Инференс и обучение трансформеров | Pipelines, fine-tuning, generation | Большой VRAM для крупных моделей; trust_remote_code=True – риск |
| Diffusers | Генерация изображений/видео | Stable Diffusion, FLUX, AnimateDiff | Высокие требования к GPU; большие веса |
| Tokenizers | Быстрая токенизация (Rust) | Предобработка данных, batch inference | Несовместимость спецтокенов между моделями |
| Datasets | Загрузка и препроцессинг данных | Стриминг, кеш, map/filter | Кеш занимает много места; медленно работает на HDD |
| Accelerate | Distributed training, multi-GPU | DDP, DeepSpeed, FSDP | Конфигурация нетривиальна для сложных топологий |
| PEFT | Parameter-efficient fine-tuning | LoRA, QLoRA, IA3, prompt tuning | Не все архитектуры поддерживаются |
| TRL | RLHF, DPO, preference tuning | Выравнивание LLM, reward modeling | Требует аккуратности: легко переобучить |
| Safetensors | Безопасное хранение весов | Загрузка без риска pickle-эксплойтов | Не все старые модели конвертированы |
| Huggingface_hub | API и CLI для Hub | Auth, download, upload, revisions | Требует токен для gated и приватных репо |
Практические сценарии использования
Локальное использование
- Установка библиотек: pip install transformers accelerate.
- Авторизация (только для gated моделей): hf login.
- Загрузка и инференс через pipeline: from transformers import pipeline; pipe = pipeline(‘text-generation’, model=’mistralai/Mistral-7B-Instruct-v0.3′); result = pipe(‘Hello!’).
Дообучение моделей
Опубликовать модель/датасет с корректной документацией
- корректная лицензия в YAML-шапке;
- заполненные поля pipeline_tag и language;
- раздел intended use с конкретными задачами;
- раздел limitations с честным описанием ограничений;
- пример кода inference в README;
- метрики на хотя бы одном стандартном бенчмарке.
Развернуть инференс как сервис
Инфраструктура и MLOps
Кеширование и офлайн-режим
Контроль версий и воспроизводимость
Безопасность
Риски скачивания моделей и датасетов
Официальные механизмы сканирования
Практики защиты – чеклист
- использовать только Safetensors файлы там, где это возможно;
- никогда не использовать trust_remote_code=True для моделей из непроверенных источников;
- фиксировать все используемые ревизии через хеши коммитов и проверять их при обновлении;
- завести allowlist допустимых организаций/авторов на Hub (например, meta-llama, google, mistralai, microsoft);
- провести юридический аудит лицензий всех используемых моделей и датасетов.
Коммерческая модель и роли в организации
Сравнение с альтернативами
В чем HF похож на GitHub и Package Registry
Альтернативные хабы и платформы
- Ollama – локальный запуск моделей с простым CLI, ориентирован на разработчиков без ML-бэкграунда, не является реестром артефактов;
- GGUF/llama.cpp экосистема – community-конвертации моделей в квантованный формат, часто размещенные на HF Hub (TheBloke, bartowski);
- MLflow Model Registry – enterprise-решение для версионирования моделей внутри организации, интегрируется с существующими MLflow-пайплайнами.
Чеклист выбора и внедрения
- Go (продолжаем). Лицензии моделей одобрены юристами, артефакты воспроизводимы в CI/CD, скорость загрузки приемлема (или настроено зеркало), сканирование безопасности не выявило критических уязвимостей.
- No-Go (останавливаемся). Обнаружены модели с несовместимой лицензией, требования к месту хранения данных (data residency) нарушены, или стоимость managed-решений не соответствует целевым SLA.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год