


Что такое EmbeddingGemma и как она улучшает локальный RAG

Введение
В контексте моделей для эмбеддингов большинство пользователей представляет что-то громоздкое, облачное, требующее GPU и терпения. EmbeddingGemma ломает этот стереотип. Это легкая мультиязычная модель на базе Gemma 3, созданная для того, чтобы векторизовать тексты быстро, локально и без утечек данных.
Модель умеет одно, но делает это хорошо: превращает слова и фразы в устойчивые векторы, пригодные для поиска, классификации, RAG и семантического анализа. И делает это с той же философией, что и вся линейка Gemma: эффективность, приватность и открытость. Давайте же узнаем о ее возможностях более подробно.
Что это такое?
EmbeddingGemma – это модель, которая не пишет тексты, а понимает их. Ее задача – превращать предложения, документы и запросы в числовые вектора, отражающие смысл. Такие векторы можно сравнивать, искать по ним схожие фрагменты или группировать по смыслу. Это базовый строительный блок для retrieval-систем, RAG, а также для методов семантического поиска, классификации и кластеризации.
В отличие от больших LLM вроде Gemma 3 или Gemini, EmbeddingGemma не отвечает на вопросы и не генерирует текст. Она – энкодер, то есть «понимающая» часть, которая создает осмысленные представления данных, пригодные для анализа.
Краткая справка
Эмбеддинг – это способ представить текст в виде числового вектора, где похожие по смыслу слова и фразы оказываются рядом. Например, выражения «купить билет» и «оформить поездку» будут иметь близкие векторы, а «кошка» и «автомобиль» – нет.
Для разработчиков это ключ к «пониманию смысла» на машинах. Эмбеддинги позволяют строить умный поиск, группировать документы, ранжировать ответы и связывать неструктурированные данные. Если раньше система сравнивала строки буквально, теперь она сравнивает значения.
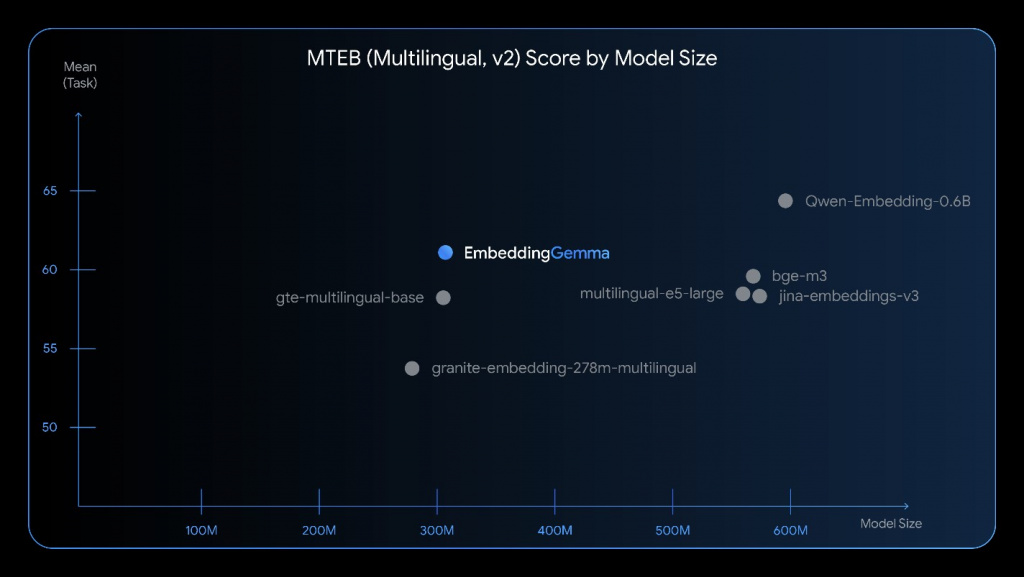
EmbeddingGemma обучена на множестве языков и доменов, что делает ее пригодной для глобальных задач: от поиска по архивам до RAG-систем для внутренних баз знаний.
Характеристики
По архитектуре и параметрам EmbeddingGemma – компактная, но зрелая модель:
- Около 308 миллионов параметров (около 100M в архитектуре и 200M в эмбеддингах); это делает ее относительно небольшой по сравнению с крупными LLM (например, с 10–20 миллиардами параметров у современных открытых моделей вроде Gemma 3 или аналогов от OpenAI);
- Контекстное окно – 2048 токенов, чего вполне достаточно для среднего документа или сообщения;
- Поддержка более 100 языков, включая русский, английский, китайский, арабский и другие;
- Несколько размерностей эмбеддингов, включая 768, 512, 256 и 128, чтобы можно было балансировать между качеством и скоростью;
- Модели обучены с учетом последующей квантизации, что позволяет использовать их даже на слабом «железе»;
- Потребление памяти до 200 МБ для квантизованных вариантов (например, q4_0 или q8_0), что делает модель подходящей для мобильных устройств и edge-платформ;
- Быстрый отклик – он составляет около 15-22 мс на EdgeTPU при обработке 256 токенов (по данным разработчиков).
Все версии распространяются по Gemma Terms – открытые веса, но с условиями ответственного использования.
Где уместна
EmbeddingGemma задумывалась как инструмент для он-девайс и офлайн-сценариев. Ее применяют там, где важны приватность и мгновенный отклик, а подключение к облаку нежелательно или невозможно. Примеры задач, где хорош этот инструмент:
- Локальный RAG – система, которая ищет контекст в документах и передает его генеративной модели;
- Офлайн-поиск по письмам, заметкам, PDF или внутренним файлам;
- Приватные чат-боты-ретриверы, работающие без отправки данных наружу;
- Классификация и кластеризация текстов на мобильных или настольных устройствах;
- Семантический поиск в продуктах, где нельзя полагаться на интернет или внешние API.
Фактически EmbeddingGemma – это первая мультиязычная модель такого уровня, которая чувствует себя дома не в облаке, а прямо на вашем устройстве. Реальные кейсы включают: интеграцию в мобильные приложения для поиска по личным заметкам (например, в Evernote-подобных сервисах), корпоративные RAG-системы для анализа внутренних документов без облачных API, или браузерные расширения для семантического поиска по локальным файлам.
Архитектура и обучение
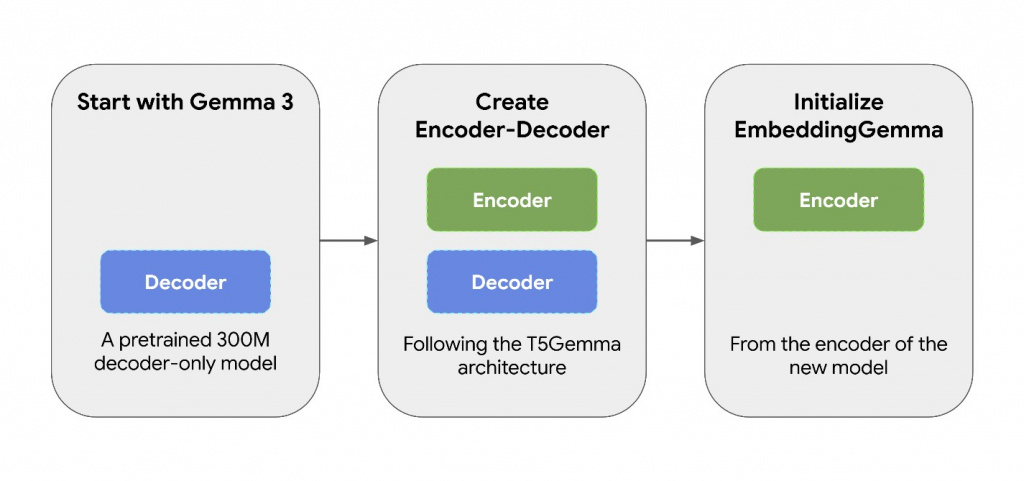
Внутри EmbeddingGemma – продуманный инженерный слой, который превращает привычный decoder-only Gemma 3 в эффективный энкодер для эмбеддингов.
Главная особенность – двунаправленное (некаузальное) внимание, которое позволяет модели смотреть на текст целиком, а не шаг за шагом. Это важно, когда нужно понять смысл фразы в контексте, ведь лучше видеть весь текст одновременно.
Для обучения использован специальный «рецепт»: Noise-Contrastive Estimation (NCE) помогает модели отличать похожие и непохожие тексты, а Global Orthogonal Regularizer (GOR) поддерживает правильную структуру пространства эмбеддингов. Вместе они формируют компактное, но информативное представление текста.
Encoder-decoder инициализация
Прямой перенос весов из decoder-only модели недостаточен: структура внимания меняется, а значит, нужно настроить энкодер на новый режим работы. Для этого используют специальные методы инициализации: они помогают модели унаследовать знания от больших моделей Gemma, сохранив их языковое и семантическое понимание, и корректно работать в двунаправленном режиме.
Geometric embedding distillation
Геометрическая дистилляция – ключевой прием, который позволяет маленькой модели унаследовать «геометрию» пространства эмбеддингов от большой модели. То есть близкие по смыслу тексты остаются близкими, а далекие – разнесены, даже если сама модель меньше и проще. Этот шаг критически важен для того, чтобы компактная EmbeddingGemma не теряла качество при уменьшении числа свойств.
Spread-out regularization
Regularization spread-out повышает разнообразие векторов. Без него эмбеддинги могут скапливаться в одном уголке пространства, теряя различимость. Spread-out помогает моделям быть устойчивыми к доменным сдвигам: если входные данные немного отличаются от тренировочного корпуса, векторы все равно остаются информативными и различимыми.
MRL и усечение размерности
Multi-Resolution Latents (MRL) позволяет выбирать размерность векторов: 768, 512, 256 или 128. Вот что это означает:
- 768 – максимальное качество и детализация;
- 512 – компромисс между скоростью и точностью;
- 256/128 – для мобильных устройств, экономии памяти и диска.
Выбор зависит от конкретной задачи: если важна скорость и небольшой footprint – берем меньшую размерность. Если критично качество семантической близости – оставляем 768.
Производительность и бенчмарки
На момент релиза – 4 сентября 2025 года – EmbeddingGemma заняла позицию лидера среди открытых мультиязычных моделей с размером до 500 миллионов параметров. Она уверенно вошла в верхние строчки MTEB и MMTEB, показав, что компактность не обязательно означает компромисс в качестве.
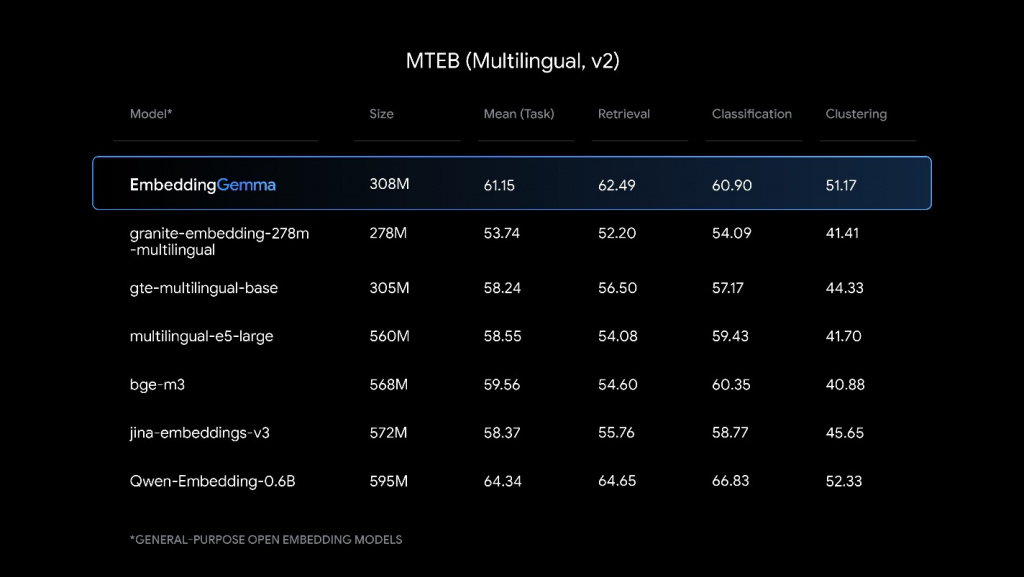
По данным разработчиков, средний показатель MTEB Multilingual mean для полноточной версии (768d, FP) составил 61.15, а для квантизованной версии Q4_0 – 60.62. Разница минимальна, что особенно важно для сценариев, где скорость и энергоэффективность важнее сотых долей процента в метриках. Однако квантизация может слегка снижать точность в высокоточных задачах, требующих детализации.
Стоит помнить: результаты зависят от размера эмбеддингов, задачи и языка. На Retrieval-задачах EmbeddingGemma показывает себя стабильно выше среднего, а в STS и классификации практически не уступает куда более крупным моделям.
Интеграции и запуск
EmbeddingGemma легко вписывается в существующие NLP-стэки: от Sentence-Transformers до LangChain, Haystack, LlamaIndex и даже браузерных приложений на Transformers.js.
Модель поддерживает стандартные API для эмбеддингов, поэтому ее можно использовать так же, как OpenAI Embeddings – только локально и без сети.
Sentence-Transformers
Проще всего начать с Sentence-Transformers: библиотека уже поддерживает EmbeddingGemma и знает ее промпты. Вот код:
from sentence_transformers import SentenceTransformer model = SentenceTransformer("google/embeddinggemma-300m") query = "task: search result | query: как выбрать наливной пол для ванной" doc = "title: none | text: наливные полы подходят для помещений с высокой влажностью..." q_emb = model.encode(query, normalize_embeddings=True) d_emb = model.encode(doc, normalize_embeddings=True)Промпты строго различаются. Для запроса используется task: search result | query: {content}, для документа – title: none | text: {content}.
В браузере через Transformers.js
Модель доступна в формате ONNX, поэтому работает прямо в браузере – без сервера и отправки данных наружу.
import { pipeline } from "@xenova/transformers"; const embedder = await pipeline("feature-extraction", "onnx-community/embeddinggemma-300m-ONNX"); const output = await embedder("task: search result | query: пример запроса");В этом случае модель работает офлайн: вычисления идут на устройстве пользователя.
Серверный inference в TEI (Docker)
Если нужна серверная версия, достаточно поднять контейнер с Text Embedding Inference (TEI). API полностью совместимо с OpenAI:
POST /v1/embeddings { "model": "google/embeddinggemma-300m", "input": "task: search result | query: пример", "prompt_name": "query", "dimensions": 512 }Для удобства есть и короткий эндпоинт /embed, если требуется чистая векторизация без лишних полей.
ONNX Runtime и LiteRT
EmbeddingGemma легко запускается в ONNX Runtime и LiteRT, что делает ее кроссплатформенной: Windows, Linux, macOS, Android, EdgeTPU.
Для продакшн-пилотов подойдут готовые окружения – Ollama и LM Studio, где модель можно загрузить как плагин для локального RAG.
Такой стек дает гибкость: хотите – локальный поиск по документам, хотите – приватный ассистент без облака. Все это – с одной и той же моделью.
Ограничения и гигиена качества
EmbeddingGemma – инструмент точный, но не универсальный. Как и любая специализированная embedding-модель, она оптимизирована под retrieval, semantic search и классификацию, а не под генерацию текста или мультимодальные задачи.
Чтобы получить стабильный результат, важно понимать, где границы применимости и как поддерживать «гигиену» качества на уровне пайплайна.
Вот ситуации, когда EmbeddingGemma может не подойти:
- Слишком длинные входы. Модель рассчитана на ограниченную длину контекста (2048 токенов). Если документ значительно длиннее – его нужно нарезать на пассажи; иначе смысл «размажется», и embedding будет шумным.
- Мультимодальные данные. EmbeddingGemma работает с текстом. Она не принимает изображения, аудио или видео. Для мультимодальных retrieval-сценариев лучше использовать специализированные модели (CLIP, SigLIP, UniEval и т. п.).
- Генерация текста. Это не генеративная модель. У нее нет decoder-части, отвечающей за автокомплит или ответы на вопросы. Для вывода текста после retrieval нужен связанный генератор – например, Gemma 3 или Gemma 3n.
- Очень специфичные домены. Если текст содержит редкую терминологию (например, юрлингвистику, биоинформатику, машинные журналы), качество embedding может падать. В таких случаях полезен легкий fine-tune или адаптивный re-ranking.
Чтобы минимизировать ограничения модели, рекомендуем следовать советам:
- Нормализуйте векторы. Перед сохранением или сравнением embeddings делайте L2-нормализацию. Это обязательный шаг, если вы используете inner product: иначе метрика будет зависеть от длины вектора, а не от смысла.
- Выбирайте корректную метрику. Для retrieval с нормализованными векторами применяйте inner product (он эквивалентен cosine). Если используете ненормализованные embeddings – только cosine similarity.
- Контролируйте промпты. Разные задачи требуют разных префиксов. Для запросов – task: search result | query: {text}; для документов – title: none | text: {content} или добавляйте title для лучшей сходимости. Несоблюдение промпт-шаблонов часто дает скрытые артефакты в распределении векторов.
- Проверяйте retrieval офлайн. Прогоните пайплайн на собственных данных с метриками NDCG@k, Recall@k, MRR. Ручная проверка top-результатов на небольшом срезе (100-200 пар) – лучший быстрый sanity check.
- Следите за размерностью. Для компактных решений подойдут 512d или 256d, но при этом может немного падать точность. Проверяйте компромисс на своей задаче – иногда выигрыш в скорости не оправдывает потери в recall.
- Используйте контрольные выборки. Держите эталонный набор запросов и документов для повторных измерений при обновлении модели, квантизации или fine-tune. Это позволит заметить деградацию раньше.
EmbeddingGemma не обещает магии – она дает предсказуемые, воспроизводимые результаты при условии дисциплины: нормализация, стабильные промпты, контроль данных и регулярная проверка метрик. Эта «гигиена» позволяет выжать из модели максимум даже в офлайн-режиме.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год