


Что не так с NVIDIA Blackwell и GB200? Разбор архитектуры без маркетинга

Введение
Хватило всего нескольких лет ИИ-бума, чтобы рынок ИИ-ускорителей превратился в аукцион, где побеждает тот, кто быстрее всех купит топовый GPU. Параметры моделей растут быстрее, чем дата-центры, а дата-центры растут быстрее, чем производители успевают поставлять GPU. Другими словами, ресурсов не хватало и не хватает до сих пор, но в марте 2024 года появился свет в конце туннеля, который на некоторое время смог удовлетворить аппетиты индустрии — архитектура Nvidia Blackwell и топовые решения на ее базе в лице GPU B200, B300, а также суперчипов GB200 и GB300. Поддержка формата вычислений FP8 и нового FP4, куча тензорных и CUDA ядер, переработанная подсистема памяти, интерконнект NVLink C2C и конечно же, Arm-процессоры Grace — все это с самого начало обрекло Blackwell на грандиозный успех, по крайней мере, во влажных мечтах Хуанга. Как это обычно бывает, красивые графики скрывают много архитектурных нюансов и компромиссов, которые оставляют много узких мест в угоду высокой производительности. В этой статье специалисты компании ServerFlow сотрут маркетинговую слизь с архитектуры Blackwell и расскажут вам, что в чем заключаются реальные плюсы и минусы передовой ИИ-платформы Nvidia, действительно ли окупается столь дорогое вложение и что умолчал Хуанг на своих презентациях.
Коротко о Blackwell и GB200 — что это вообще такое?
Прежде чем говорить о подводных камнях, давайте определимся с базой. Blackwell — это новое поколение GPU-архитектур Nvidia, пришедшее на смену прошлому поколению Hopper и Ada. Важно понимать, что новая платформа, это не просто ускоренная и улучшенная версия H100/H200. В Blackwell инженеры Nvidia разыгрались на славу и перелопатили буквально все: изменилась структура Tensor Core, появился новый путь работы с памятью (Tensor Memory), обновлена логика планировщика, добавлены форматы FP4 и усилены каналы обмена данными. Сменился даже техпроцесс с TSMC 4N на TSMC 4NP, хотя это скорее стандартный апдейт при переходе на новые поколения GPU.
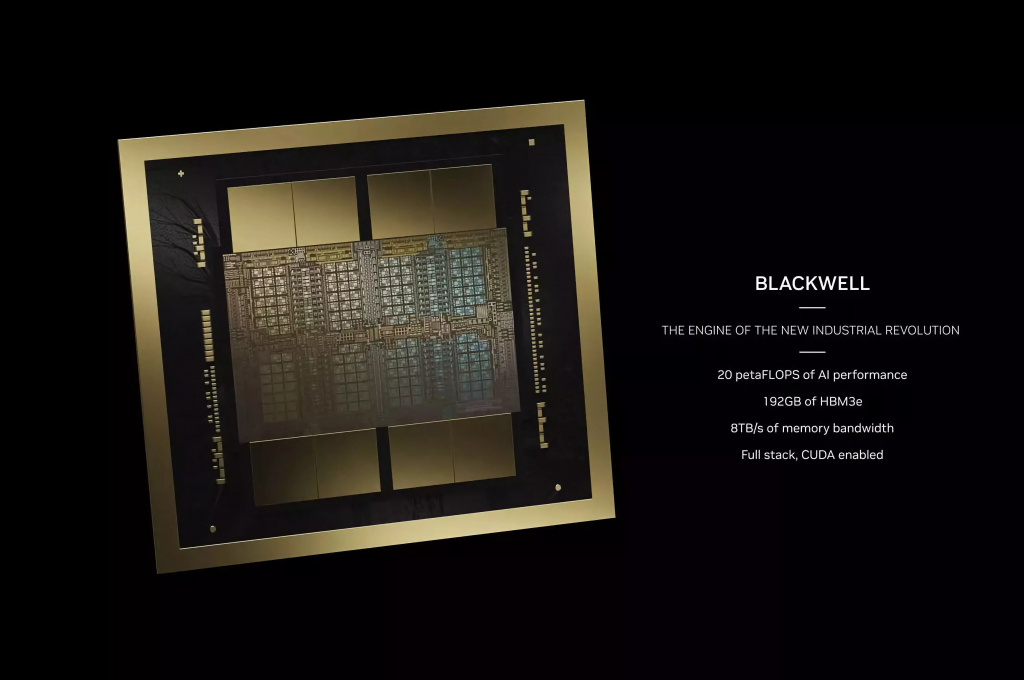
Так какие же передовые решения зеленая команда разработала на столь современной платформе? Сейчас объясним:
- B200 / B300 — это серверные GPU-чипы, на которых и строится вся экосистема графических ускорителей Blackwell. Ключевая их особенность — двухкристальная конструкция. По сути, это два вычислительных чипа, соединенных внутри одного корпуса.
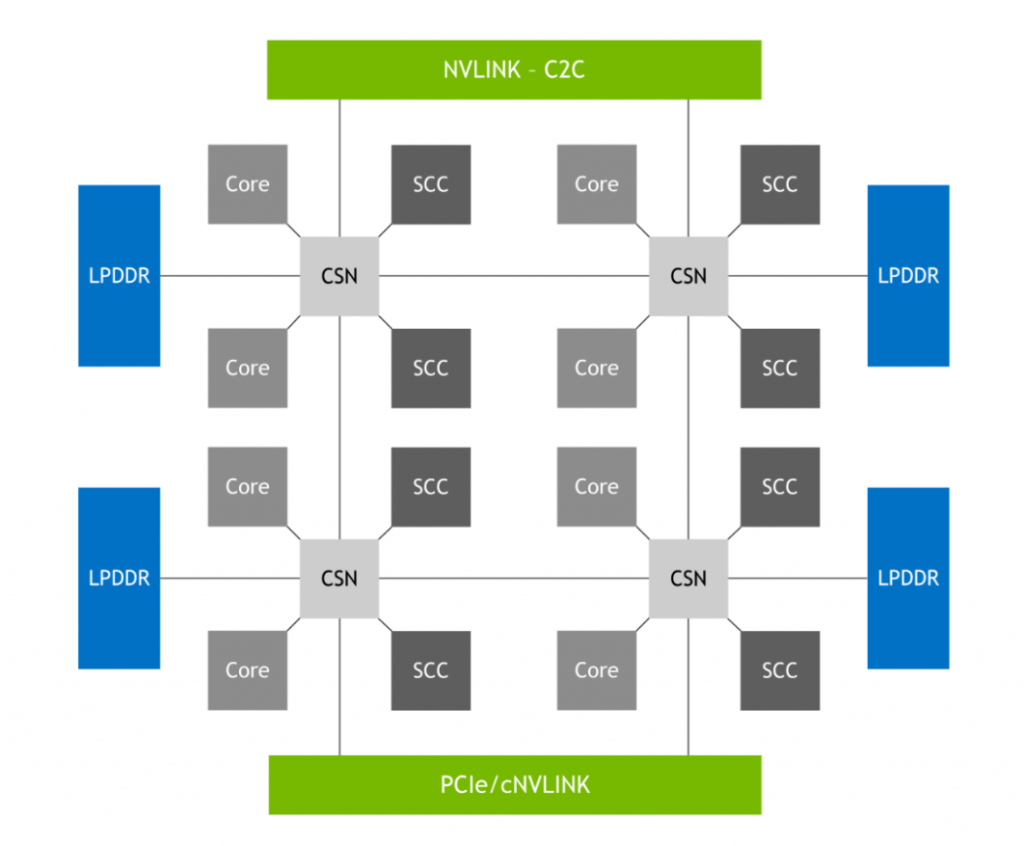
- GB200 / GB300 — это суперчипы, где на одном модуле объединены Arm-процессор Nvidia Grace и GPU Blackwell B200 / B300. Подобная практика встречалась и на архитектуре Hopper (ускорители GH100 и GH200), но в Blackwell она была доведена до идеала, породив множество разных конфигурации: 2GPU + 1CPU, 1GPU + 1CPU и т.д.
- GB202. Изначально разработанный для потребительских видеокарт RTX 5090, он лег в основу профессиональных решений для рабочих станций, в частности, NVIDIA RTX Pro 6000 Blackwell различных изданий (Server Edition, Workstation Edition, Max-Q). GB202 конструкционно отличается от тех же B200/B300, так как он более компактный, поэтому в нем меньше тензорных ядер и графических блоков, а еще у него есть графический API для работы с DirectX и OpenCL.
- GB10 — самый младший представитель семейства Blackwell, но не стоит недооценивать этого компактного крепыша, ведь SoC-чип GB10 лег в основу высокопроизводительных мини-ПК для искусственного интеллекта DGX Spark. В нем еще меньше ядер, чем в GB202, но именно он показывает, что преимущество Blackwell заключается отнюдь не в количестве вычислительных блоков и не в большом кристалле.
Все эти решения объединяет одна парадигма — достичь максимальной производительности для работы с самыми крупными моделями искусственного интеллекта, и добиться этого позволяет уникальная конструкция, где все компоненты тесно связаны друг с другом через сверхбыстрый интерконнект NVLink Chip-to-Chip (C2C), единое адресное пространство памяти и минимальные задержки.
Основные узкие места Blackwell: где архитектура не идеальна
Пока все выглядит более чем хорошо — широкий ассортимент решений под разные сегменты рынка, высокая производительность вне зависимости от габаритов, стек передовых аппаратных технологий. Так что же получается, неужели Blackwell — это самый настоящий идеал среди ИИ-ускорителей? На самом деле, узкие места у этой архитектуры все же есть, только Nvidia о них решила тактично умолчать.
Дисбаланс: Tensor Cores против SFU. Softmax тоже имеет значение
Главная причина ускорения работы Blackwell — интеграция большого количества блоков с тензорными ядрами, которые выполняют матричные операции умножения (GEMM) с феноменальной скоростью, и именно они лежат в основе разработки большинства ИИ-моделей. Если добавить к этому поддержку вычислений в форматах FP8 и FP4, то становится очевидно, что Blackwell буквально становится реактивным топливом для машинного обучения. Но именно эта фокусировка на матричных операциях и сыграла злую шутку над архитектурой.
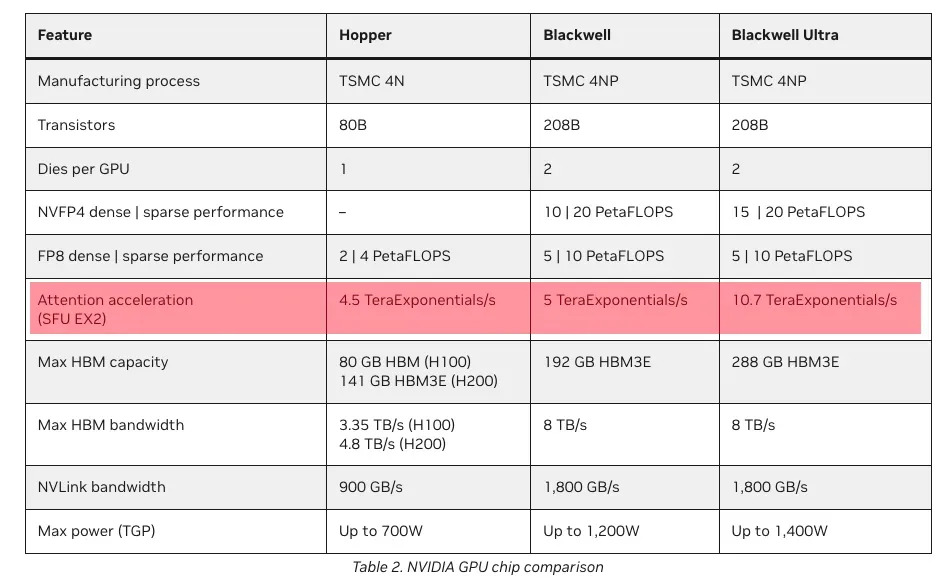
Дело в том, что блоки SFU (Special Function Units), отвечающие за вычисление экспонентов, логарифмов, тригонометрию и функции Softmax, не получили аналогичного усиления, поэтому в подобных операциях Blackwell буквально проваливается до уровня Hooper. Казалось бы, ну нет математики и нет, кому она вообще нужна, когда балом правит ИИ? В том то и дело, что подобный недочет напрямую влияет на производительность механизма Attention в ИИ-трансформерах — чем быстрее выполняются матричные вычисления, тем сильнее заметны просадки скорости в операциях, где нет нужды в пропорциональном масштабировании токенов внимания.
Этот косяк в большей степени выражался в архитектуре B200, тогда как в решениях на базе Blackwell Ultra (B300 и GB300) ситуацию частично исправили, усилив SFU, но даже это не стало панацеей. Ввиду этого, производительность Blackwell резко падает, когда дело касается вычислений в режимах FP64 и FP32. Для ИИ-задач это, конечно, не критично (все вычисляют в FP16, FP8 и FP4), но в секторе HPC, где все вычисления идут в форматах повышенной точности, этот недостаток становится камнем преткновения.
Сложность TMEM и асинхронного программирования. GPU ускорился, а программировать стало тяжелее
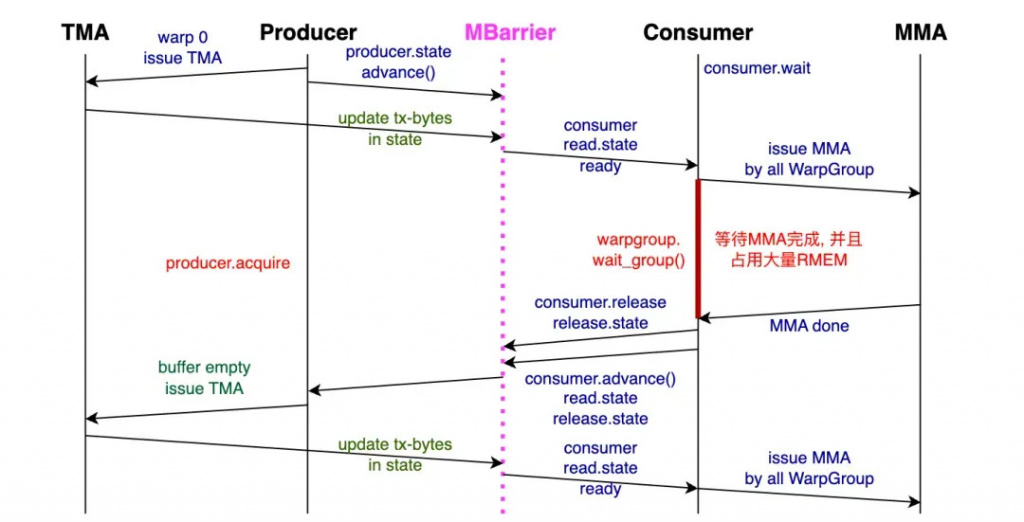
CUDA-программирование за последние несколько поколений GPU стало более асинхронным. Сначала Nvidia добавила cp.async, затем механизмы TMA и MBarrier, а теперь в Blackwell появляется TMEM — Tensor Memory, отдельный путь для перемещения тензоров, который выведен за рамки классического SIMT-подхода. С архитектурной точки зрения это вполне оправдано: регистры CUDA-ядер больше не должны быть узким местом в вычислениях. Но для разработчиков низкоуровневого кода ситуация усложняется. Чтобы выжать максимум из Blackwell, нужно использовать цепочки асинхронных операций, правильно планировать загрузку TMEM, выстраивать многоступенчатые барьеры и думать не о оптимизации, а о том, как расписание операций будет взаимодействовать с Tensor Core. Nvidia предлагает только инструменты вроде CuTe и высокоуровневые пайплайны, которые скрывают детали, но порог входа все время растет, а разработчикам нужно все больше и больше углубляться в архитектурные тонкости. Из-за этого ошибки синхронизации стали частым гостем, при этом найти их стало тяжелее.
Двухкристальная архитектура Blackwell — латентность и доступ к памяти
На демонстрациях своих передовых чипов B200 и B300, Nvidia сознательно умолчала, что эти решения на самом деле двухкристальные. Как же так? Гений маркетинга не сказал такое важное преимущество? А это вовсе и не случайность, так как два кристалла на одной плате неизбежно вызывают асимметрию:
- Доступ к памяти “соседнего” кристалла всегда медленнее, чем к памяти основного;
- Нагрузка, не учитывающая эту топологию, может вызвать дополнительные задержки;
- CUDA пока не предоставляет полноценного управления двухчиповыми конфигурациями, чтобы гарантированно привязать CTA к конкретному кристаллу.
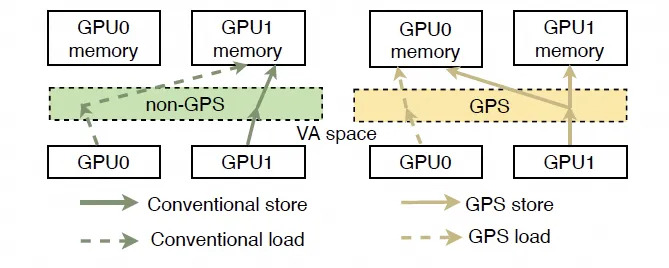
Сложные паттерны доступа к памяти реагируют на топологию особенно болезненно. Если распределение данных и вычислений сделано “в лоб”, часть операций будет регулярно пересекать кристальную границу и тормозить. На однокристальном H100 это было проще. В B200 и B300 — все иначе.
Проблемы Grace Blackwell Superchip GB200: когда CPU становится бутылочным горлышком
На архитектурных особенностях базовых кристаллов B200 проблемы Blackwell отнюдь не заканчиваются. Передовое изобретение Nvidia под названием “суперчипы”, которые в действительности являются отдельными вычислительными системами, еще больше выделили не только преимущества архитектуры Blackwell, но и ее недостатки. Итак, разберем, что же не так с суперчипами GB200.
“Killer microsecond”: когда GPU уже очень быстрый, а CPU не успевает
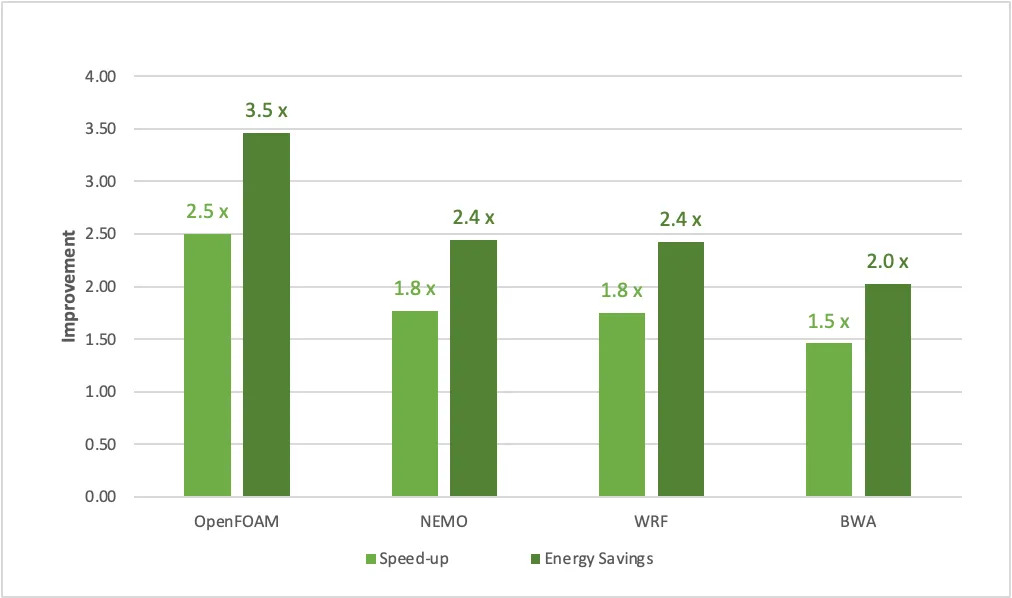
По мере того как GPU-блоки ускоряются, все чаще всплывает проблемы “микросекундного” масштаба: короткие кернелы и операции завершаются так быстро, что латентность управления с CPU начинает доминировать в бюджете времени. Grace в GB200 — это CPU на базе ARM Neoverse V2, но конфигурация ощутимо отличается от стандартных серверных реализаций. Grace имеет урезанные параметры кэша L2, а часть маршрутов доступа к L3 проходит через несколько хопов NOC. В Hopper-эпоху Grace выглядел вполне достойно, но Blackwell стал настолько быстрее, что баланс сместился: GPU вырос, а недостатки CPU перестали быть прозрачными. Это особенно видно в задачах с большим количеством коротких кернелов, которые постоянно требуют участия CPU для синхронизации, подготовки данных или переключения графов.
NOC, RDMA и сетевой трафик, который ходит через Grace
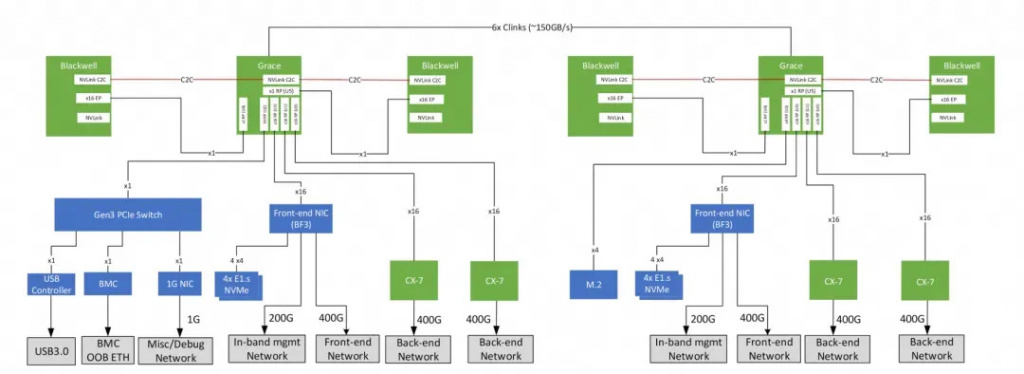
В ряде конфигураций кластеров Scale-Out сетевой трафик RDMA вынужден проходить через процессоры Grace. Это означает, что данные должны пройти через NOC-сетку CPU, его кэши, а затем попасть на NVLink C2C в GPU. Это не только добавляет задержки, но и создает нагрузку на CPU-часть суперчипа. Крупные игроки уже нашли частичные обходы этого недостатка, например, AWS использует внешние PCIe-switch для более грамотного распределения трафика, а Meta* меняет соотношения Grace-Blackwell и использует улучшенную топологию размещения в стойках. Для Nvidia это первый крупный серверный CPU, но для для hyperscaler-игроков Arm-серверы — давно освоенная практика. Другими словами, когда GB200 вставляют в ЦОД, нередко приходится придумывать костыли, чуть ли не вручную направляя сетевой трафик и выстраивая его маршрут, иначе нагрузка уйдет в CPU и будет мешать самой же GPU-части.
Что NVIDIA улучшила в GB300 — и какие вопросы все равно остаются
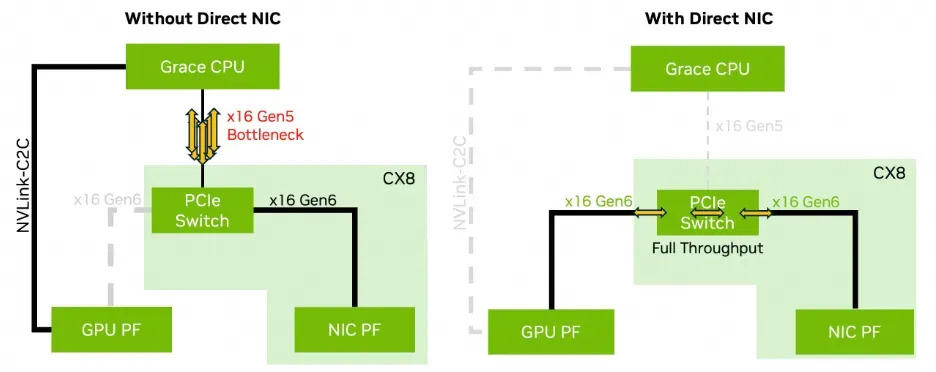
GB300 — это прямая эволюция GB200. В улучшенной архитектуре Nvidia хорошенько поработала над устранением узких мест ванильной Blackwell: расширила SFU-блоки, оптимизировала работу памяти, перераспределила ресурсы в пользу FP8/FP4, добавила PCIe Switch, улучшила некоторые аспекты связи между кристаллами. Это уменьшило просадку производительности в Softmax, ускорило обучение ИИ-трансформеров и устранила латентность при проходе трафика через Grace. Однако, как мы уже упоминали, кардинально ситуацию это не изменило — никуда не делать двухкристальная конфигурация (и ее никуда не деть), а RDMA-маршруты по-прежнему требуют выстраивания грамотной топологии кластера. Конечно, нельзя отрицать, что GB300 определенно лучше GB200, но ожидать, что он магически устранит все ограничения, не стоит.
Что это значит для заказчиков серверов?
Неужели Blackwell так плоха? Действительно ли Nvidia просто бросала пыль в глаза своим клиентам, обливая заведомо плохую архитектуру маркетинговым соусом? Вовсе нет! Nvidia Blackwell была и остается магнум опусом индустрии ИИ-оборудования, хоть у нее и есть свои недостатки. Давайте рассмотрим, где Blackwell будет справляться на пять с плюсом, где она будет проседать и какое решение лучше всего выбирать заказчикам.
Какие нагрузки Blackwell любит?
Blackwell особенно хорошо раскрывается там, где вычислений много, они предсказуемые и в основном состоят из матричных операций. Именно такие задачи дают максимальный выигрыш в производительности:
- Обучение больших трансформеров и LLM;
- Длинные пайплайны с CUDA Graphs, когда кернелы заранее подготовлены;
- Сценарии, где важна пропускная способность и заранее известно распределение данных.
Где можно упереться в архитектурные ограничения?
И наоборот, есть сценарии, где архитектура может преподнести неприятные сюрпризы:
- Нагрузки с большим количеством коротких кернелов, где CPU начинает доминировать;
- Модели, где Softmax или Attention занимают слишком большую часть профиля;
- Кластеры с агрессивным Scale-Out, где RDMA перегружает Grace, потому что путь к GPU всегда проходит через CPU-часть.
В таких ситуациях теоретические TFLOPS легко превращаются в “на бумаге быстро, в проде — не очень”.
На что смотреть при выборе: B200 vs B300, GB200, GB300 vs альтернативы
Если задача состоит в получении максимального GEMM-ускорения и Softmax не доминирует в вычислениях — B200 или GB200 станут оптимальным выбором за счет высокой плотности вычислений, единой памяти и интерконнекту NVLink C2C. Если же модели перегружены механизмом Attention и активно используют SFU-операции, лучше смотреть в сторону B300 — он лучше справляется с этим дисбалансом. В любом случае имеет смысл сравнивать не только текущее поколение решений Nvidia, но и альтернативные конфигурации: Hopper-кластеры, связки x86 + дискретные GPU, другие ARM-серверы, платформы разных вендоров. Самый новый чип не всегда означает, что он самый лучший.
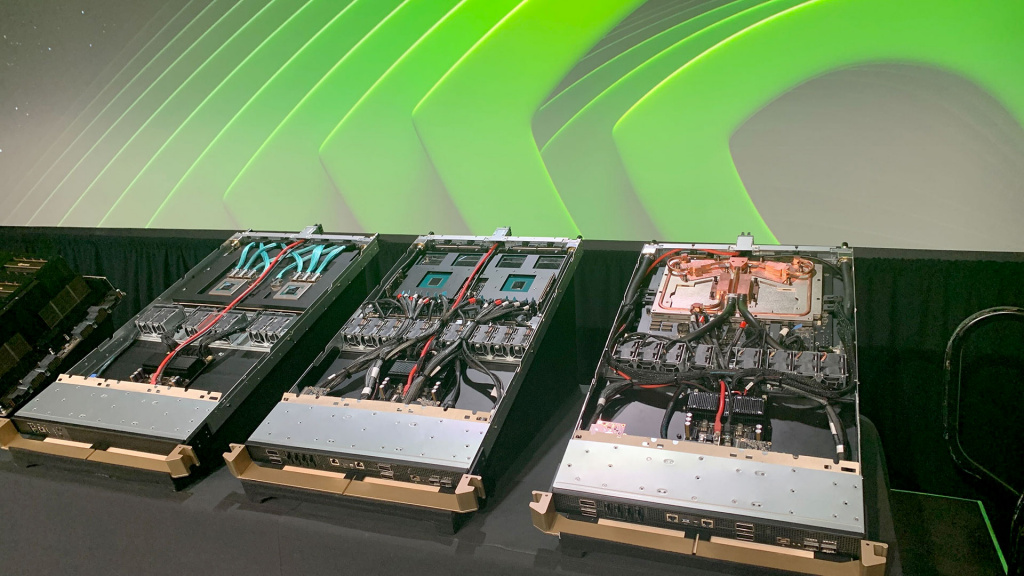
Выводы
Nvidia делает впечатляющие продукты не только потому, что выпускает большие и прожорливые GPU. Сила компании — в ее экосистеме: компиляторы, библиотеки, алгоритмы, GPU-железо, серверы и сетевые решения. Дженсен Хуанг и инженеры зеленой команды проделали колоссальную работу, которую мало кто может повторить. Blackwell стал венцом творения компании Nvidia, но он не является идеальным GPU для ИИ-вычислений и имеет свои компромисс: урезанный SFU, двухкристальность, высокая чувствительность к топологии, особенности CPU Grace, маршруты RDMA. Все это нужно учитывать перед покупкой — особенно при масштабировании кластера. Важно не просто купить самый новый GPU, а понимать, как он устроен и под какие задачи. Тогда архитектурные особенности становятся не проблемой, а инструментом — и можно подобрать конфигурацию, которая реально окупится, а не просто красиво выглядит в пресс-релизе. А с правильным выбором вам поможет компания ServerFlow. Мы подберем идеальное решение для вашей инфраструктуры, будь то платформы HGX, MGX, DGX или другие Arm-серверы, которые обеспечат высочайшую производительность для задач вашего бизнеса.
*Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год