


Тест восьми NVIDIA Tesla P100 в 2026 году на базе GPU сервера

Вступление
Наверняка каждый кто задумывался о сборке своего GPU-сервера, хотя бы единожды прикидывал: что если собрать сервер на базе множества относительно дешевых и возрастных видеокарт? Удастся ли сэкономить? Будет ли производительность приемлемой для современных AI задач? Возникнут ли трудности с программным обеспечением и драйверами?
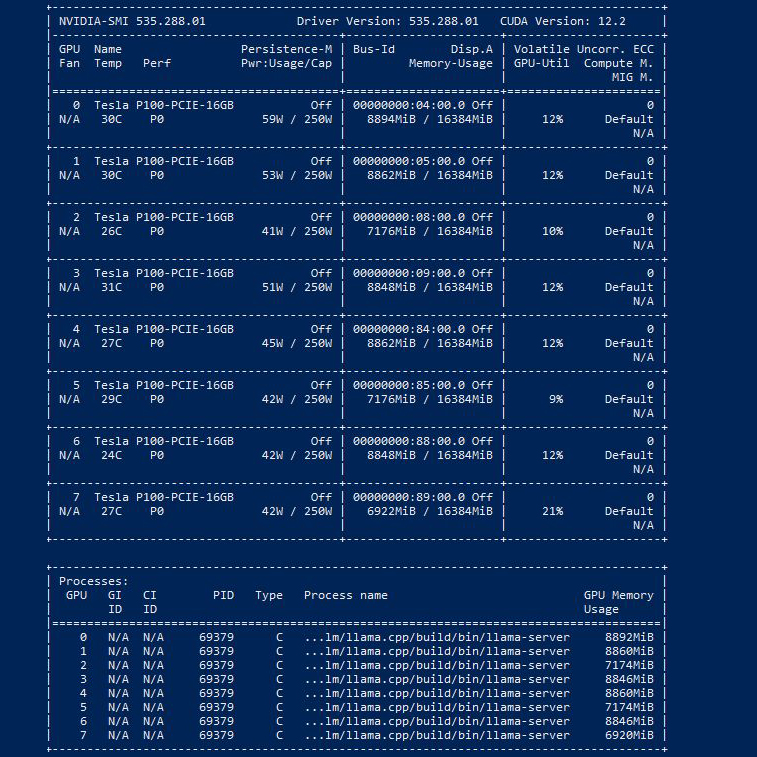
В этом материале мы испытаем целых 8 графических ускорителей Tesla P100 на базе GPU сервера в современных LLM.
Характеристики сервера
- Материнская плата: Supermicro X10DRG-O+-CPU.
- Чипсет: Intel C612.
- Форм-фактор платформы: 4U GPU-сервер.
- Процессоры: 2 × Intel Xeon E5-2687W v4.
- Ядра, потоки: 24 ядра, 48 потоков суммарно.
- Частота CPU: 3.00 GHz базовая, Турбобуст до 3.50 GHz.
- Кэш L3: 30 MB на процессор, 60 MB суммарно.
- ОЗУ: 128 GB DDR4 ECC.
- Видеокарты: 8 × NVIDIA Tesla P100 PCIe 16GB.
- Суммарная VRAM: 128 GB.
- ОС: Ubuntu 24.04.4 LTS.
Отдельно стоит упомянуть про подключение видеокарт. В этом сервере 8 видеокарт подключены не напрямую к процессорам по одной, а через специальные PCIe-коммутаторы. Схема устроена так: в системе два процессора, и каждый обслуживает свои 4 GPU; внутри этой группы из четырёх карт они дополнительно разбиты на две пары, где одна PCIe-ветка от процессора через коммутатор подключает сразу две видеокарты.
Почему так сделали? Потому что у процессоров не хватает прямых отдельных линий, чтобы честно напрямую подключить 8 видеокарт по x16 линий PCIe на каждую. Поэтому в сервере стоят специальные PCIe-коммутаторы, которые “раздают” линии на несколько GPU. Такая топология имеет свои плюсы и минусы.
Огромный плюс заключается в поддержке функции Peer-to-Peer (P2P): если двум картам, сидящим на одном чипе PLX, нужно обменяться данными, они делают это напрямую на полной скорости PCIe 3.0 x16 (~15.7 ГБ/с), без промежуточного копирования через оперативную память и вообще не загружая шину процессора.
Минус – это эффект “узкого горлышка” при обращении к системе. Если обе видеокарты на коммутаторе одновременно попытаются считать данные из системной оперативной памяти или отправить данные на видеокарты другого процессора, они будут вынуждены делить пропускную способность единственного канала x16 к CPU пополам.
Для масштабного обучения нейросетей такая топология стала бы серьезным ограничителем. Но для нашей задачи – LLM-инференса, это почти не играет роли. После того как веса гигантской модели один раз загружены в суммарные 128 ГБ видеопамяти, между картами и процессором гоняются лишь крошечные объемы данных (токены), для которых пропускной способности мультиплексированной шины PCIe 3.0 хватает с огромным запасом.
Подробнее об этом мы поговорили в другой нашей статье. А теперь давайте перейдём к тестам.
Тест восьми NVIDIA Tesla P100 в популярных LLM
Производительность и работоспособность этой вереницы ускорителей мы рассмотрим при участии нескольких популярных ИИ-движков. Все модели будут тестироваться в равных условиях, с одинаковой длинной контекста.
llama.cpp
Начнём с llama.cpp. Это пожалуй самый легкий старт для работы с несколькими видеокартами. Ведь он умеет гибко выносить часть слоёв на каждый GPU самостоятельно.
Однако и слабое место llama.cpp там же – масштабирование на множество GPU: его архитектура не рассчитана на максимально эффективную работу на большом числе GPU, и в этом он уступает движкам вроде vLLM. Поэтому не смотря на его умение параллелить нагрузку, делает он это не слишком эффективно.
Тест нейросетевых моделей на сервере
Сводная таблица по моделям, форматам квантизации, скорости генерации, времени до первого токена, длине контекста и кратким примечаниям по качеству ответов.
| Модель | Форматы квантизации | Скорость (токенов в сек.) | До первого токена | Длинна контекста (в токенах) | Примечания |
|---|---|---|---|---|---|
| Lfm2 24B A2B | Q4_K_M | 69.92 | 0.2 сек. | 8192 | Хорошая скорость, но очень скудные и невнятные ответы. |
| Gemma 4 26B A4B | Q4_K_M | 37.82 | 0.9 сек. | 8192 | Новая модель от Google, даёт внятные ответы средней длины. Не особо выделяется среди прочих. |
| gpt-oss-20b | MXFP4 | 58.77 | 0.6 сек. | 8192 | Лучшая нейросетевая модель по соотношению вес / качество, самые подробные и быстрые ответы в своей весовой категории. |
| Qwen3.5 35B A3B | Q4_K_M | 44.55 | 0.6 сек. | 8192 | Свежая модель Qwen, вышедшая 24.02.2026. Даёт лучшие и самые подробные ответы. Прекрасно развита логика и отлично строит причино-следственные связи |
| DeepSeek-R1 Distilled 32B | Q4_K_M | 9.97 | 1.2 сек. | 8192 | Наихудший результат по скорости. Ответы не выделяются качеством. |
| Llama 3.3 70B-Instruct | Q4_K_M | 4.82 | 2.1 сек. | 8192 | Крупная модель, которая даёт очень подробные и внятные ответы в ущерб скорости. |
| gpt-oss-120b | MXFP4 | 39.14 | 0.3 сек. | 8192 | Лучшие ответы, самая разумная модель из представленных. Сторит осмысленные предложения на любом языке, очень ловко жонглирует словами и понятиями. |
Результаты генерации не шибко впечатляют для такого количества видеокарт. Видно что производительность растёт нелинейно. В видеоролике на нашем канале, на примере этого же сервера мы разобрались от какого количества видеокарт будет прок. И как будет меняться производительность при увеличении количества задействованных GPU в сервере.
Прочие движки: vLLM, SGLang и ExLlamaV2
Заключение
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год