


Советы по покупке сервера для ИИ: оптимальное решение для обучения нейронных сетей

Содержание:
- Введение
- Все начинается с GPU
- Пару слов о процессорах
- GPU Платформы LGA2011-3
- Supermicro SuperServer 1028GR-TR: Идеальное решение для инференса ИИ
- Supermicro SuperServer 4028GR-TR: Высокопроизводительное решение для обучения и инференса ИИ
- GPU Платформы LGA3647
- Supermicro SuperServer 2029GP-TR: Высокопроизводительное 2U шасси для ИИ
- Supermicro SuperServer 4029GP-TRT2: Эволюция 4U платформы для ИИ
- GPU Платформы SP3(AMD EPYC)
- Сборка под LLAMA 11B*
- Сборка под LLAMA 3.2 90B*
- Сборка для LLAMA 3.1 405B*
- Вывод
Введение
Все начинается с GPU
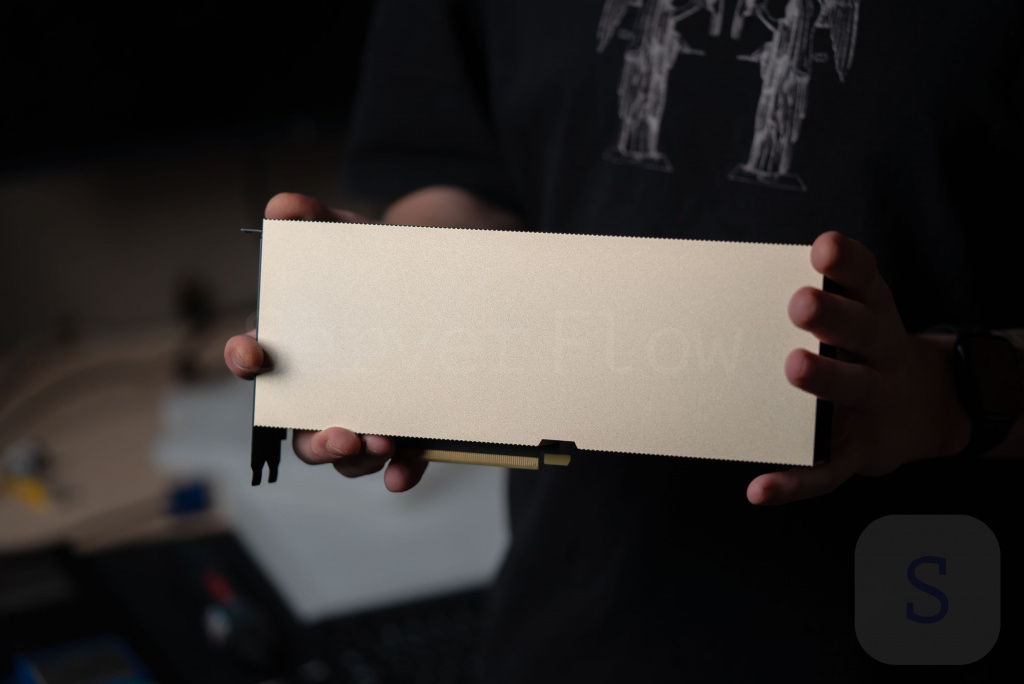
| Наименование ускорителя | Объем VRAM и ее тип | Производительность FP32 | Производительность FP16/BFLOAT16 |
| NVIDIA Tesla P100 | 16GB HBM2 | 10.6 TFLOPS | 21.6 TFLOPS |
| NVIDIA Tesla P40 | 24GB GDDR5 | 11.76 TFLOPS | 183 GFLOPS |
| AMD Radeon Instinct MI50 | 16GB HBM2 | 13 TFLOPS | 28.8 TFLOPS |
| NVIDIA Tesla V100 | 16GB HBM2 | 14 TFLOPS | 112 TFLOPS |
| NVIDIA Tesla V100 | 32GB HBM2 | 14 TFLOPS | 112 TFLOPS |
| NVIDIA A100 | 40GB HBM2e | 312 TFLOPS | 624 TFLOPS |
| NVIDIA L40 | 48GB GDDR6 | 181 TFLOPS | 362 TFLOPS |
| NVIDIA H100 | 80GB HBM2e | 989 TFLOPS | 1979 TFLOPS |
Теперь предлагаю вам разобраться в этом обилии технической информации:
- Объем видеопамяти – Чем больше объем видеопамяти, тем лучше. Большой объем видеопамяти позволяет запускать неквантизированные варианты моделей LLM и в целом проводить инференс и обучение без каких-либо ограничений. Помимо объема, обратите внимание на тип видеопамяти. HBM предпочтительна, если ваши задачи включают обучение, так как это требует значительной пропускной способности для достижения эффективной работы.
- Производительность FP32 – Вычисления с полной точностью необходимы для работы неквантизированных моделей ИИ, требующих огромного объема памяти, особенно если модели имеют миллиарды параметров.
- Производительность FP16 – Вычисления с половинной точностью являются наиболее распространенным вариантом работы с весами моделей ИИ, так как он сочетает в себе улучшенное быстродействие, экономию VRAM и практически незаметную потерю точности в ответах ИИ.
— выбор ускорителей следует делать, исходя из
бюджета, объема памятии производительности в режиме вычислений с
половинной точностью(FP16).
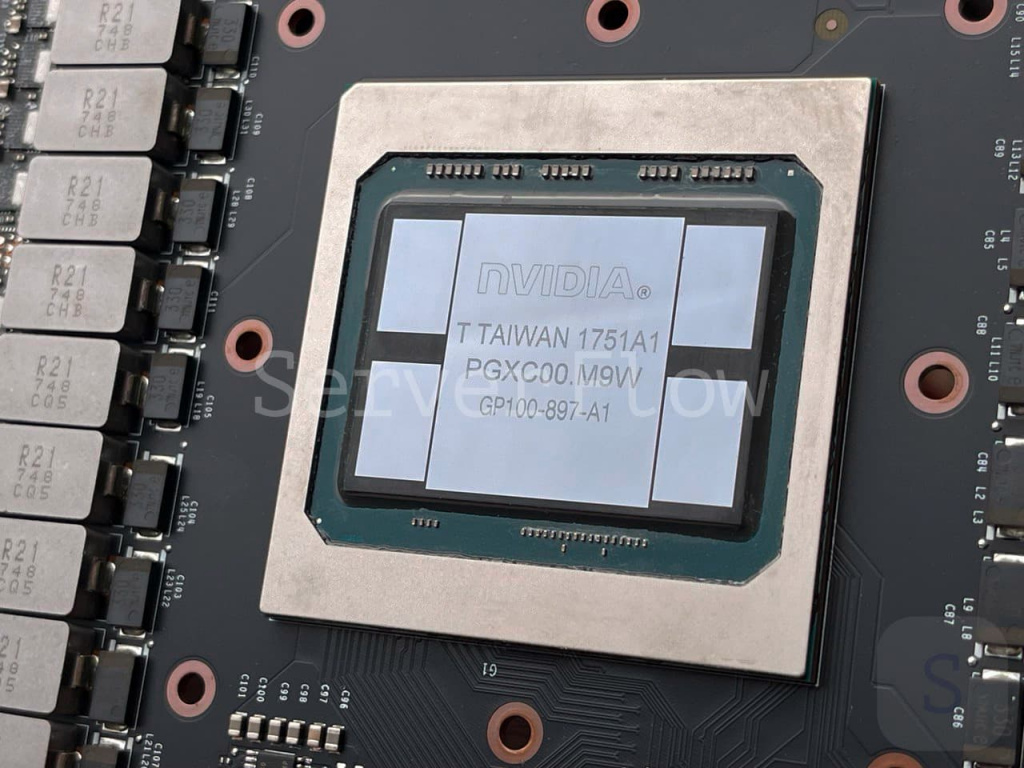
Пару слов о процессорах
Прежде чем мы перейдем к предметному разговору о платформах, хочу ещё раз отметить, что в рамках работы с ИИ процессор обычно выполняет хост-функцию. То есть он служит связующим звеном между GPU, RAM и SSD. Если полностью абстрагироваться от идеи инференса и обучения на процессоре, то основные требования к процессору можно выразить следующим образом:
- Число ядер: не менее 16 шт.
- Тактовая частота: как можно выше
- Кол-во линий PCI-E: чем больше, тем лучше
- Объем кэш памяти: чем больше, тем лучше
Также для вашего удобства мы подготовили таблицу в которой разбили самые востребованные линейки процессоров по поколениям. Это поможет вам лучше понять какие преимущества вам дает каждый из представителей CPU при выборе серверной платформы.
Процессоры Intel
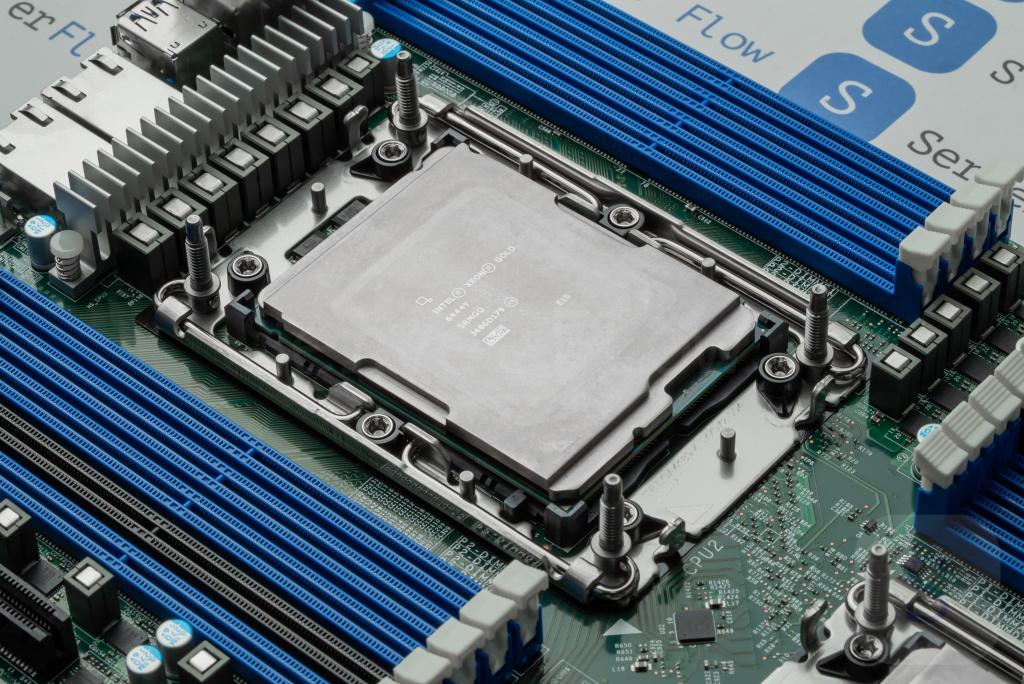
Модельный ряд процессоров Intel отличается следующими характеристиками:
| Линейка процессоров | Число линий PCI-E | Поддержка линий PCI-e |
| Xeon E5 2600v4 | 40 | 3.0 |
| Intel Xeon Scalable 1 Gen | 48 | 3.0 |
| Intel Xeon Scalable 2 Gen | 48 | 3.0 |
| Intel Xeon Scalable 3 Gen | 64 | 4.0 |
| Intel Xeon Scalable 4 Gen | 80 | 5.0 |
| Intel Xeon Scalable 5 Gen | 80 | 5.0 |
| Xeon 6900 Performance | 96 | 5.0 |
Процессоры AMD

Процессоры от красной компании в свою очередь имеют некоторое преимущество над Intel:
| Линейка процессоров | Число линий PCI-E | Поддержка линий PCI-e |
| EPYC 7002(Zen2) | 128 | 4.0 |
| EPYC 7003(Zen3) | 128 | 4.0 |
| EPYC 9004(Zen4) | 128 | 5.0 |
| EPYC 9005(Zen5) | 128 | 5.0 |
Если резюмировать – то под эти задачи идеально подходят CPU от AMD – линейки AMD EPYC, благодря максимальному числу линий PCI-E и поддержке современного стандарта PCI-E. А из процессоров Intel можно выделить топовые модели Xeon Gold и Platinum 1-2 поколения, а лучше 3-5 поколения. Однако и более старые процеессоры серий Xeon E5 могут выполнять эти функции, однако они несколько ограничивают возможности масштабирования системы и мы не рекомендуем использовать их с GPU соответствующего ценового диапазона.
GPU Платформы LGA2011-3
В ассортименте Server Flow представлено несколько GPU платформ на базе легендарных процессоров Xeon E5. Эти платформы основаны на PCI-E 3.0 и идеально подходят для конфигураций с ограниченным бюджетом
Supermicro SuperServer 1028GR-TR: Идеальное решение для инференса ИИ

SuperServer 1028GR-TR — это компактное 1U шасси, которое позволяет разместить до трех полноразмерных GPU. Это устройство предоставляет уникальные преимущества для построения высокопроизводительных систем для инференса и обучения искусственного интеллекта (ИИ).
Supermicro SuperServer 4028GR-TR: Высокопроизводительное решение для обучения и инференса ИИ

SuperServer 4028GR-TR — это сервер форм-фактора 4U, который предоставляет возможность установки до 8 GPU ускорителей в связке с процессорами Xeon E5. Это шасси выделяется демократичной стоимостью и дает возможность создать систему с большим объемом видеопамяти (VRAM), что крайне важно для работы с большими языковыми моделями (LLM).
GPU Платформы LGA3647
Переход к обновленным архитектурам Skylake-SP и Cascade Lake стал значительным шагом вперед в эволюции GPU серверов. Эти архитектуры, использующие процессоры с сокетом LGA3647, привнесли ряд ключевых улучшений, особенно заметных в серверах на базе процессоров Xeon Gold и Platinum 1-2 поколений.
Supermicro SuperServer 2029GP-TR: Высокопроизводительное 2U шасси для ИИ
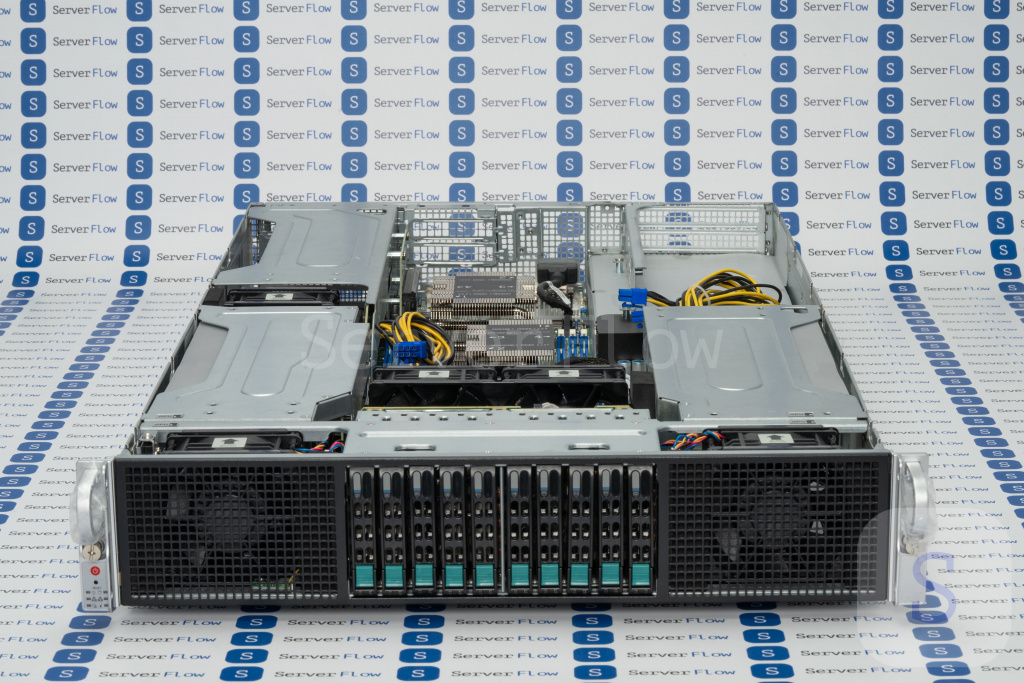
SuperServer 2029GP-TR — это продвинутое 2U шасси, которое позволяет установить до 6 видеокарт без потери их пропускной способности. Этот сервер предлагает отличные возможности для создания мощных и эффективных систем для инференса и обучения искусственного интеллекта (ИИ).
Supermicro SuperServer 4029GP-TRT2: Эволюция 4U платформы для ИИ

SuperServer 4029GP-TRT2 — это эволюция 4U платформы на сокете LGA 3647. В отличие от предшественника, эта модель оснащена новым поколением PCI-E Switch, что повышает эффективность взаимодействия видеокарт и CPU. Также обновленный бекплейн поддерживает до четырех гибридных U2 слотов для интеграции NVMe накопителей, что обеспечивает высокоскоростное хранение данных.
GPU Платформы SP3(AMD EPYC)
Supermicro A+ Server 4124GS-TNR: Эталонное решение для самых требовательных LLM

A+ Server 4124GS-TNR 4U 24SFF – это эталонное GPU шасси, позволяющее подключать GPU напрямую без использования PCI-E Switch. Это практически устраняет задержки между GPU и значительно ускоряет процессы инференса и обучения. Процессоры AMD EPYC 7003 Millan великолепно справляются с хост-функционалом, обеспечивая высокую производительность и надежность. Это делает их идеальным выбором для задач искусственного интеллекта и высокопроизводительных вычислений.
Сборка под LLAMA 11B*
Для того чтобы понять какие решения могут обеспечить достойную производительность в развертывании LLAMA 11B* нам нужно точно понимать какие требования предъявляет эта модель ИИ к инференсу и обучению. Эти сведения дадут устойчивое понимание сможем ли мы использовать эту модель в режиме полной точности.
- FP32: Около 180 ГБ VRAM для инференса и до 1.5 ТБ VRAM для обучения.
- FP16: Около 90 ГБ VRAM для инференса и до 750 ГБ VRAM для обучения.
- FP8: Около 22.5 ГБ VRAM для инференса и до 187.5 ГБ VRAM для обучения.
| Модель | Решение | Суммарный объем видеопамяти |
| LLAMA 11B* (FP32) | SuperServer 4028GR-TR 4U
CPU: 2x Xeon 2687Wv4 RAM: 512GB DDR4 ECC REG GPU: 8x Tesla P40 24GB | 192GB |
| LLAMA 11B* (FP16) | SuperServer 2029GP-TR 2U
CPU: 2x Xeon Gold 6154 RAM: 256GB DDR4 ECC REG GPU: 3x Tesla V100 32GB | 96GB |
| LLAMA 11B* (FP8) | SuperServer 1028GR-TR 1U
CPU: 2x Xeon 2687Wv4 RAM: 128GB DDR4 ECC REG GPU: 3x Tesla P100 16GB | 48GB |
Сборка под LLAMA 3.2 90B*
Расширенная версия LLAMA 3.2 90B* действительно имеет существенно более высокие системные требования. Чтобы обеспечить эффективную работу с этой моделью, мы будем использовать ускорители более высокого класса класса и повысим требования к серверной платформе. Это позволит гарантировать высокую производительность как при инференсе, так и при обучении модели
- FP32: Около 720 ГБ VRAM для инференса и до 2.5 ТБ VRAM для обучения..
- FP16: Около 360 ГБ VRAM для инференса и до 1.25 ТБ VRAM для обучения.
- FP8: Около 90 ГБ VRAM для инференса и до 375 ГБ VRAM для обучения.
| Модель | Решение | Суммарный объем видеопамяти |
| LLAMA 90B* (FP32) | A+ Server 4124GS-TNR 4U
CPU: 2x EPYC 75F3 RAM: 2TB DDR4 ECC REG GPU: 8x Tesla H100 96GB | 768GB |
| LLAMA 90B* (FP16) | SuperServer 4029GP-TRT2 4U
CPU: 2x Xeon Gold 6254 RAM: 1024GB DDR4 ECC REG GPU: 6x Tesla H100 80GB | 480GB |
| LLAMA 11B* (FP8) | SuperServer 2029GP-TR 2U
CPU: 2x Xeon 6246 RAM: 512GB DDR4 ECC REG GPU: 6x Tesla V100 16GB | 96GB |
Сборка для LLAMA 3.1 405B*
LLAMA 3.1 405B* является самой требовательной моделью искусственного интеллекта, ориентированной исключительно на работу с текстовыми запросами. В отличие от предыдущих моделей серии 3.2, эта модель обучалась только на текстовых данных. Благодаря этому она достигает высокой точности в ответах на всевозможные вопросы и легко поддается дальнейшему обучению.
- FP32:Около 972 ГБ VRAM для инференса и до 1944 ГБ VRAM для обучения.
- FP16: Около 486 ГБ VRAM для инференса и до 972 ГБ VRAM для обучения.
- FP8: Около 243 ГБ VRAM для инференса и до 486 ГБ VRAM для обучения.
| Модель | Решение | Суммарный объем видеопамяти |
| LLAMA 405B* (FP32) | A+ Server AS-8125GS-TNHR 8U
CPU: 2x EPYC 9374F RAM: 4TB RAM GPU: H200 SXM 141GB | 1128GB |
| LLAMA 405B* (FP16) | A+ Server 4124GS-TNR 4U
CPU: 2x EPYC 75F3 RAM: 2TB DDR4 ECC REG GPU: 8x Instinct MI210 64GB | 512GB |
| LLAMA 405B* (FP8) | SuperServer 4029GP-TRT2 8U
CPU: 2x Xeon Gold 6254 RAM: 1024GB DDR4 ECC REG GPU: 6x Tesla L40 48GB | 288GB |
Выводы
Искусственный интеллект и большие языковые модели (LLM) стали неотъемлемой частью жизни людей и компаний. Сегодня многие организации ищут способы локального запуска моделей, чтобы оптимизировать их под свои бизнес-потребности. Мы в Server Flow готовы всячески поддерживать компании в этом направлении.
Если вас заинтересовала тема сборки собственного сервера для искусственного интеллекта и развертывания таких популярных моделей, как LLAMA*, StableDiffusion, Mistral или GPT-4, вы можете обратиться к нашим специалистам. Мы подберем индивидуальное решение с учетом всех особенностей вашего ИИ и потребностей вашего бизнеса.
*LLAMA 3.2 — проект Meta Plarforms Inc.**, деятельность которой в России признана экстремистской и запрещена.
**Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год