


Китайские ИИ без квантизации: DeepSeek 671B и Qwen 72B — системные требования и серверы

Содержание:
- Введение
- Зачем нужны настолько мощные модели ИИ?
- DeepSeek R1 671B
- DeepSeek Coder v2
- Qwen 2.5 72B
- Почему отсутствие квантизации это хорошо?
- Как собрать систему для развертывания таких моделей?
- Вывод
Введение
В предыдущей статье мы рассказывали о развертывании популярных китайских ИИ локально на устройствах пользовательского сегмента. Но на самом деле, пользовательские ПК и серверы справляются с развертыванием лишь квантизированных версий нейросетей DeepSeek, Qwen и других LLM из КНР. Однако, в открытом доступе доступны эти же модели ИИ без квантизации и кратно большим числом параметров, для локальной установки которых нужно высокопроизводительное серверное оборудование. В этой статье мы поговорим о том, зачем нужны полные версии китайских LLM, какие популярные модели доступны для локальной установки, а также объясним, как собрать мощную систему для их развертывания и использования.
Зачем нужны настолько мощные модели ИИ?
У читателей может возникнуть логичный вопрос — зачем нужно развертывать большие, квантизированные модели, при этом выстраивать для них дорогостоящую инфраструктуру, если есть легкие модели, которые можно развернуть на более дешевых устройствах. На самом деле, у полноценных версий LLM масса преимуществ:
- Максимальная точность. Локальное развертывание неквантизированных LLM позволяет достичь максимальной точности. При отсутствии квантизации модель сохраняет все свои параметры в полном объеме, что минимизирует вероятность ошибок и неточностей в ответах. Хотя квантизация и делает модели более легковесными, она неизбежно приводит к небольшой потере эффективности генерации ответов, поэтому для критически важных задач предпочтительнее использовать полные версии ИИ.
- Конфиденциальность данных. Большие компании, работающие с конфиденциальной информацией своих клиентов, не могут позволить автоматизировать обработку подобных данных через облачные версии ИИ, так как это может привести к утечке и последующих судебных разбирательствах. Чтобы избежать таких проблем, большие языковые модели развертываются локально и все критически важные данные курсируют внутри сетевой инфраструктуры организации, не попадая в сеть.
- Возможность обучения. Квантизация сводит к минимуму обучаемость LLM, в результате чего такие модели нельзя адаптировать под выполнение определенных операций. Поэтому для создания качественной, обученной под конкретные задачи нейросети и ее настройки, необходимо использовать мощные сервера с полноразмерной моделью.
- Выполнение специфических задач. Некоторые неквантизированные ИИ заточены под выполнение определенных операций, вроде написания кода или генерации изображений. Например, модель DeepSeek Coder v2 c 236 миллиардами параметров необходима исключительно для операций с программным кодом. Такие специальные модели тоже можно развертывать локально и применять для автоматизации выполнения рутинных операций, вроде проверки документов, поиска ошибок в коде и подобных задач.
- Интеграция с приложениями. Локально развернутая модель ИИ может быть непосредственно подключена к внутренним приложениям компании, обеспечивая бесшовное взаимодействие между всеми рабочими процессами. Это позволяет создавать провести глубокую автоматизацию бизнеса, где ИИ будет являться полноценной частью корпоративной инфраструктуры и увеличит эффективность выполнения различных задач.
DeepSeek R1 671B
DeepSeek R1 — самая популярная нейросеть в мире, которой удалось обойти топовые модели ChatGPT и *Llama меньше чем через месяц после своего выхода. DeepSeek R1 имеет несколько квантизированных версий, а также полную версию, имеющую 671 миллиардов параметров. Эта модель была обучена на огромном объеме текстовых данных с использованием метода дистилляции с помощью нейросетей Qwen и *Llama, благодаря чему при ее создании компания-разработчик потратила значительно меньший бюджет в сравнении со стоимостью моделей конкурентов. DeepSeek R1 используется в различных областях, таких как автоматизация бизнес-процессов, создание контента, научные исследования, разработка программного обеспечения и многое другое. Широкие возможности масштабирования при обучении, а также универсальность для выполнения различных операций, делают ее одной из самых востребованных нейросетей для локального развертывания.
Требования DeepSeek R1 671B
Чтобы вам было проще понять, в каком режиме вычислений целесообразно запускать эту модель, прикладываем список с данными о потреблении видеопамяти на разных уровнях квантизации.
Требования для инференса:
- Инференс c “полной” точностью (FP32) — 2700 ГБ VRAM;
- Инференс с половинной точностью (FP16) — 1350 ГБ VRAM;
- Инференс с низкой или целочисленной точностью (FP8 / INT8) — 680 ГБ VRAM.
Требования для обучения:
- Обучение c “полной” точностью (FP32) — 5400 ГБ VRAM;
- Обучение с половинной точностью (FP16) — 2700 ГБ VRAM;
- Обучение с низкой или целочисленной точностью (FP8 / INT8) — 1360 ГБ VRAM.
DeepSeek Coder v2 236B
DeepSeek Coder v2 — это специализированная версия серии моделей DeepSeek, адаптированная для генерации, анализа и исправления программного кода. Эта модель также содержит 236 миллиардов параметров, что делает ее одной из самых производительных LLM для кодинга на рынке, а ее производительность сравнима с ChatGPT 4o. Она была обучена на огромном количестве х кодов на различных языках программирования, включая Python, Java, C++, JavaScript, Go и множестве других, благодаря чему она отлично справляется с такими операциями, как ускорение разработки ПО, оптимизация готового кода, создание кода с нуля и обучение разработчиков ПО. Помимо этого, данную модель можно обучать дополнительно, используя базу данных DeepSeek Coder V2-Base.
Требования DeepSeek Coder v2 236B
Прикладываем информацию о потреблении видеопамяти модели DeepSeek Coder v2 в разных режимах квантизации при инференсе и обучении:
Требования для инференса:
- Инференс c “полной” точностью (FP32) — 1830 ГБ VRAM;
- Инференс с половинной точностью (FP16) — 740 ГБ VRAM;
- Инференс с низкой или целочисленной точностью (FP8 / INT8) — 350 ГБ VRAM.
Требования для обучения:
- Обучение c “полной” точностью (FP32) — 2240 ГБ VRAM;
- Обучение с половинной точностью (FP16) — 1120 ГБ VRAM;
- Обучение с низкой или целочисленной точностью (FP8 / INT8) — 660 ГБ VRAM.
Qwen 2.5 72B
Qwen 2.5 — одна из моделей серии LLM Qwen от компании Alibaba Cloud, содержащая в себе 72 миллиарда параметров. Qwen 2.5 была обучена на 18 триллионах токенах с использованием огромной базы данных компании Alibaba, что максимально приближает ее производительность к передовому искусственному интеллекту Qwen 2.5 Max. Qwen 2.5 является мультимодальной, поэтому ее можно применять для выполнения широкого спектра задач, например, работы с текстом, кодом, математическими вычислениями, изображениями, аудио и видео файлами. Qwen 2.5 также поддерживает длинные контексты до 128 тысяч токенов и может генерировать до 8 тысяч токенов за 1 запрос.
Требования Qwen 2.5 72B
Ниже приведены требования к потребляемой видеопамяти модели Qwen 2.5 при обучении и инференсе на разных уровнях квантизации:
Требования для инференса:
- Инференс c “полной” точностью (FP32) — 150 ГБ VRAM;
- Инференс с половинной точностью (FP16) — 75 ГБ VRAM;
- Инференс с низкой или целочисленной точностью (FP8 / INT8) — 40 ГБ VRAM.
Требования для обучения:
- Обучение c “полной” точностью (FP32) — 300 ГБ VRAM;
- Обучение с половинной точностью (FP16) — 150 ГБ VRAM;
- Обучение с низкой или целочисленной точностью (FP8 / INT8) — 80 ГБ VRAM.
Почему отсутствие квантизации это хорошо?
Выше мы упоминали потребление VRAM больших языковых моделей DeepSeek R1 и Qwen 2.5 в разных режимах квантизации. Однако стоит объяснить в чем преимущество отсутствия квантизации в моделях ИИ:
- Максимальная точность ответов. Наквантизированные модели ИИ имеют максимальную точность при генерации ответов, поскольку в ходе обработки запроса пользователя LLM использует полное количество доступных для запроса токенов. Если вы все же планируете использовать квантизированную LLM, для ее обучения и инференса лучше всего выбирать режимы вычисления FP16 и FP8, так как эти режимы позволяют снизить объем LLM при минимальной потери точности ответов.
- Возможность дообучения. Неквантизированные модели не теряют способности к эффективному дообучению, в то время как квантизированные версии из-за уменьшения точности вычисления весов могут стать практически полностью не обучаемыми.
- Улучшение связи между ответами. Благодаря отсутствию квантизации, модель лучше запоминает паттерны данных в текущем контекстном окне, благодаря чему ИИ сможет сохранять связь между ответами и генерировать более релевантные результаты.
- Лучшая точность весов внимания. Современные модели LLM имеют особый механизм внимания, который позволяет ИИ фокусироваться на конкретных деталях запроса и акцентировать на них внимание при генерации ответов. Неквантизированные модели лучше справляются с вычислением весов внимания и дают более релевантные ответы, в то время как квантизированные значительно теряют в точности весов внимания и могут фокусироваться на сторонних деталях при ответе на запрос.
- Отсутствие ограничений по длине запроса. Неквантизированные ИИ поддерживают обработку длинных пользовательских токенов без потери точности, благодаря чему юзер может создавать более проработанные промпты, а LLM будет генерировать наиболее релевантные результаты.
Если вы хотите узнать больше о тонкостях квантизации больших языковых моделей, рекомендуем ознакомиться с тематической статьей в блоге ServerFlow.
Как собрать систему для развертывания таких моделей?
Итак, мы рассказали о нескольких популярных китайских LLM, находящихся в открытом доступе и доступных для локального развертывания без квантизации. Однако мы выяснили, что неквантизированные ИИ с большим числом параметров потребляют терабайты видеопамяти, в то время как даже самые мощные графические ускорители имеют всего несколько сотен гигабайт VRAM. В таком случае, как можно добиться такого монструозного объема VRAM? Есть 2 способа: собрать GPU-сервер из нескольких видеокарт, либо оснастить традиционный сервер большим количеством оперативной памяти.
GPU-сервер для Deepseek R1 и Qwen 2.5
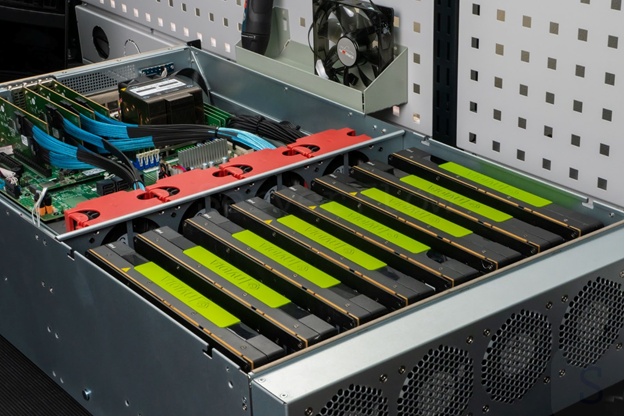
Самый популярный и эффективный, но также наиболее дорогостоящий способ создать вычислительное устройство для развертывания перечисленных ИИ-моделей — собрать GPU-сервер. В таком устройстве будет установлено от 8 и более мощных графических ускорителей, которые смогут обеспечить достаточно видеопамяти для ИИ (около 2 ТБ VRAM), благодаря чему они смогут разместить в своей памяти датасет модели LLM. Рассмотрим несколько вариантов сборок GPU-сервера для развертывания перечисленных выше китайских языковых моделей:
Оборудование для Deepseek R1 671B:
- 8 графических ускорителей Nvidia B200 с 288 ГБ VRAM последнего поколения, общий объем VRAM которых составит 2,3 ТБ.
- 8 ускорителей AMD Instinct MI325 с 256 ГБ VRAM, которые стоят дешевле и обеспечивают 2 ТБ видеопамяти.
Оборудование для Qwen 2.5 72B:
- 8 графических ускорителей ускорителей AMD MI300X с 192 ГБ VRAM, общий объем которых составит 1,5 ТБ.
- 8 графических ускорителей Nvidia H200 NVL c 141 ГБ VRAM, в совокупности обеспечивающие 1 ТБ.
Сервер с большим объемом RAM
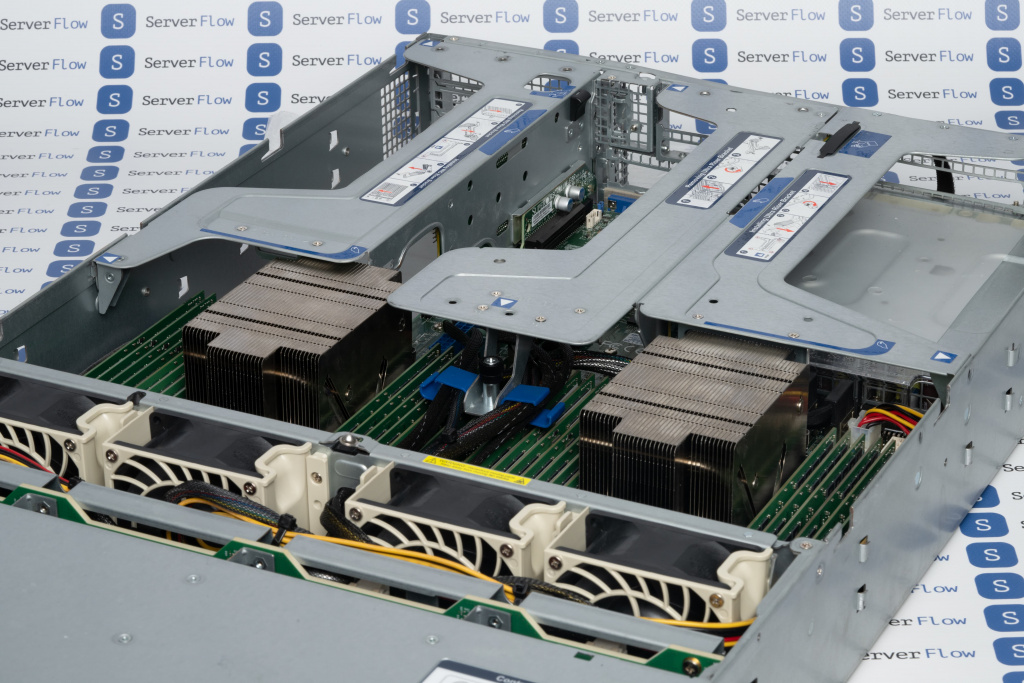
Однако существует гораздо более бюджетная, но и значительно менее эффективная альтернатива GPU-серверу — обычный сервер с большим количеством RAM. Для развертывания ИИ на сервере необходимо укомплектовать сервер несколькими терабайтами оперативной памяти (от 2 до 4 TБ). Однако, важно понимать, что обучение модели ИИ, развернутой на таком сервере, будет невозможно, а инференс нейросети будет кратно медленнее, чем при развертывании на ИИ-сервере. Единственная причина использовать такую систему для локального запуска DeepSeek R1 и Qwen 2.5 — экономия бюджета, поскольку интегрировать такой объем оперативной памяти можно практически в любой сервер, а сами модули памяти стоят гораздо дешевле мощных GPU.
Вывод
Достичь высокой производительности при развертывании ИИ без квантизации — это дорогое удовольствие даже для крупных IT-компаний. Однако, используя одну из больших китайских LLM, перечисленных в этой статье, ваш бизнес сможет перейти на совершенно новый этап развития. Автоматизация рутинных бизнес процессов, быстрое создание кода для корпоративных приложений, упрощение заполнения и составления документации — все это лишь малая часть всех операций, которые могут выполнять такие высокопроизводительные ИИ, как DeepSeek R1 и Qwen 2.5. Если вы хотите собрать сервер для развертывания этих передовых нейросетей в своей инфраструктуре, но не знаете, какие компоненты выбрать — обратитесь в компанию ServerFlow. Наши опытные специалисты смогут проконсультировать вас и подобрать оборудование, которое будет полностью соответствовать всем вашим запросам и требованиям.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год