


Гид по выбору GPU Nvidia — как не потеряться в каталоге в 2026

Введение
К 2026 году линейка графических ускорителей Nvidia для дата-центров сильно расширилась. GB200/GB300 NVL72, HGX B300, H200 NVL, L40S — эти названия звучат дорого, но что скрывается за каждым из них? Разобраться в обновленном каталоге становится все сложнее. Мы в ServerFlow изучили последние предложения Nvidia и подготовили это руководство, в котором структурировано объясним, какие решения лучше всего подходят для конкретных задач: от масштабного предобучения LLM до инференса и виртуализации рабочих мест.
Три стадии ИИ-нагрузок по версии Nvidia
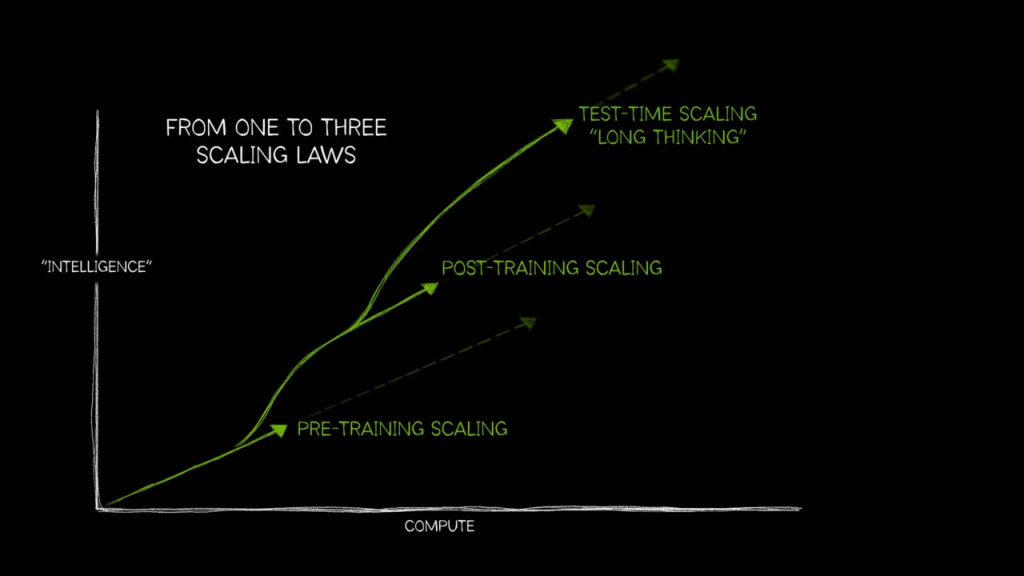
В основе структуры каталога Nvidia 2026 года лежит четкое разделение этапов жизненного цикла ИИ-моделей, каждый из которых требует уникального подхода и определенного вида ресурсов GPU:
- Pre-training scaling: Стадия первичного, масштабного обучения больших проприетарных языковых моделей (GPT, Gemini и т.д.). Требует экстремально высокой вычислительной мощности, огромных объемов сверхбыстрой памяти HBM и максимально плотной связности GPU через межсоединения NVLink для эффективного распределения модели.
- Post-training scaling: Этап дообучения, адаптации и тонкой настройки модели искусственного интеллекта под специфические задачи или датасеты. Здесь критически важна высокая производительность и хорошая масштабируемость, достаточный объем графической памяти и высокая пропускная способность NVLink, однако высокая связность GPU при этом не обязательна
- Test-time scaling: Фаза инференса — генерации ответов, прогнозов, изображений или видео, используя функцию размышления или без нее. Требует высокой пропускной способности, низкой задержки, эффективной работы с памятью и возможности эффективного масштабирования: от крупных кластеров до периферийных устройств.
Именно под эти три стадии и оптимизированы различные графические ускорители Nvidia.
Что предлагает Nvidia в 2026 году: краткий обзор линеек GPU
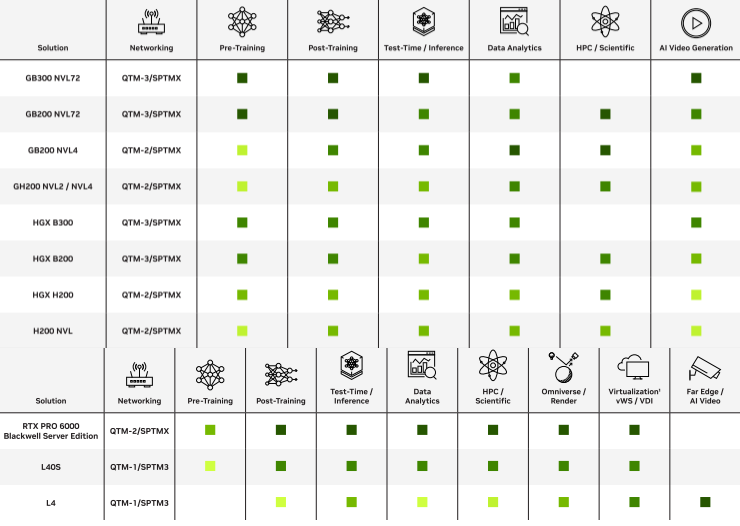
Nvidia группирует свои графические решения для дата-центров и коммерческих сред по производительности, возможностям масштабирования и типу выполняемых задач:
- GB200/GB300 NVL72: Абсолютный флагман для выполнения задач первичного обучения моделей искусственного интеллекта. Базируются на архитектуре Blackwell. Конфигурация NVL72 объединяет до 72 GPU в единую систему через сверхбыстрое соединение NVLink 5.0 и специализированную NVLink-коммутацию (NVL). Предназначен для обучения самых больших языковых моделей с триллионами параметров, развертывание которых возможно только в облачных средах
- HGX B200/B300/H200: Универсальные HGX (Hyper-GPU-eXpansion) платформы на базе Blackwell (B200/B300) и Hopper (H200). Оснащены сверхбыстрой памятью HBM и масштабируются через межсоединение NVLink (обычно до 4-8 GPU на один сервер). Оптимизированы для задач дообучения ИИ-моделей и высокопроизводительного инференса. Эти решения обеспечивают баланс между производительностью, объемом памяти и возможностями масштабирования.
- H200 NVL/NVL4: Специализированные конфигурации для инференса искусственного интеллекта с графическими ускорителями на базе архитектуры Hooper. Используют NVLink-коммутаторы для создания плотных связей между GPU. NVL4 представляют собой не менее компактные, но более мощные решения, объединяющие 2 или 4 GPU в единой системе, обеспечивая идеальную конфигурацию для локального развертывания генеративных ИИ-моделей, видеоинференса, работы с рассуждающими LLM, при этом сохраняя максимально низкую задержку.
- L40S/RTX 6000 Blackwell SE: Лидеры в сфере виртуализации графических ресурсов (vGPU), работы с платформой Omniverse и виртуализации рабочих мест. Ускорители L40S на базе архитектуры Ada Lovelace остаются актуальным решением для ИИ-задач за счет наличия 48 ГБ памяти GDDR6, а RTX 6000 Blackwell Special Edition предлагает использование новой архитектуры Blackwell для выполнения графических, мультимедийных и ИИ-нагрузок в ЦОД.
- L4: Компактный, энергоэффективный ускоритель для периферийных вычислений. Оптимален для задач видеоаналитики с использованием ИИ, компактных серверов для инференса и развертывания легковесных нейросетей в небольшом корпусе с низким энергопотреблением.
Как выбрать GPU под конкретную задачу
Для того, чтобы создать эффективную и при этом экономичную вычислительную инфраструктуру, вам жизненно необходимо правильно выбрать графический ускоритель под конкретный тип задач, будь то обучение/инференс ИИ, видеоаналитика или работа с мультимедиа. Чтобы помочь вам с выбором, предлагаем ознакомиться с удобной табличкой графических решений компании Nvidia и задачами, под выполнение которых они оптимизированы.
|
Задача |
Рекомендованные GPU Nvidia |
Пояснение |
|
Обучение LLM (100B+ параметров) |
GB200 / GB300 NVL72 |
Максимум вычислительной мощности, памяти HBM и плотности NVLink для больших языковых моделей. |
|
Дообучение / Адаптация / Настройка моделей |
HGX B200 / HGX B300 / HGX H200 |
Отличный баланс производительности, памяти и масштабируемости через NVLink. |
|
Инференс больших языковых моделей |
H200 NVL / L40S |
H200 NVL: Высокая пропускная способность при плотной связности через NVL. L40S: Эффективность для многих задач инференса. |
|
Потоковое видео / Задачи с размышлением |
L40S / L4 |
L40S: Производительность для видеообработки и инференса размышляющих LLM. L4: Энергоэффективность для потокового видео в периферийных системах. |
|
Виртуализация, Графика, Omniverse |
RTX 6000 Blackwell SE / L40S |
Специализированные драйверы и технологичный стек (vGPU) для графических и виртуализированных сред. |
|
IoT, Компактные системы |
L4 |
Низкое энергопотребление, малый форм-фактор, высокая мощность для периферийного инференса. |
Почему сетевые фабрики и DPU — неотъемлемая часть производительности
Производительность современной ИИ-инфраструктуры определяется не только мощностью графических ускорителей, но и скоростью их взаимодействия. Nvidia решает эту проблему комплексно:
- Скорость межузловой связи: Для самых требовательных задач предобучения и дообучения критически важно использование интерконнекта InfiniBand с применением коммутаторов Quantum-2/Quantum-3. Они обеспечивают минимальные задержки и максимальную пропускную способность. Для более гибких или смешанных сред предлагаются высокопроизводительные Ethernet-коммутаторы Spectrum-3/4.
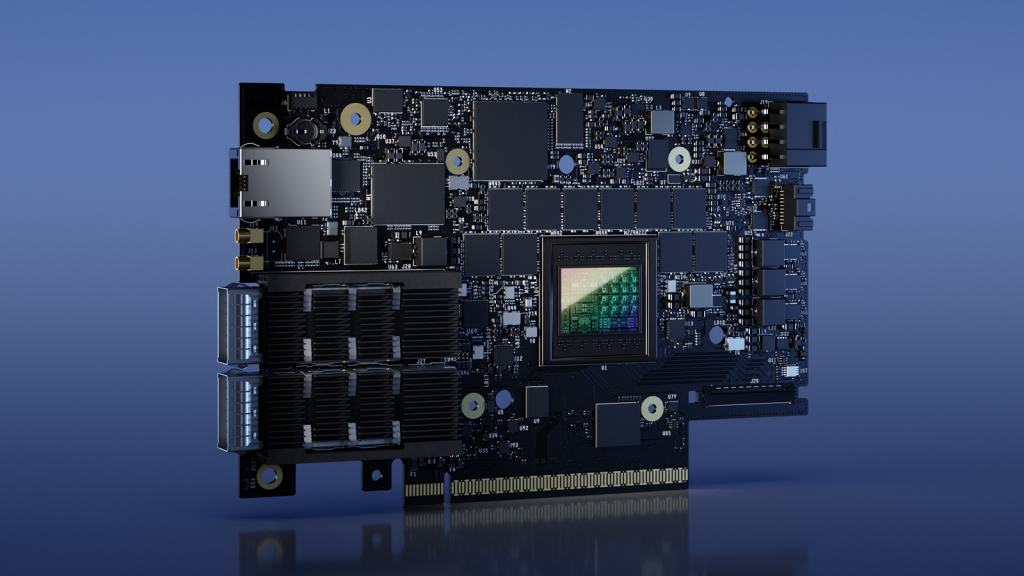
- Разгрузка и ускорение ввода-вывода: BlueField DPU — это специализированные сопроцессоры, разгружающие центральный процессор за счет выполнения таких задач, как обработка сетевого стека, хранения данных, обеспечения безопасности и управления виртуальными машинами. Это особенно важно в мультитенантных или мультисессионных средах, например, VDI или ИИ-кластерах для инференса языковых моделей, где DPU высвобождают ресурсы CPU для более прикладных задач и значительно ускоряя операции ввода-вывода.
Без мощной сетевой инфраструктуры и использования DPU даже самый быстрый GPU не сможет раскрыть свой потенциал в масштабируемой ИИ-инфраструктуре.
Выводы
Линейка графических ускорителей Nvidia в 2026 году впечатляет своим размахом, охватывая весь спектр задач: от крошечных периферийных устройств до гигантских ИИ-кластеров с тысячами GPU, предназначенных для обучения самых передовых LLM. Однако это разнообразие требует осознанного и ответственного выбора. Ключевой принцип при выборе ускорителя: GPU определяется фазой ИИ-нагрузки (pre-training, post-training, test-time) и наличием нужных ресурсов, которые критически важны для той или иной нагрузки.
Рекомендуемые товары

- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00003249
Нет в наличии
Видеокарта AMD Radeon Instinct MI50 32GB HBM2 [100-506194] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
29 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: SF-00001431
Нет в наличии
Видеокарта NVIDIA A100 OEM 40GB HBM2 [900-21001-0000-000] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
529 800 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 285
Нет в наличии
SSD-накопитель Intel (HP) S3700 400GB 2.5" 6Gb/s [SSDSC2BA400G3P] [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
13 100 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 1350
Нет в наличии
HBA адаптер Broadcom 9500-16i (NVMe/SAS/SATA 12GB/s, no cache) [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
53 900 ₽
- Цена включает НДС 7%
- Гарантия: 1 год
- Новое
- Выгодно
- Под заказ
- Б/У
Артикул: 5136
Нет в наличии
Кабель Supermicro SFF8643 (NVMe) - SFF8643 (NVMe) 0.7м [Новый]
- Сокет AM4
- Сокет AM4
- Сокет AM4
- Сокет AM4
3 000 ₽
- Цена включает НДС 7%
- Гарантия: 1 год